
面渣-并发编程
基础
你是如何理解线程安全的?
推荐阅读:多线程带来了哪些问题?
如果一段代码块或者一个方法被多个线程同时执行,还能够正确地处理共享数据,那么这段代码块或者这个方法就是线程安全的。
可以从三个要素来确保线程安全:
①、原子性:一个操作要么完全执行,要么完全不执行,不会出现中间状态。
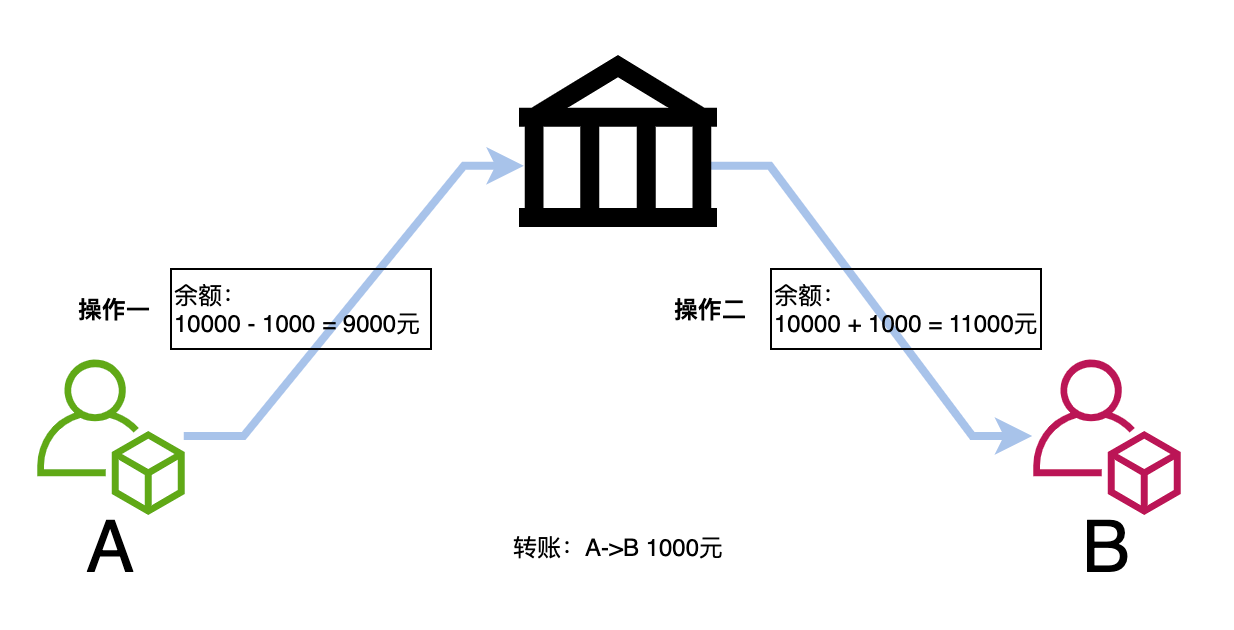
可以通过同步关键字 synchronized 或原子操作,如 AtomicInteger 来保证原子性。
AtomicInteger count = new AtomicInteger(0);
count.incrementAndGet(); // 原子操作②、可见性:当一个线程修改了共享变量,其他线程能够立即看到变化。
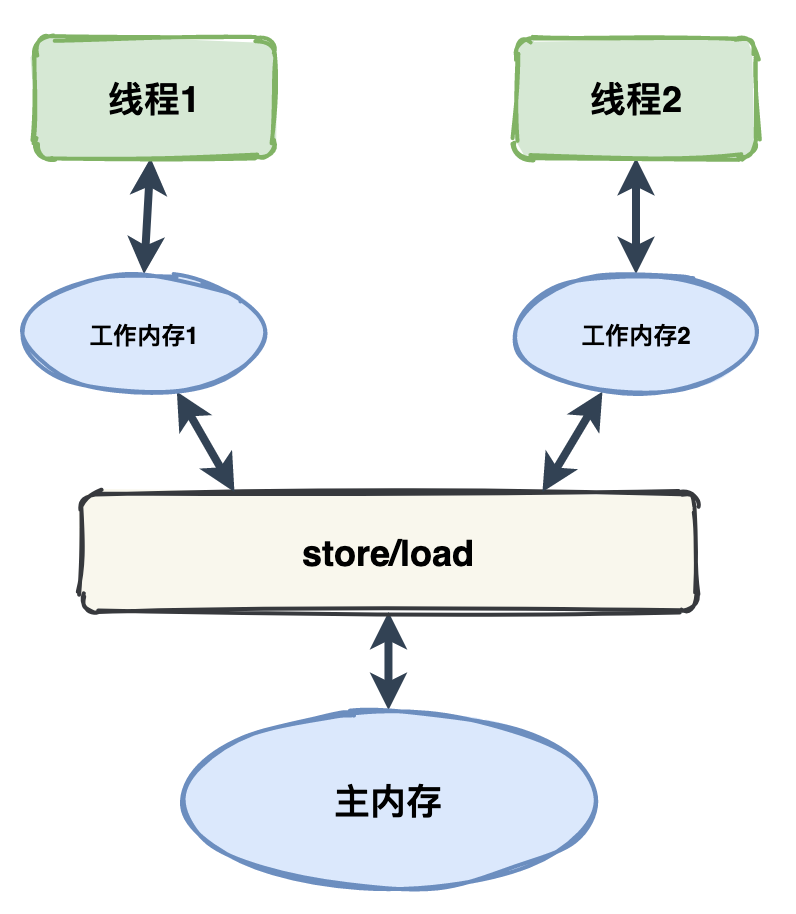
可以通过 volatile 关键字来保证可见性。
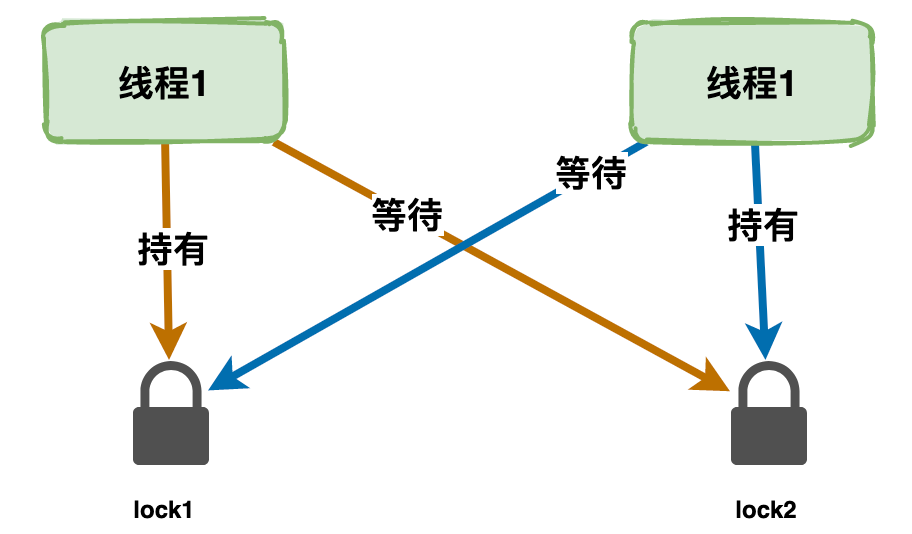
private volatile String itwanger = "沉默王二";③、有序性:要确保线程不会因为死锁、饥饿、活锁等问题导致无法继续执行。
- Java 面试指南(付费)收录的华为 OD 面经同学 1 一面面试原题:对于多线程编程的了解?
- Java 面试指南(付费)收录的快手面经同学 1 部门主站技术部面试原题:你对线程安全的理解是什么?
memo:2025 年 1 月 22 日修改至此。
🌟2.说说进程和线程的区别?
推荐阅读:进程与线程的区别是什么?
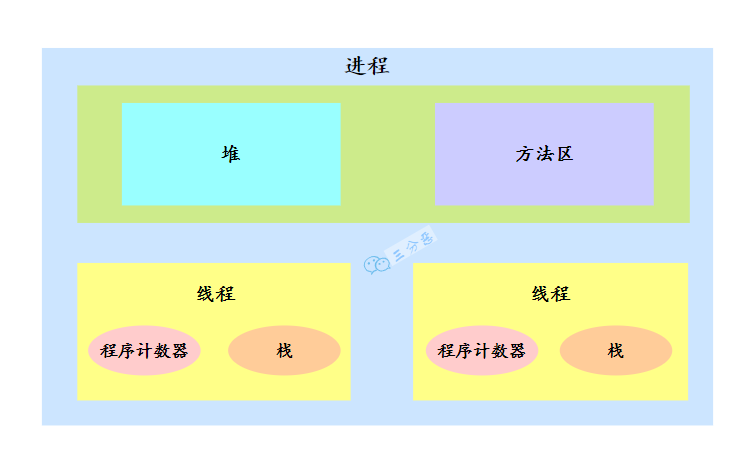
进程说简单点就是我们在电脑上启动的一个个应用。它是操作系统分配资源的最小单位。
线程是进程中的独立执行单元。多个线程可以共享同一个进程的资源,如内存;每个线程都有自己独立的栈和寄存器。
如何理解协程?
fun main() = runBlocking {
    launch {
        delay(1000L)
        println("World!")
    }
    println("Hello,")
}线程间是如何进行通信的?
原则上可以通过消息传递和共享内存两种方法来实现。Java 采用的是共享内存的并发模型。
这个模型被称为 Java 内存模型,简写为 JMM,它决定了一个线程对共享变量的写入,何时对另外一个线程可见。当然了,本地内存是 JMM 的一个抽象概念,并不真实存在。
用一句话来概括就是:共享变量存储在主内存中,每个线程的私有本地内存,存储的是这个共享变量的副本。
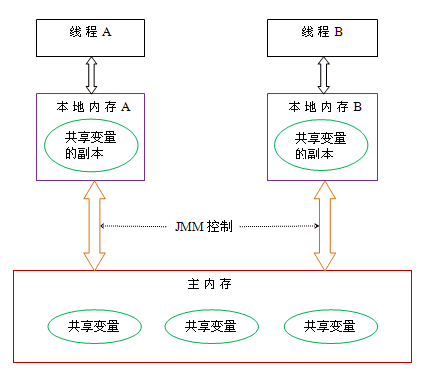
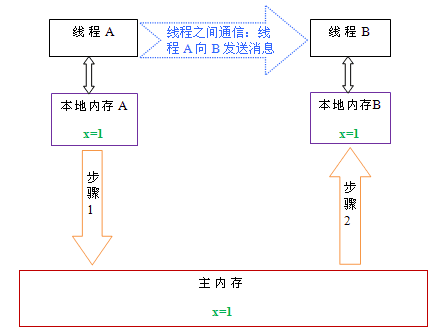
线程 A 与线程 B 之间如要通信,需要要经历 2 个步骤:
- 线程 A 把本地内存 A 中的共享变量副本刷新到主内存中。
- 线程 B 到主内存中读取线程 A 刷新过的共享变量,再同步到自己的共享变量副本中。
memo:2025 年 1 月 23 日修改至此。
🌟3.说说线程有几种创建方式?
有三种,分别是继承 Thread 类、实现 Runnable 接口、实现 Callable 接口。
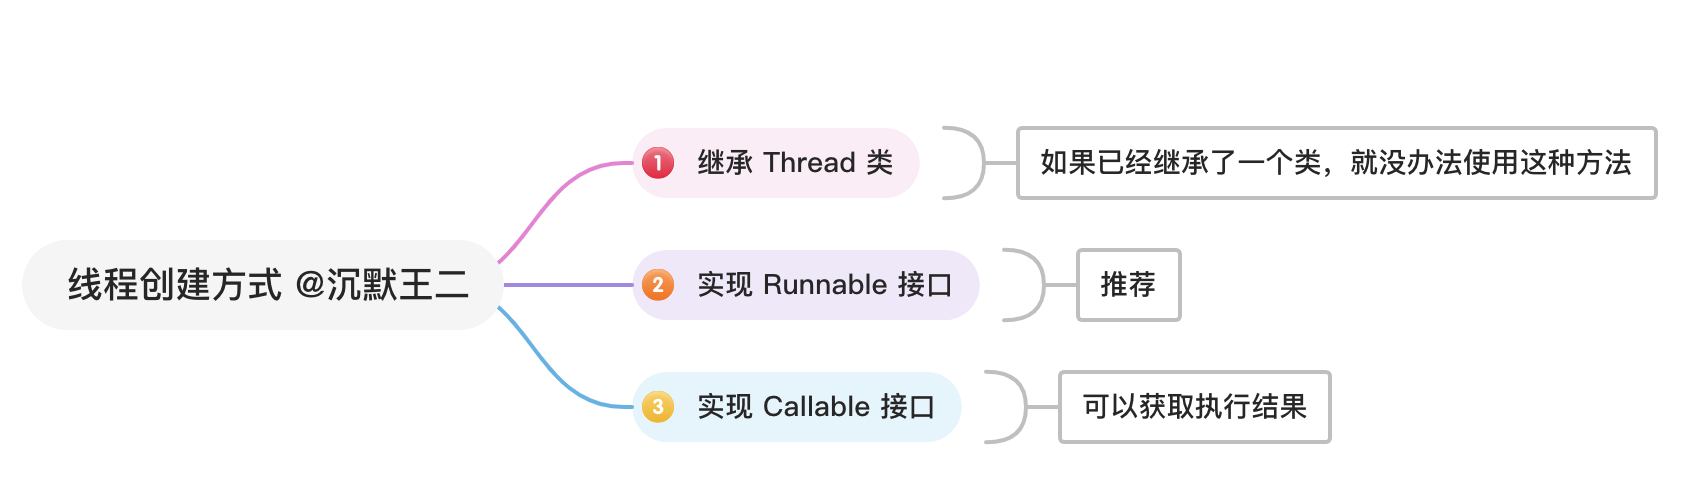
第一种需要重写父类 Thread 的 run() 方法,并且调用 start() 方法启动线程。
class ThreadTask extends Thread {
    public void run() {
        System.out.println("看完二哥的 Java 进阶之路,上岸了!");
    }

    public static void main(String[] args) {
        ThreadTask task = new ThreadTask();
        task.start();
    }
}这种方法的缺点是,如果 ThreadTask 已经继承了另外一个类,就不能再继承 Thread 类了,因为 Java 不支持多重继承。
第二种需要重写 Runnable 接口的 run() 方法,并将实现类的对象作为参数传递给 Thread 对象的构造方法,最后调用 start() 方法启动线程。
class RunnableTask implements Runnable {
    public void run() {
        System.out.println("看完二哥的 Java 进阶之路,上岸了!");
    }

    public static void main(String[] args) {
        RunnableTask task = new RunnableTask();
        Thread thread = new Thread(task);
        thread.start();
    }
}这种方法的优点是可以避免 Java 的单继承限制,并且更符合面向对象的编程思想,因为 Runnable 接口将任务代码和线程控制的代码解耦了。
第三种需要重写 Callable 接口的 call() 方法,然后创建 FutureTask 对象,参数为 Callable 实现类的对象;紧接着创建 Thread 对象,参数为 FutureTask 对象,最后调用 start() 方法启动线程。
class CallableTask implements Callable<String> {
    public String call() {
        return "看完二哥的 Java 进阶之路,上岸了!";
    }

    public static void main(String[] args) throws ExecutionException, InterruptedException {
        CallableTask task = new CallableTask();
        FutureTask<String> futureTask = new FutureTask<>(task);
        Thread thread = new Thread(futureTask);
        thread.start();
        System.out.println(futureTask.get());
    }
}这种方法的优点是可以获取线程的执行结果。
tttt 一个 8G 内存的系统最多能创建多少个线程?
推荐阅读:深入理解 JVM 的运行时数据区
理论上大约 8000 个。
创建线程的时候,至少需要分配一个虚拟机栈,在 64 位操作系统中,默认大小为 1M,因此一个线程大约需要 1M 的内存。
但 JVM、操作系统本身的运行就要占一定的内存空间,所以实际上可以创建的线程数远比 8000 少。
详细解释一下。
可以通过 java -XX:+PrintFlagsFinal -version | grep ThreadStackSize 命令查看 JVM 栈的默认大小。
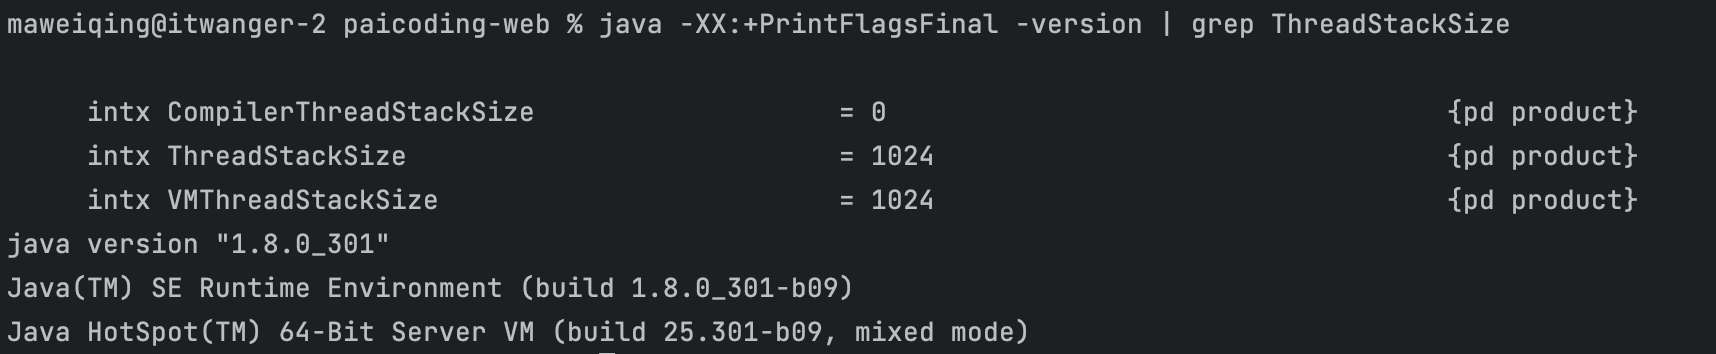
其中 ThreadStackSize 的单位是字节,也就是说默认的 JVM 栈大小是 1024 KB,也就是 1M。
启动一个 Java 程序,你能说说里面有哪些线程吗?
首先是 main 线程,这是程序执行的入口。
然后是垃圾回收线程,它是一个后台线程,负责回收不再使用的对象。
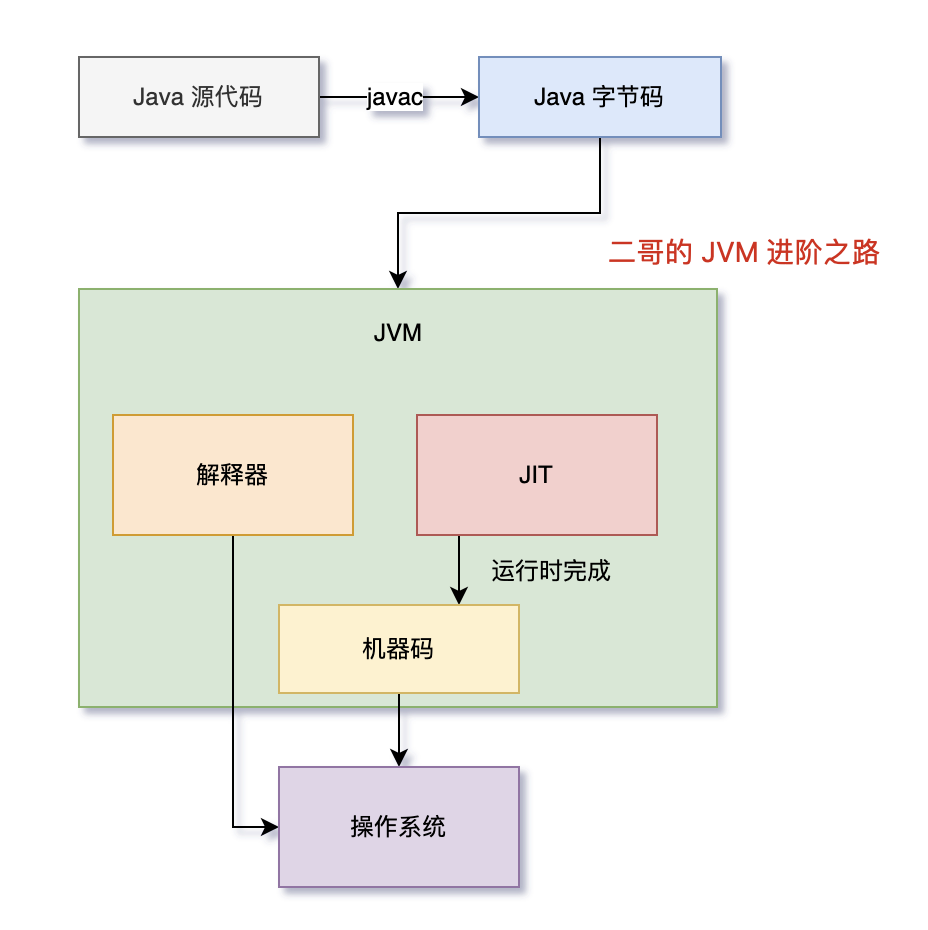
还有编译器线程,比如 JIT,负责把一部分热点代码编译后放到 codeCache 中。
4.调用 start 方法时会执行 run 方法,那怎么不直接调用 run 方法?
调用 start() 会创建一个新的线程,并异步执行 run() 方法中的代码。
直接调用 run() 方法只是一个普通的同步方法调用,所有代码都在当前线程中执行,不会创建新线程。没有新的线程创建,也就达不到多线程并发的目的。
通过敲代码体验一下。
class MyThread extends Thread {
    public void run() {
        System.out.println(Thread.currentThread().getName());
    }

    public static void main(String[] args) {
        MyThread t1 = new MyThread();
        t1.start(); // 正确的方式,创建一个新线程,并在新线程中执行 run()
        t1.run(); // 仅在主线程中执行 run(),没有创建新线程
    }
}来看输出结果:
main
Thread-0也就是说,调用 start() 方法会通知 JVM,去调用底层的线程调度机制来启动新线程。
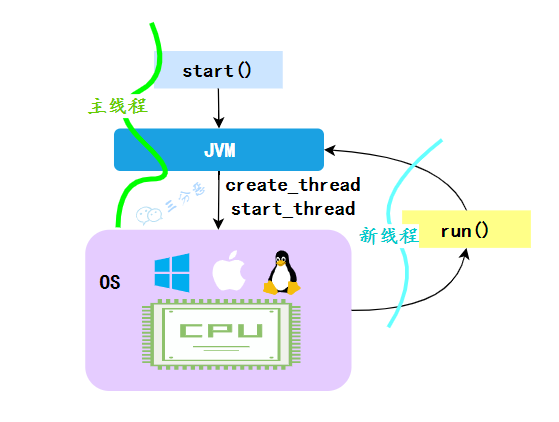
调用 start() 后,线程进入就绪状态,等待操作系统调度;一旦调度执行,线程会执行其 run() 方法中的代码。
memo:2025 年 1 月 26 日修改至此。
5.线程有哪些常用的调度方法?
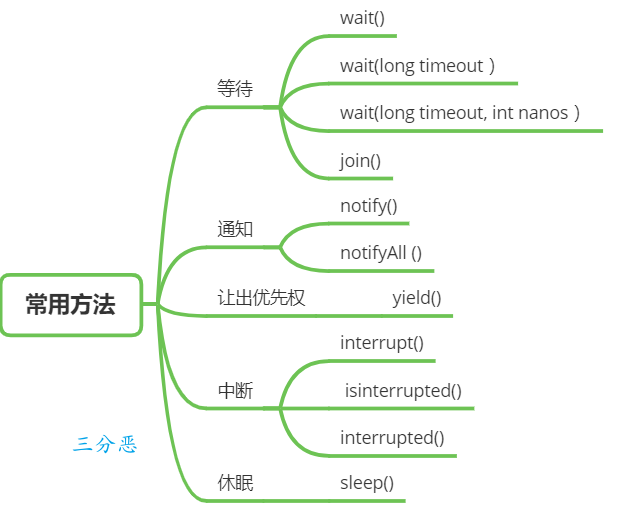
比如说 start 方法用于启动线程并让操作系统调度执行;sleep 方法用于让当前线程休眠一段时间;wait 方法会让当前线程等待,notify 会唤醒一个等待的线程。
说说 wait 方法和 notify 方法?
当线程 A 调用共享对象的 wait() 方法时,线程 A 会被阻塞挂起,直到:
- 线程 B 调用了共享对象的
notify()方法或者notifyAll()方法; - 其他线程调用线程 A 的
interrupt()方法,导致线程 A 抛出 InterruptedException 异常。
线程 A 调用共享对象的 wait(timeout)方法后,没有在指定的 timeout 时间内被其它线程唤醒,那么这个方法会因为超时而返回。
当线程 A 调用共享对象的 notify() 方法后,会唤醒一个在这个共享对象上调用 wait 系列方法被挂起的线程。
共享对象上可能会有多个线程在等待,具体唤醒哪个线程是随机的。
如果调用的是 notifyAll 方法,会唤醒所有在这个共享变量上调用 wait 系列方法而被挂起的线程。
说说 sleep 方法?
当线程 A 调用了 Thread 的 sleep 方法后,线程 A 会暂时让出指定时间的执行权。
指定的睡眠时间到了后该方法会正常返回,接着参与 CPU 调度,获取到 CPU 资源后可以继续执行。
说说 yield 方法?
yield() 方法的目的是让当前线程让出 CPU 使用权,回到就绪状态。但是线程调度器可能会忽略。
说说 interrupt 方法?
推荐阅读:interrupt 方法
interrupt() 方法用于通知线程停止,但不会直接终止线程,需要线程自行处理中断标志。
常与 isInterrupted() 或 Thread.interrupted() 配合使用。
Thread thread = new Thread(() -> {
    while (!Thread.currentThread().isInterrupted()) {
        System.out.println("Running");
    }
    System.out.println("Interrupted");
});
thread.start();
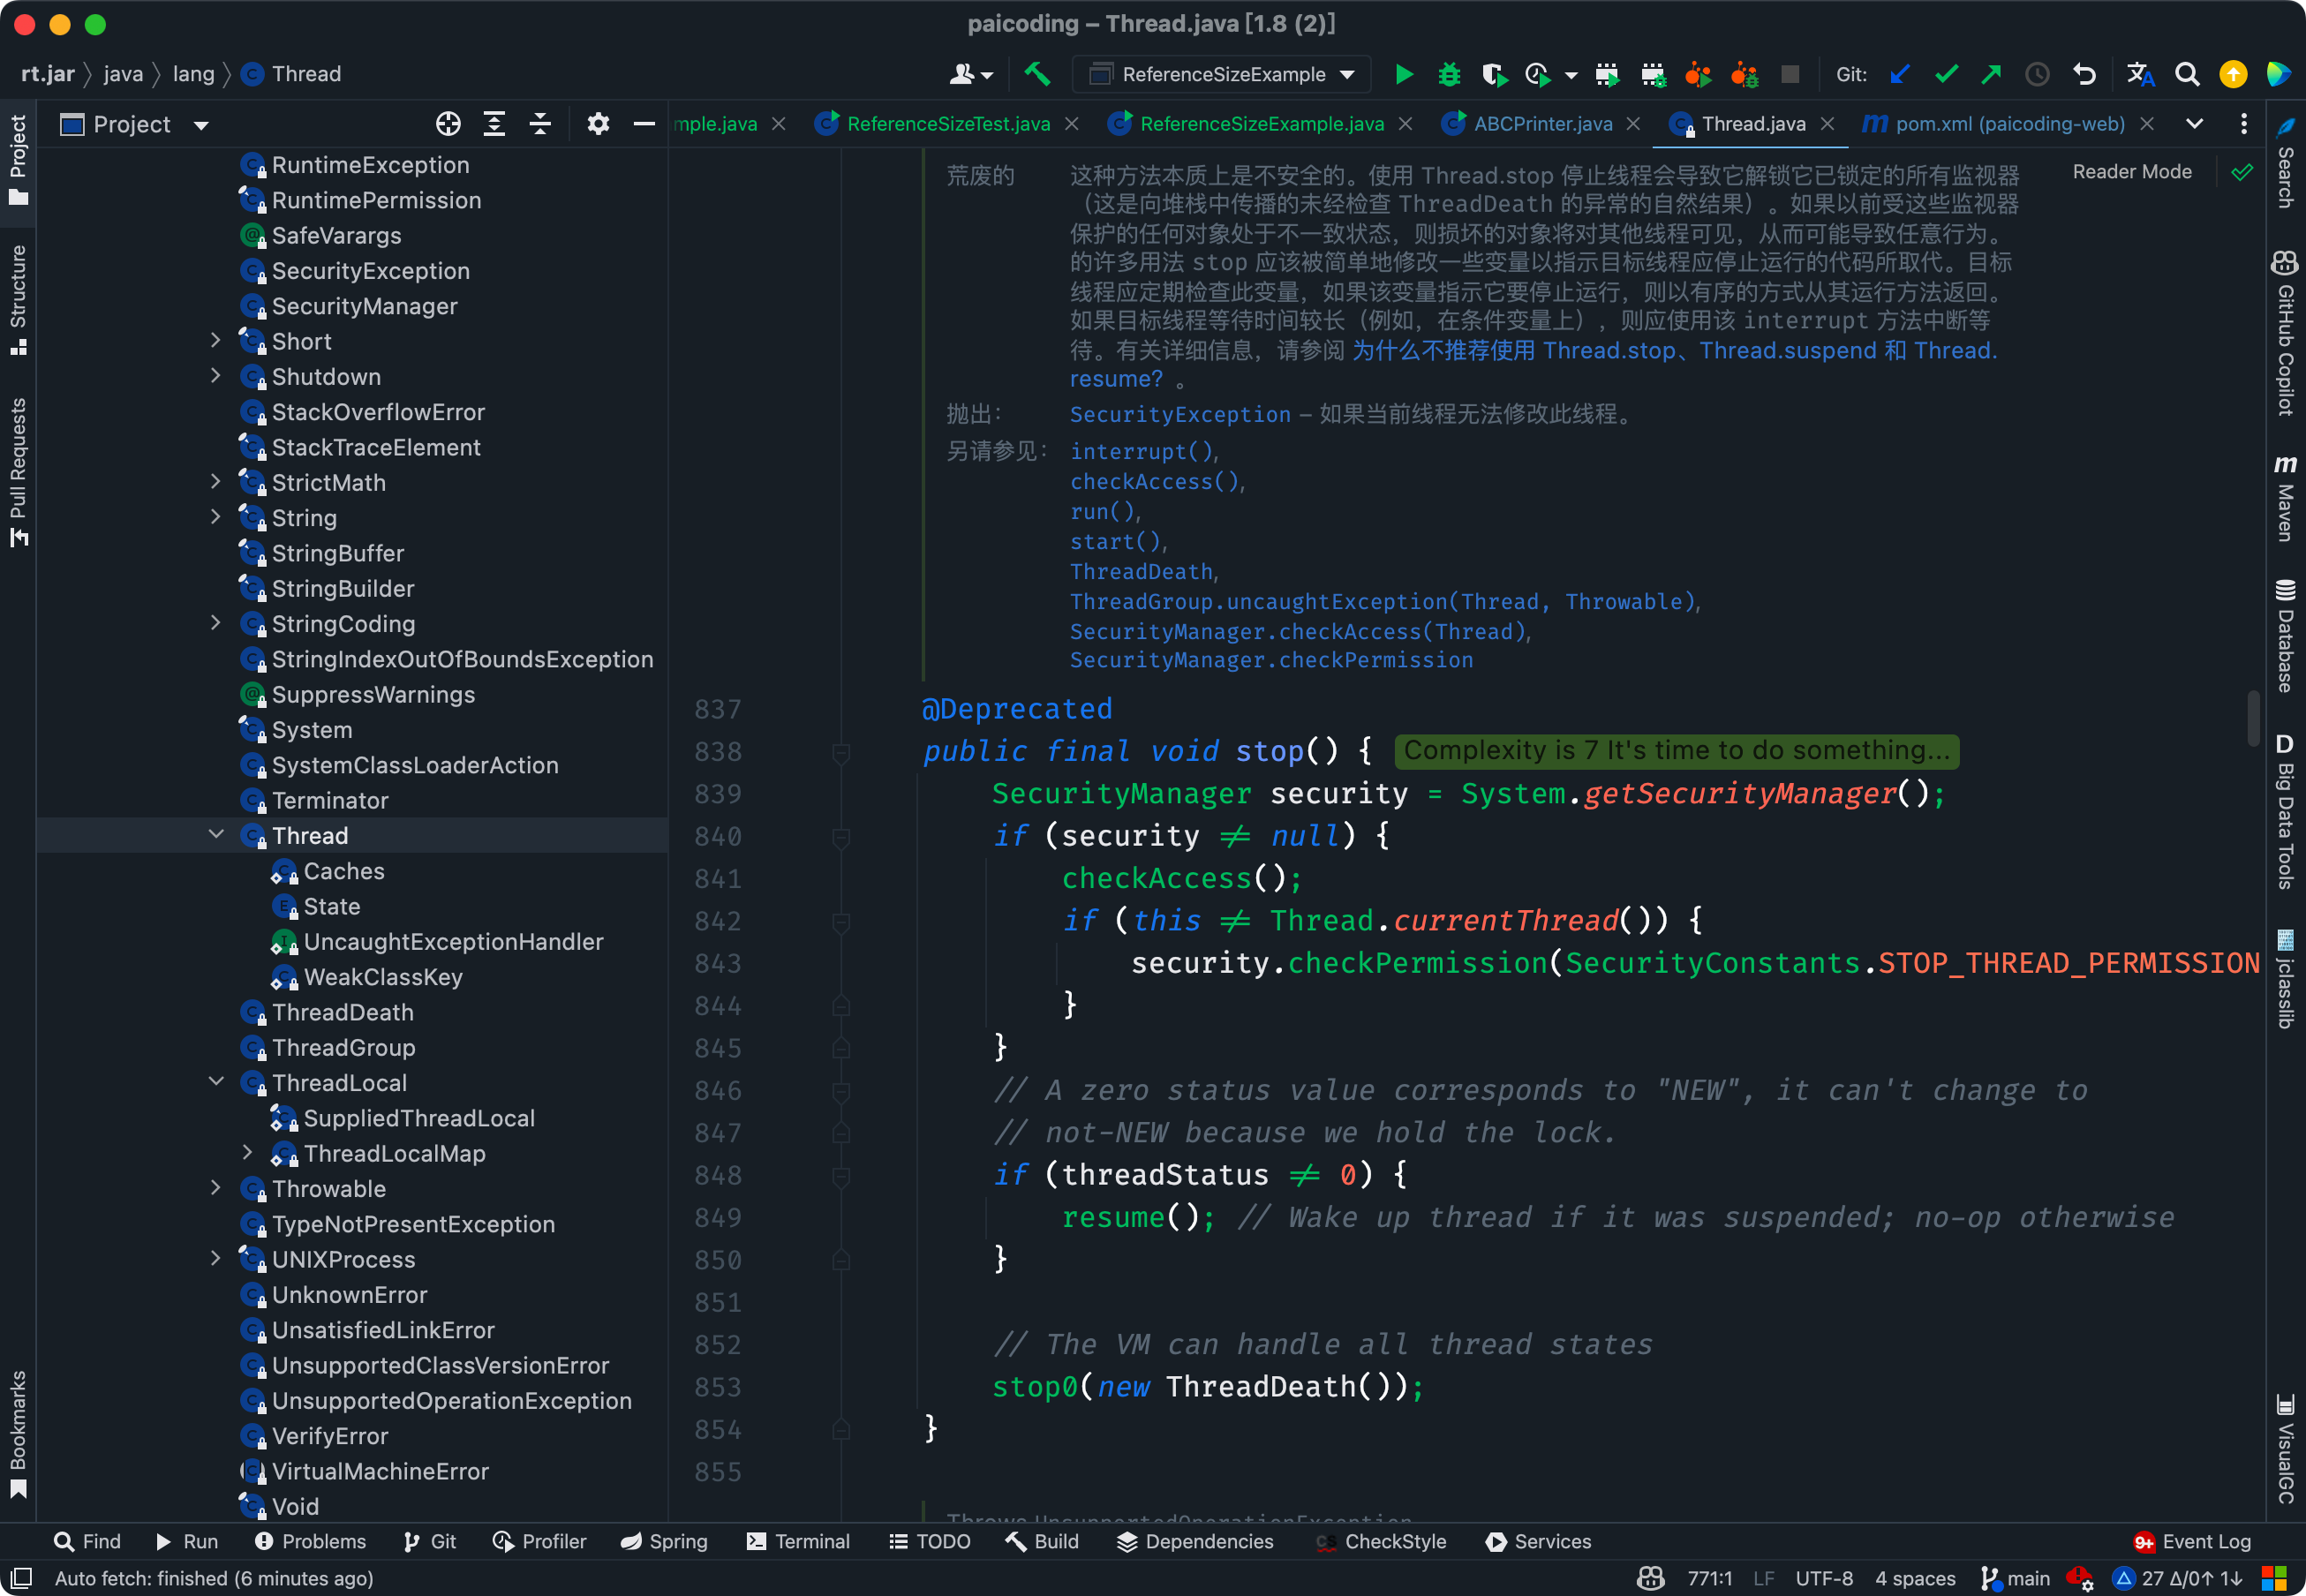
thread.interrupt(); // 中断线程说说 stop 方法?
memo:2025 年 1 月 27 日修改至此。
6.线程有几种状态?
6 种。
new 代表线程被创建但未启动;runnable 代表线程处于就绪或正在运行状态,由操作系统调度;blocked 代表线程被阻塞,等待获取锁;waiting 代表线程等待其他线程的通知或中断;timed_waiting 代表线程会等待一段时间,超时后自动恢复;terminated 代表线程执行完毕,生命周期结束。

也就是说,线程的生命周期可以分为五个主要阶段:新建、就绪、运行、阻塞和终止。线程在运行过程中会根据状态的变化在这些阶段之间切换。
class ThreadStateExample {
    public static void main(String[] args) throws InterruptedException {
        Thread thread = new Thread(() -> {
            try {
                Thread.sleep(2000); // TIMED_WAITING
                synchronized (ThreadStateExample.class) {
                    ThreadStateExample.class.wait(); // WAITING
                }
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        System.out.println("State after creation: " + thread.getState()); // NEW

        thread.start();
        System.out.println("State after start: " + thread.getState()); // RUNNABLE

        Thread.sleep(500);
        System.out.println("State while sleeping: " + thread.getState()); // TIMED_WAITING

        synchronized (ThreadStateExample.class) {
            ThreadStateExample.class.notify(); // 唤醒线程
        }

        thread.join();
        System.out.println("State after termination: " + thread.getState()); // TERMINATED
    }
}如何强制终止线程?
第一步,调用线程的 interrupt() 方法,请求终止线程。
第二步,在线程的 run() 方法中检查中断状态,如果线程被中断,就退出线程。
class MyTask implements Runnable {
    @Override
    public void run() {
        while (!Thread.currentThread().isInterrupted()) {
            try {
                System.out.println("Running...");
                Thread.sleep(1000); // 模拟工作
            } catch (InterruptedException e) {
                // 捕获中断异常后,重置中断状态
                Thread.currentThread().interrupt();
                System.out.println("Thread interrupted, exiting...");
                break;
            }
        }
    }
}

public class Main {
    public static void main(String[] args) throws InterruptedException {
        Thread thread = new Thread(new MyTask());
        thread.start();
        Thread.sleep(3000); // 主线程等待3秒
        thread.interrupt(); // 请求终止线程
    }
}中断结果:
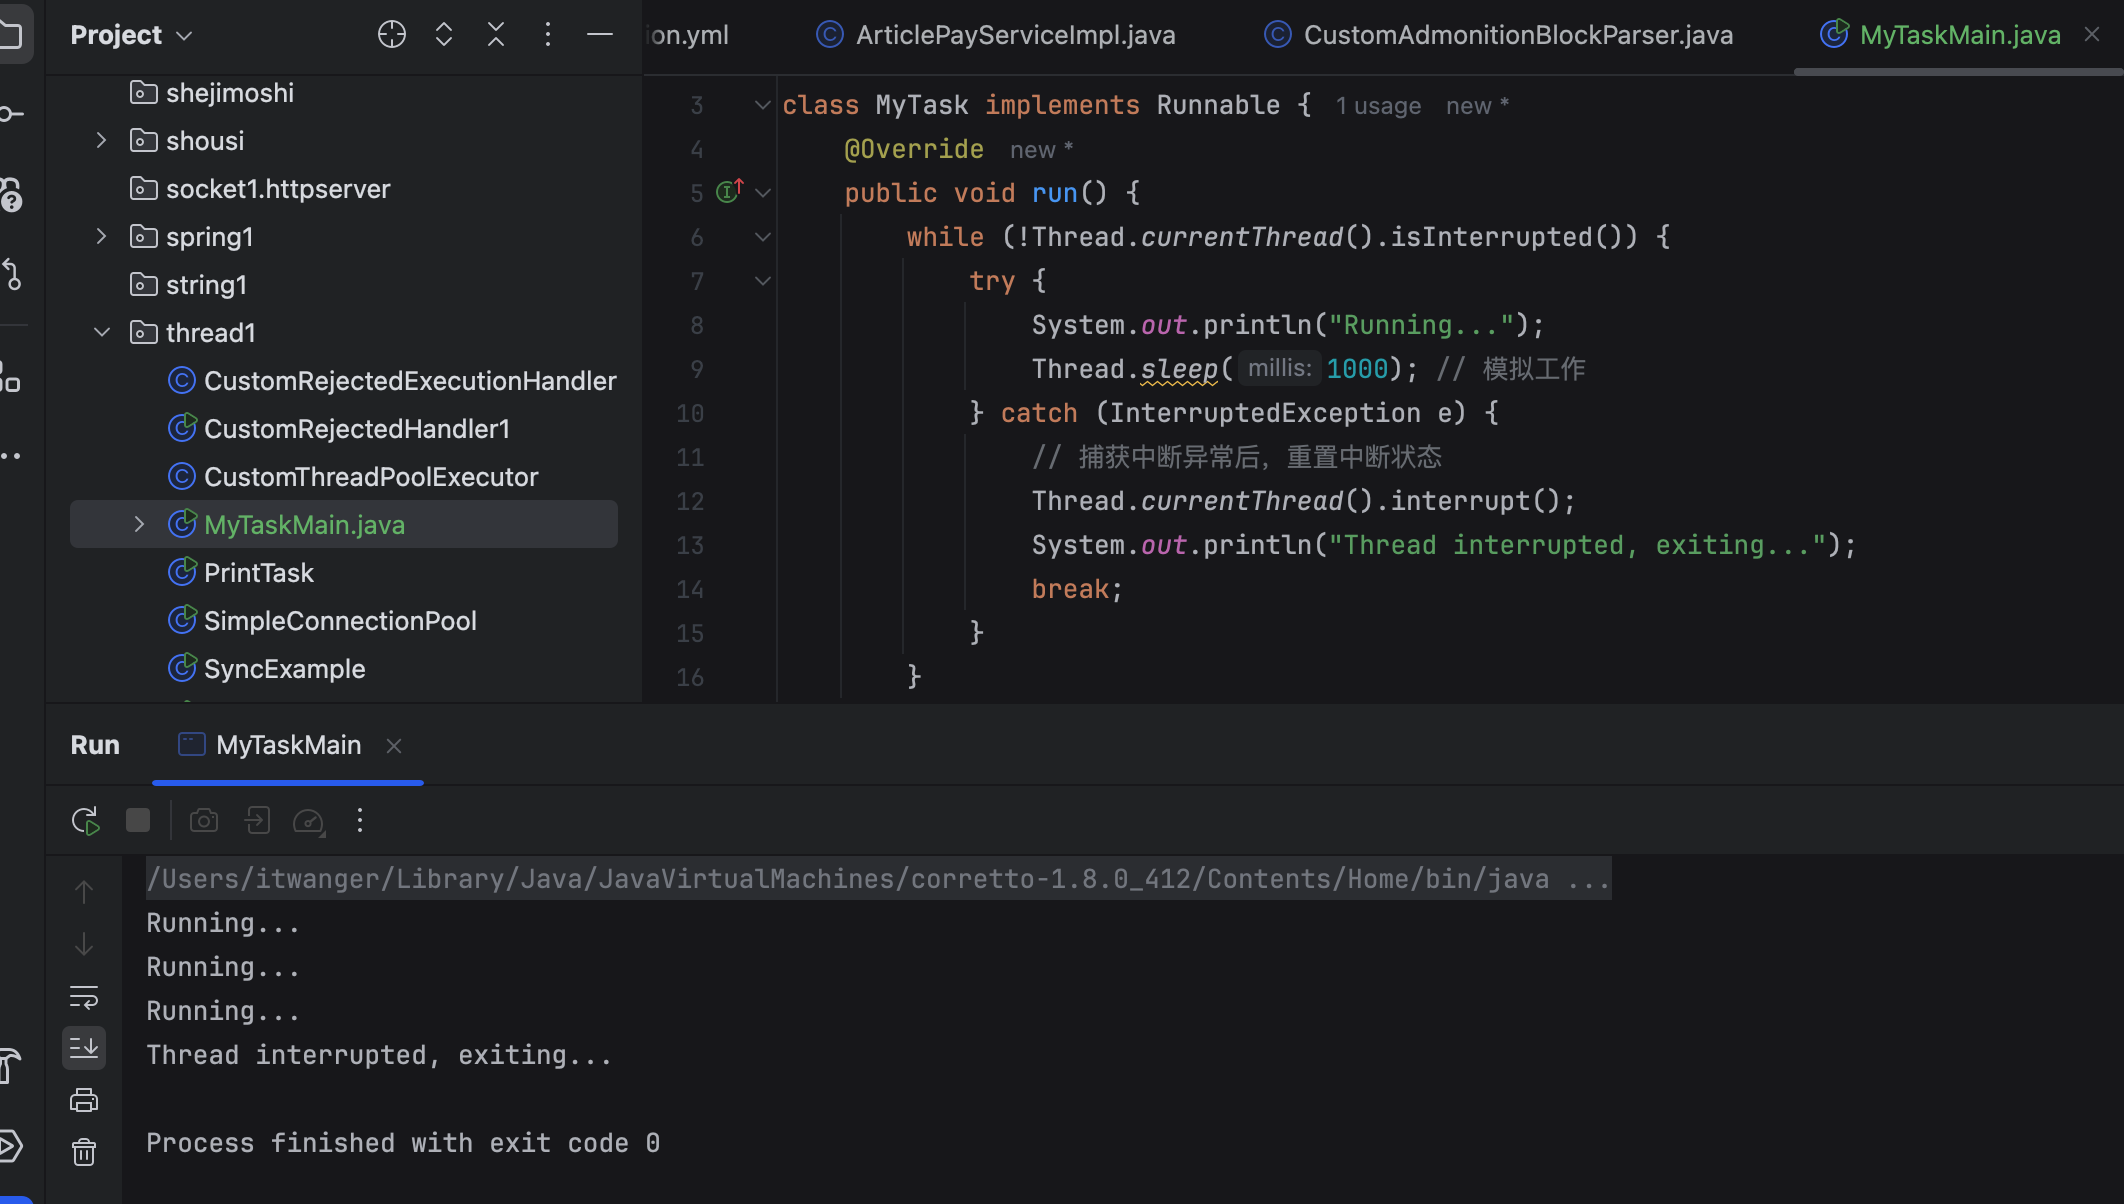
7.什么是线程上下文切换?
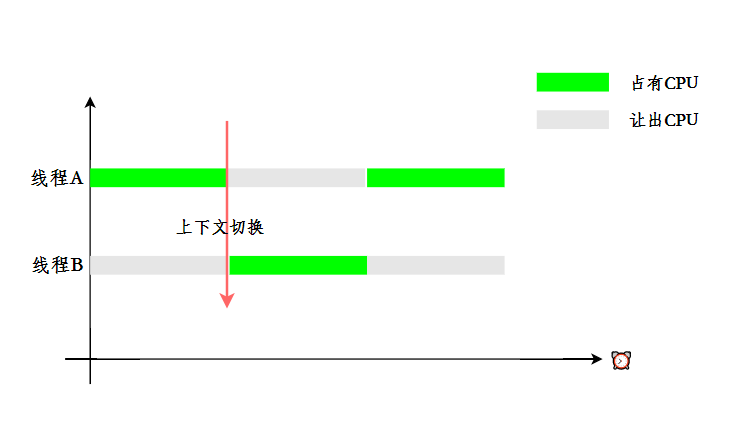
线程上下文切换是指 CPU 从一个线程切换到另一个线程执行时的过程。
在线程切换的过程中,CPU 需要保存当前线程的执行状态,并加载下一个线程的上下文。
之所以要这样,是因为 CPU 在同一时刻只能执行一个线程,为了实现多线程并发执行,需要不断地在多个线程之间切换。
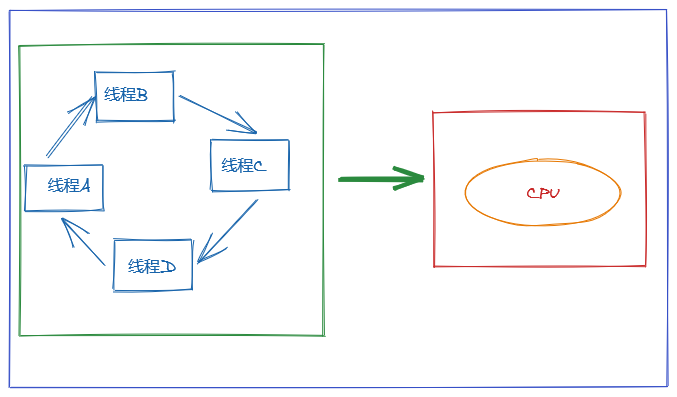
为了让用户感觉多个线程是在同时执行的, CPU 资源的分配采用了时间片轮转的方式,线程在时间片内占用 CPU 执行任务。当线程使用完时间片后,就会让出 CPU 让其他线程占用。
线程可以被多核调度吗?
8.守护线程了解吗?
了解,守护线程是一种特殊的线程,它的作用是为其他线程提供服务。
Java 中的线程分为两类,一种是守护线程,另外一种是用户线程。
JVM 启动时会调用 main 方法,main 方法所在的线程就是一个用户线程。在 JVM 内部,同时还启动了很多守护线程,比如垃圾回收线程。
守护线程和用户线程有什么区别呢?
区别之一是当最后一个非守护线程束时, JVM 会正常退出,不管当前是否存在守护线程,也就是说守护线程是否结束并不影响 JVM 退出。
换而言之,只要有一个用户线程还没结束,正常情况下 JVM 就不会退出。
9.线程间有哪些通信方式?
线程之间传递信息的方式有多种,比如说使用 volatile 和 synchronized 关键字共享对象、使用 wait() 和 notify() 方法实现生产者-消费者模式、使用 Exchanger 进行数据交换、使用 Condition 实现线程间的协调等。
简单说说 volatile 和 synchronized 的使用方式?
class SharedObject {
    private String message;
    private boolean hasMessage = false;

    public synchronized void writeMessage(String message) {
        while (hasMessage) {
            try {
                wait();
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
        this.message = message;
        hasMessage = true;
        notifyAll();
    }

    public synchronized String readMessage() {
        while (!hasMessage) {
            try {
                wait();
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
        hasMessage = false;
        notifyAll();
        return message;
    }
}

public class Main {
    public static void main(String[] args) {
        SharedObject sharedObject = new SharedObject();

        Thread writer = new Thread(() -> {
            sharedObject.writeMessage("Hello from Writer!");
        });

        Thread reader = new Thread(() -> {
            String message = sharedObject.readMessage();
            System.out.println("Reader received: " + message);
        });

        writer.start();
        reader.start();
    }
}wait() 和 notify() 方法的使用方式了解吗?
一个线程调用共享对象的 wait() 方法时,它会进入该对象的等待池,释放已经持有的锁,进入等待状态。
一个线程调用 notify() 方法时,它会唤醒在该对象等待池中等待的一个线程,使其进入锁池,等待获取锁。
class MessageBox {
    private String message;
    private boolean empty = true;

    public synchronized void produce(String message) {
        while (!empty) {
            try {
                wait();
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
        empty = false;
        this.message = message;
        notifyAll();
    }

    public synchronized String consume() {
        while (empty) {
            try {
                wait();
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
        empty = true;
        notifyAll();
        return message;
    }
}

public class Main {
    public static void main(String[] args) {
        MessageBox box = new MessageBox();

        Thread producer = new Thread(() -> {
            box.produce("Message from producer");
        });

        Thread consumer = new Thread(() -> {
            String message = box.consume();
            System.out.println("Consumer received: " + message);
        });

        producer.start();
        consumer.start();
    }
}Condition 也提供了类似的方法,await() 负责阻塞、signal() 和 signalAll() 负责通知。
通常与锁 ReentrantLock 一起使用,为线程提供了一种等待某个条件成真的机制,并允许其他线程在该条件变化时通知等待线程。
Exchanger 的使用方式了解吗?
Exchanger 是一个同步点,可以在两个线程之间交换数据。一个线程调用 exchange() 方法,将数据传递给另一个线程,同时接收另一个线程的数据。
class Main {
    public static void main(String[] args) {
        Exchanger<String> exchanger = new Exchanger<>();

        Thread thread1 = new Thread(() -> {
            try {
                String message = "Message from thread1";
                String response = exchanger.exchange(message);
                System.out.println("Thread1 received: " + response);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        Thread thread2 = new Thread(() -> {
            try {
                String message = "Message from thread2";
                String response = exchanger.exchange(message);
                System.out.println("Thread2 received: " + response);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        });

        thread1.start();
        thread2.start();
    }
}CompletableFuture 的使用方式了解吗?
CompletableFuture 是 Java 8 引入的一个类,支持异步编程,允许线程在完成计算后将结果传递给其他线程。
可以用来异步编程,但是“任务编排”的说法更加准确。
class Main {
    public static void main(String[] args) {
        CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> {
            // 模拟长时间计算
            return "Message from CompletableFuture";
        });

        future.thenAccept(message -> {
            System.out.println("Received: " + message);
        });
    }
}memo:2025 年 1 月 28 日修改至此。
10.请说说 sleep 和 wait 的区别?(补充)
2024 年 03 月 21 日增补
sleep 会让当前线程休眠,不需要获取对象锁,属于 Thread 类的方法;wait 会让获得对象锁的线程等待,要提前获得对象锁,属于 Object 类的方法。
详细解释下。
①、所属类不同
sleep()方法专属于Thread类。wait()方法专属于Object类。
②、锁行为不同
如果一个线程在持有某个对象锁时调用了 sleep 方法,它在睡眠期间仍然会持有这个锁。
class SleepDoesNotReleaseLock {

    private static final Object lock = new Object();

    public static void main(String[] args) throws InterruptedException {
        Thread sleepingThread = new Thread(() -> {
            synchronized (lock) {
                System.out.println("Thread 1 会继续持有锁,并且进入睡眠状态");
                try {
                    Thread.sleep(5000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("Thread 1 醒来了,并且释放了锁");
            }
        });

        Thread waitingThread = new Thread(() -> {
            synchronized (lock) {
                System.out.println("Thread 2 进入同步代码块");
            }
        });

        sleepingThread.start();
        Thread.sleep(1000);
        waitingThread.start();
    }
}输出结果:
Thread 1 会继续持有锁,并且进入睡眠状态
Thread 1 醒来了,并且释放了锁
Thread 2 进入同步代码块从输出中我们可以看到,waitingThread 必须等待 sleepingThread 完成睡眠后才能进入同步代码块。
而当线程执行 wait 方法时,它会释放持有的对象锁,因此其他线程也有机会获取该对象的锁。
class WaitReleasesLock {

    private static final Object lock = new Object();

    public static void main(String[] args) throws InterruptedException {
        Thread waitingThread = new Thread(() -> {
            synchronized (lock) {
                try {
                    System.out.println("Thread 1 持有锁,准备等待 5 秒");
                    lock.wait(5000);
                    System.out.println("Thread 1 醒来了,并且退出同步代码块");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });

        Thread notifyingThread = new Thread(() -> {
            synchronized (lock) {
                System.out.println("Thread 2 尝试唤醒等待中的线程");
                lock.notify();
                System.out.println("Thread 2 执行完了 notify");
            }
        });

        waitingThread.start();
        Thread.sleep(1000);
        notifyingThread.start();
    }
}输出结果:
Thread 1 持有锁,准备等待 5 秒
Thread 2 尝试唤醒等待中的线程
Thread 2 执行完了 notify
Thread 1 醒来了,并且退出同步代码块这表明 waitingThread 在调用 wait 后确实释放了锁。
③、使用条件不同
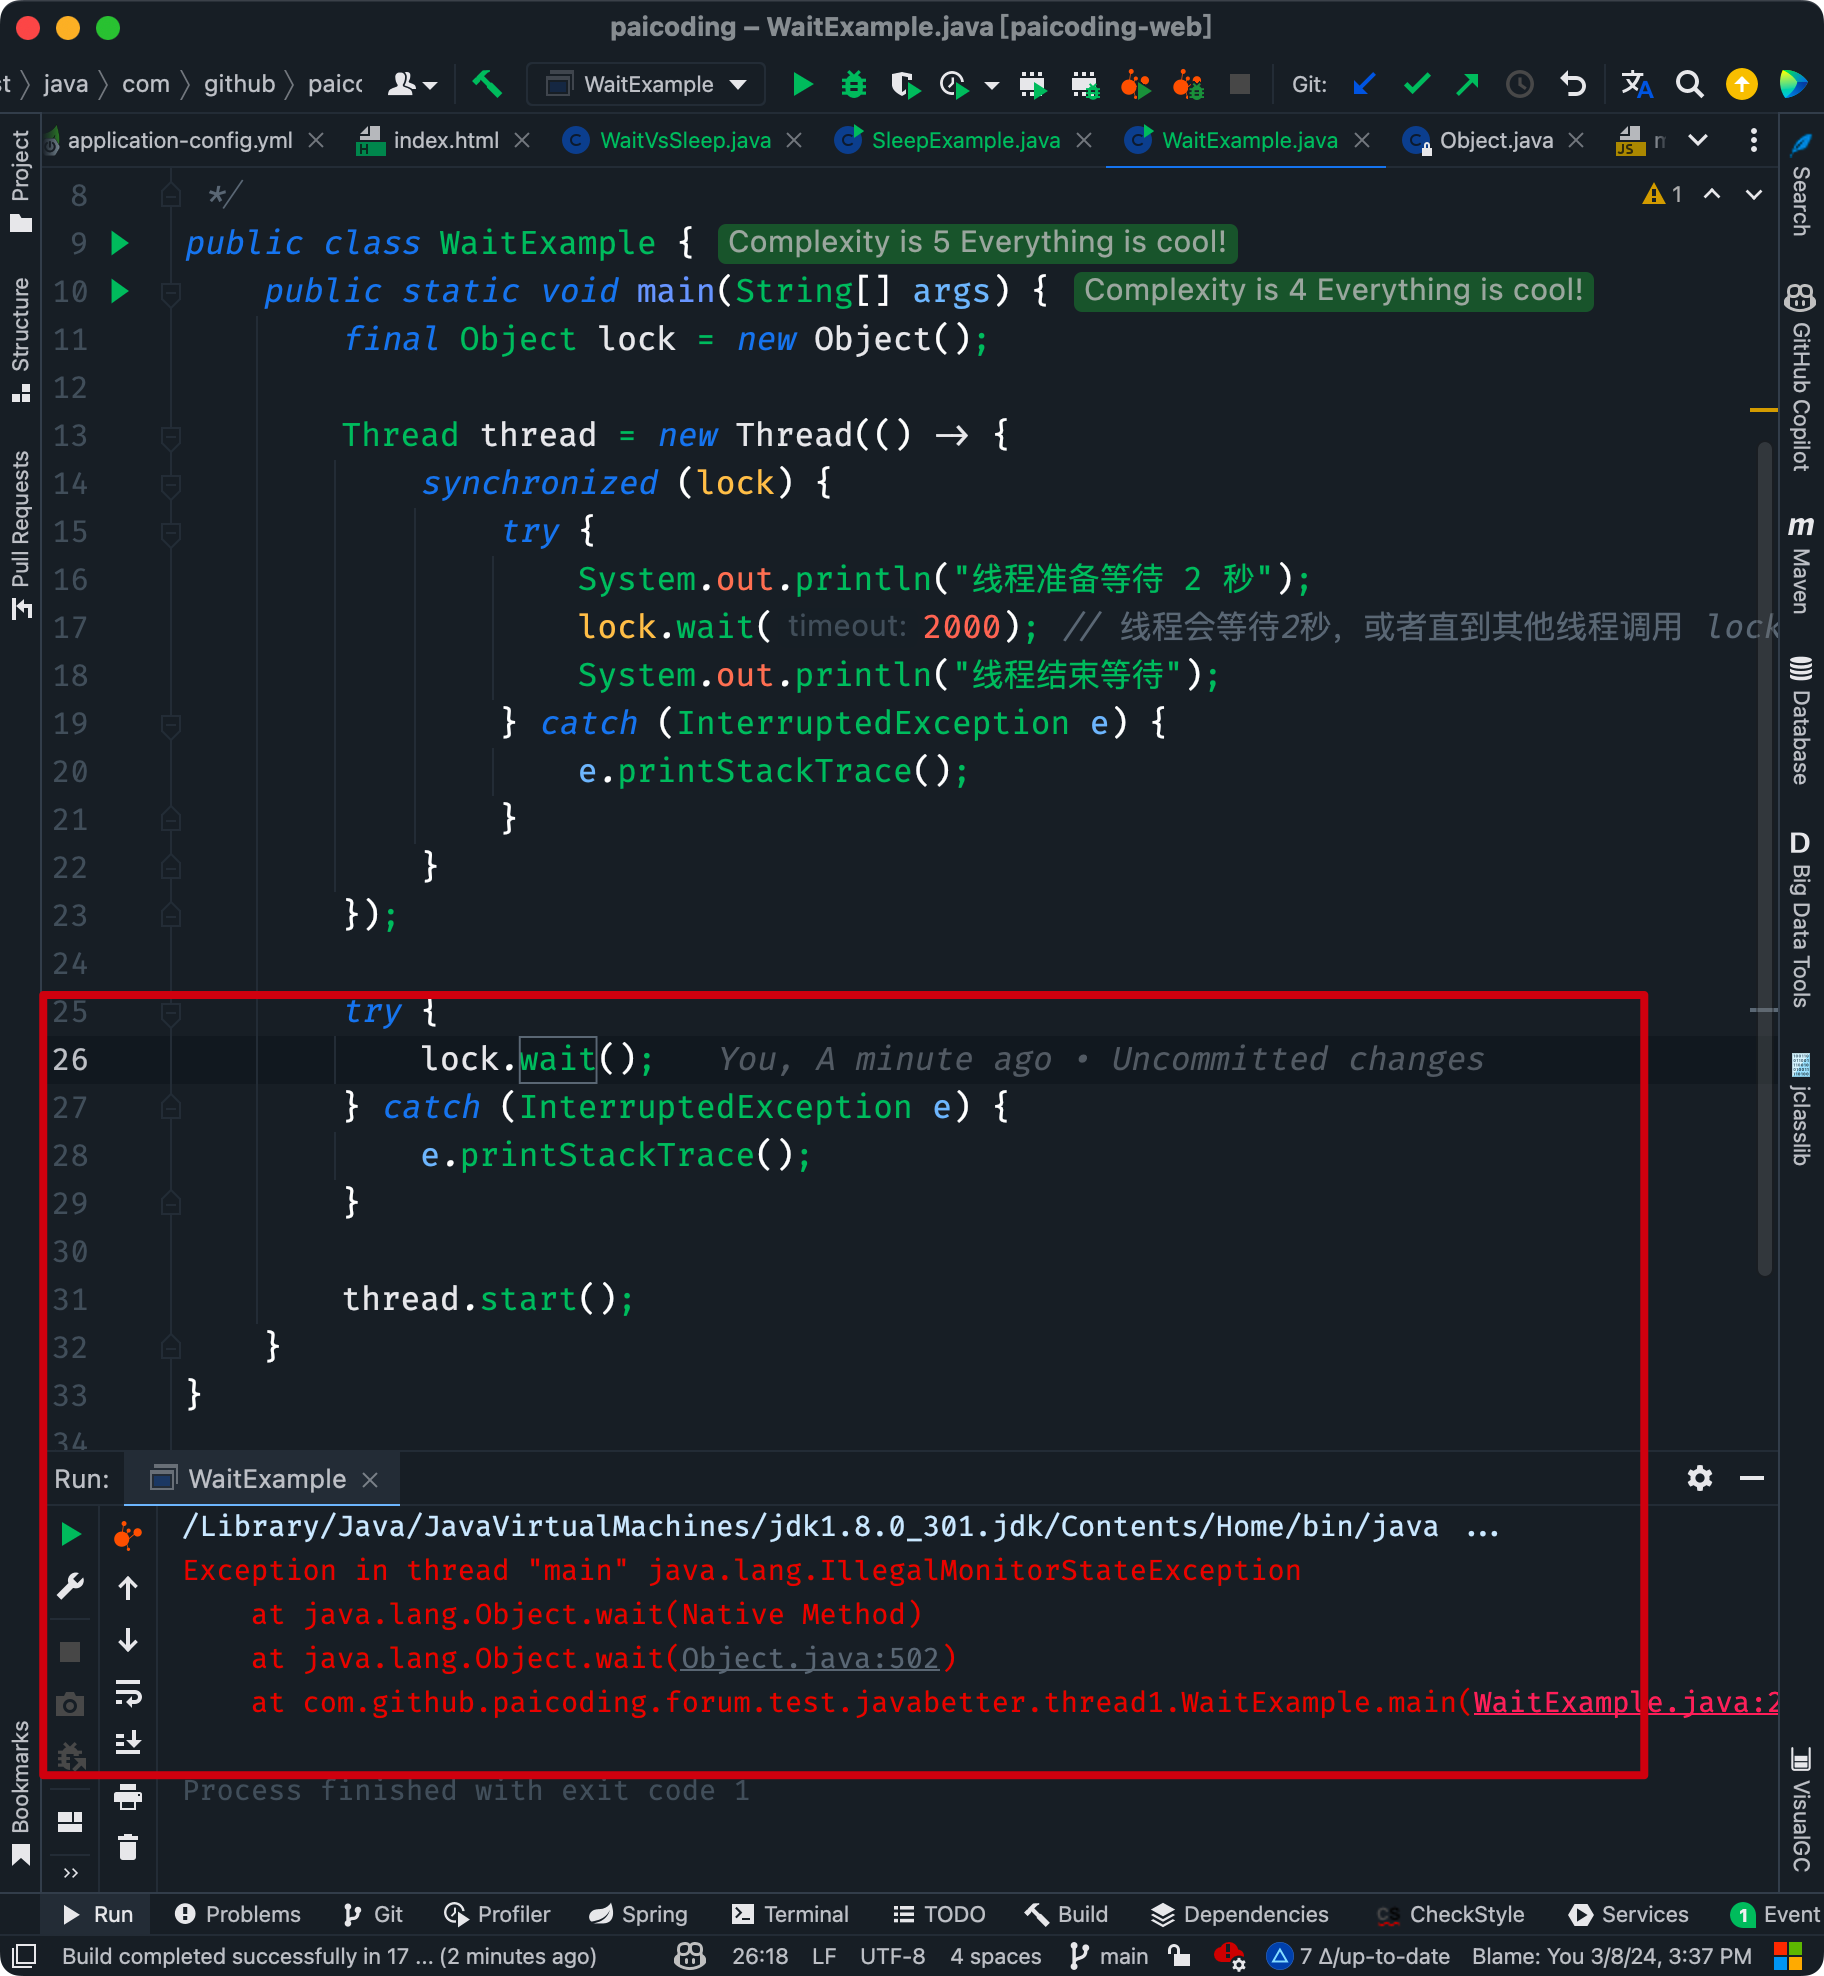
sleep()方法可以在任何地方被调用。wait()方法必须在同步代码块或同步方法中被调用,这是因为调用wait()方法的前提是当前线程必须持有对象的锁。否则会抛出IllegalMonitorStateException异常。
④、唤醒方式不同
- 调用 sleep 方法后,线程会进入 TIMED_WAITING 状态,即在指定的时间内暂停执行。当指定的时间结束后,线程会自动恢复到 RUNNABLE 状态,等待 CPU 调度再次执行。
- 调用 wait 方法后,线程会进入 WAITING 状态,直到有其他线程在同一对象上调用 notify 或 notifyAll 方法,线程才会从 WAITING 状态转变为 RUNNABLE 状态,准备再次获得 CPU 的执行权。
我们来通过代码再感受一下 sleep() 和 wait() 在用法上的区别,先看 sleep() 的用法:
class SleepExample {
    public static void main(String[] args) {
        Thread thread = new Thread(() -> {
            System.out.println("线程准备休眠 2 秒");
            try {
                Thread.sleep(2000); // 线程将睡眠2秒
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println("线程醒来了");
        });

        thread.start();
    }
}再来看 wait() 的用法:
class WaitExample {
    public static void main(String[] args) {
        final Object lock = new Object();

        Thread thread = new Thread(() -> {
            synchronized (lock) {
                try {
                    System.out.println("线程准备等待 2 秒");
                    lock.wait(2000); // 线程会等待2秒,或者直到其他线程调用 lock.notify()/notifyAll()
                    System.out.println("线程结束等待");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });

        thread.start();
    }
}memo:2025 年 1 月 29 日修改至此。
11.怎么保证线程安全?(补充)
2024 年 05 月 01 日增补
线程安全是指在并发环境下,多个线程访问共享资源时,程序能够正确地执行,而不会出现数据不一致的问题。
为了保证线程安全,可以使用 synchronized 关键字对方法加锁,对代码块加锁。线程在执行同步方法、同步代码块时,会获取类锁或者对象锁,其他线程就会阻塞并等待锁。
如果需要更细粒度的锁,可以使用 ReentrantLock 并发重入锁等。
如果需要保证变量的内存可见性,可以使用 volatile 关键字。
对于简单的原子变量操作,还可以使用 Atomic 原子类。
对于线程独立的数据,可以使用 ThreadLocal 来为每个线程提供专属的变量副本。
对于需要并发容器的地方,可以使用 ConcurrentHashMap、CopyOnWriteArrayList 等。
有个 int 的变量为 0,十个线程轮流对其进行++操作(循环 10000 次),结果大于 10 万还是小于等于 10 万,为什么?
在这个场景中,最终的结果会小于 100000,原因是多线程环境下,++ 操作并不是一个原子操作,而是分为读取、加 1、写回三个步骤。
- 读取变量的值。
- 将读取到的值加 1。
- 将结果写回变量。
这样的话,就会有多个线程读取到相同的值,然后对这个值进行加 1 操作,最终导致结果小于 100000。
详细解释下。
多个线程在并发执行 ++ 操作时,可能出现以下竞态条件:
- 线程 1 读取变量值为 0。
- 线程 2 也读取变量值为 0。
- 线程 1 进行加法运算并将结果 1 写回变量。
- 线程 2 进行加法运算并将结果 1 写回变量,覆盖了线程 1 的结果。
可以通过 synchronized 关键字为 ++ 操作加锁。
class Main {
    private static int count = 0;

    public static void main(String[] args) throws InterruptedException {
        Runnable task = () -> {
            for (int i = 0; i < 10000; i++) {
                synchronized (Main.class) {
                    count++;
                }
            }
        };

        List<Thread> threads = new ArrayList<>();
        for (int i = 0; i < 10; i++) {
            Thread thread = new Thread(task);
            threads.add(thread);
            thread.start();
        }

        for (Thread thread : threads) {
            thread.join();
        }

        System.out.println("Final count: " + count);
    }
}或者使用 AtomicInteger 的 incrementAndGet() 方法来替代 ++ 操作,保证变量的原子性。
class Main {
    private static AtomicInteger count = new AtomicInteger(0);

    public static void main(String[] args) throws InterruptedException {
        Runnable task = () -> {
            for (int i = 0; i < 10000; i++) {
                count.incrementAndGet();
            }
        };

        List<Thread> threads = new ArrayList<>();
        for (int i = 0; i < 10; i++) {
            Thread thread = new Thread(task);
            threads.add(thread);
            thread.start();
        }

        for (Thread thread : threads) {
            thread.join();
        }

        System.out.println("Final count: " + count.get());
    }
}场景:有一个 key 对应的 value 是一个 json 结构,json 当中有好几个子任务,这些子任务如果对 key 进行修改的话,会不会存在线程安全的问题?
会。
在单节点环境中,可以使用 synchronized 关键字或 ReentrantLock 来保证对 key 的修改操作是原子的。
class KeyManager {
    private final ReentrantLock lock = new ReentrantLock();

    private String key = "{\"tasks\": [\"task1\", \"task2\"]}";

    public String readKey() {
        lock.lock();
        try {
            return key;
        } finally {
            lock.unlock();
        }
    }

    public void updateKey(String newKey) {
        lock.lock();
        try {
            this.key = newKey;
        } finally {
            lock.unlock();
        }
    }
}在多节点环境中,可以使用分布式锁 Redisson 来保证对 key 的修改操作是原子的。
class DistributedKeyManager {
    private final RedissonClient redisson;

    public DistributedKeyManager() {
        Config config = new Config();
        config.useSingleServer().setAddress("redis://127.0.0.1:6379");
        this.redisson = Redisson.create(config);
    }

    public void updateKey(String key, String newValue) {
        RLock lock = redisson.getLock(key);
        lock.lock();
        try {
            // 模拟读取和更新操作
            String currentValue = readFromDatabase(key); // 假设读取 JSON 数据
            String updatedValue = modifyJson(currentValue, newValue); // 修改 JSON
            writeToDatabase(key, updatedValue); // 写回数据库
        } finally {
            lock.unlock();
        }
    }

    private String readFromDatabase(String key) {
        // 模拟从数据库读取
        return "{\"tasks\": [\"task1\", \"task2\"]}";
    }

    private String modifyJson(String json, String newValue) {
        // 使用 JSON 库解析并修改
        return json.replace("task1", newValue);
    }

    private void writeToDatabase(String key, String value) {
        // 模拟写回数据库
    }
}说一个线程安全的使用场景?
单例模式。在多线程环境下,如果多个线程同时尝试创建实例,单例类必须确保只创建一个实例,并提供一个全局访问点。
饿汉式是一种比较直接的实现方式,它通过在类加载时就立即初始化单例对象来保证线程安全。
class Singleton {
    private static final Singleton instance = new Singleton();

    private Singleton() {
    }

    public static Singleton getInstance() {
        return instance;
    }
}懒汉式单例则在第一次使用时初始化单例对象,这种方式需要使用双重检查锁定来确保线程安全,volatile 关键字用来保证可见性,syncronized 关键字用来保证同步。
class LazySingleton {
    private static volatile LazySingleton instance;

    private LazySingleton() {}

    public static LazySingleton getInstance() {
        if (instance == null) { // 第一次检查
            synchronized (LazySingleton.class) {
                if (instance == null) { // 第二次检查
                    instance = new LazySingleton();
                }
            }
        }
        return instance;
    }
}能说一下 Hashtable 的底层数据结构吗?
与 HashMap 类似,Hashtable 的底层数据结构也是一个数组加上链表的方式,然后通过 synchronized 加锁来保证线程安全。
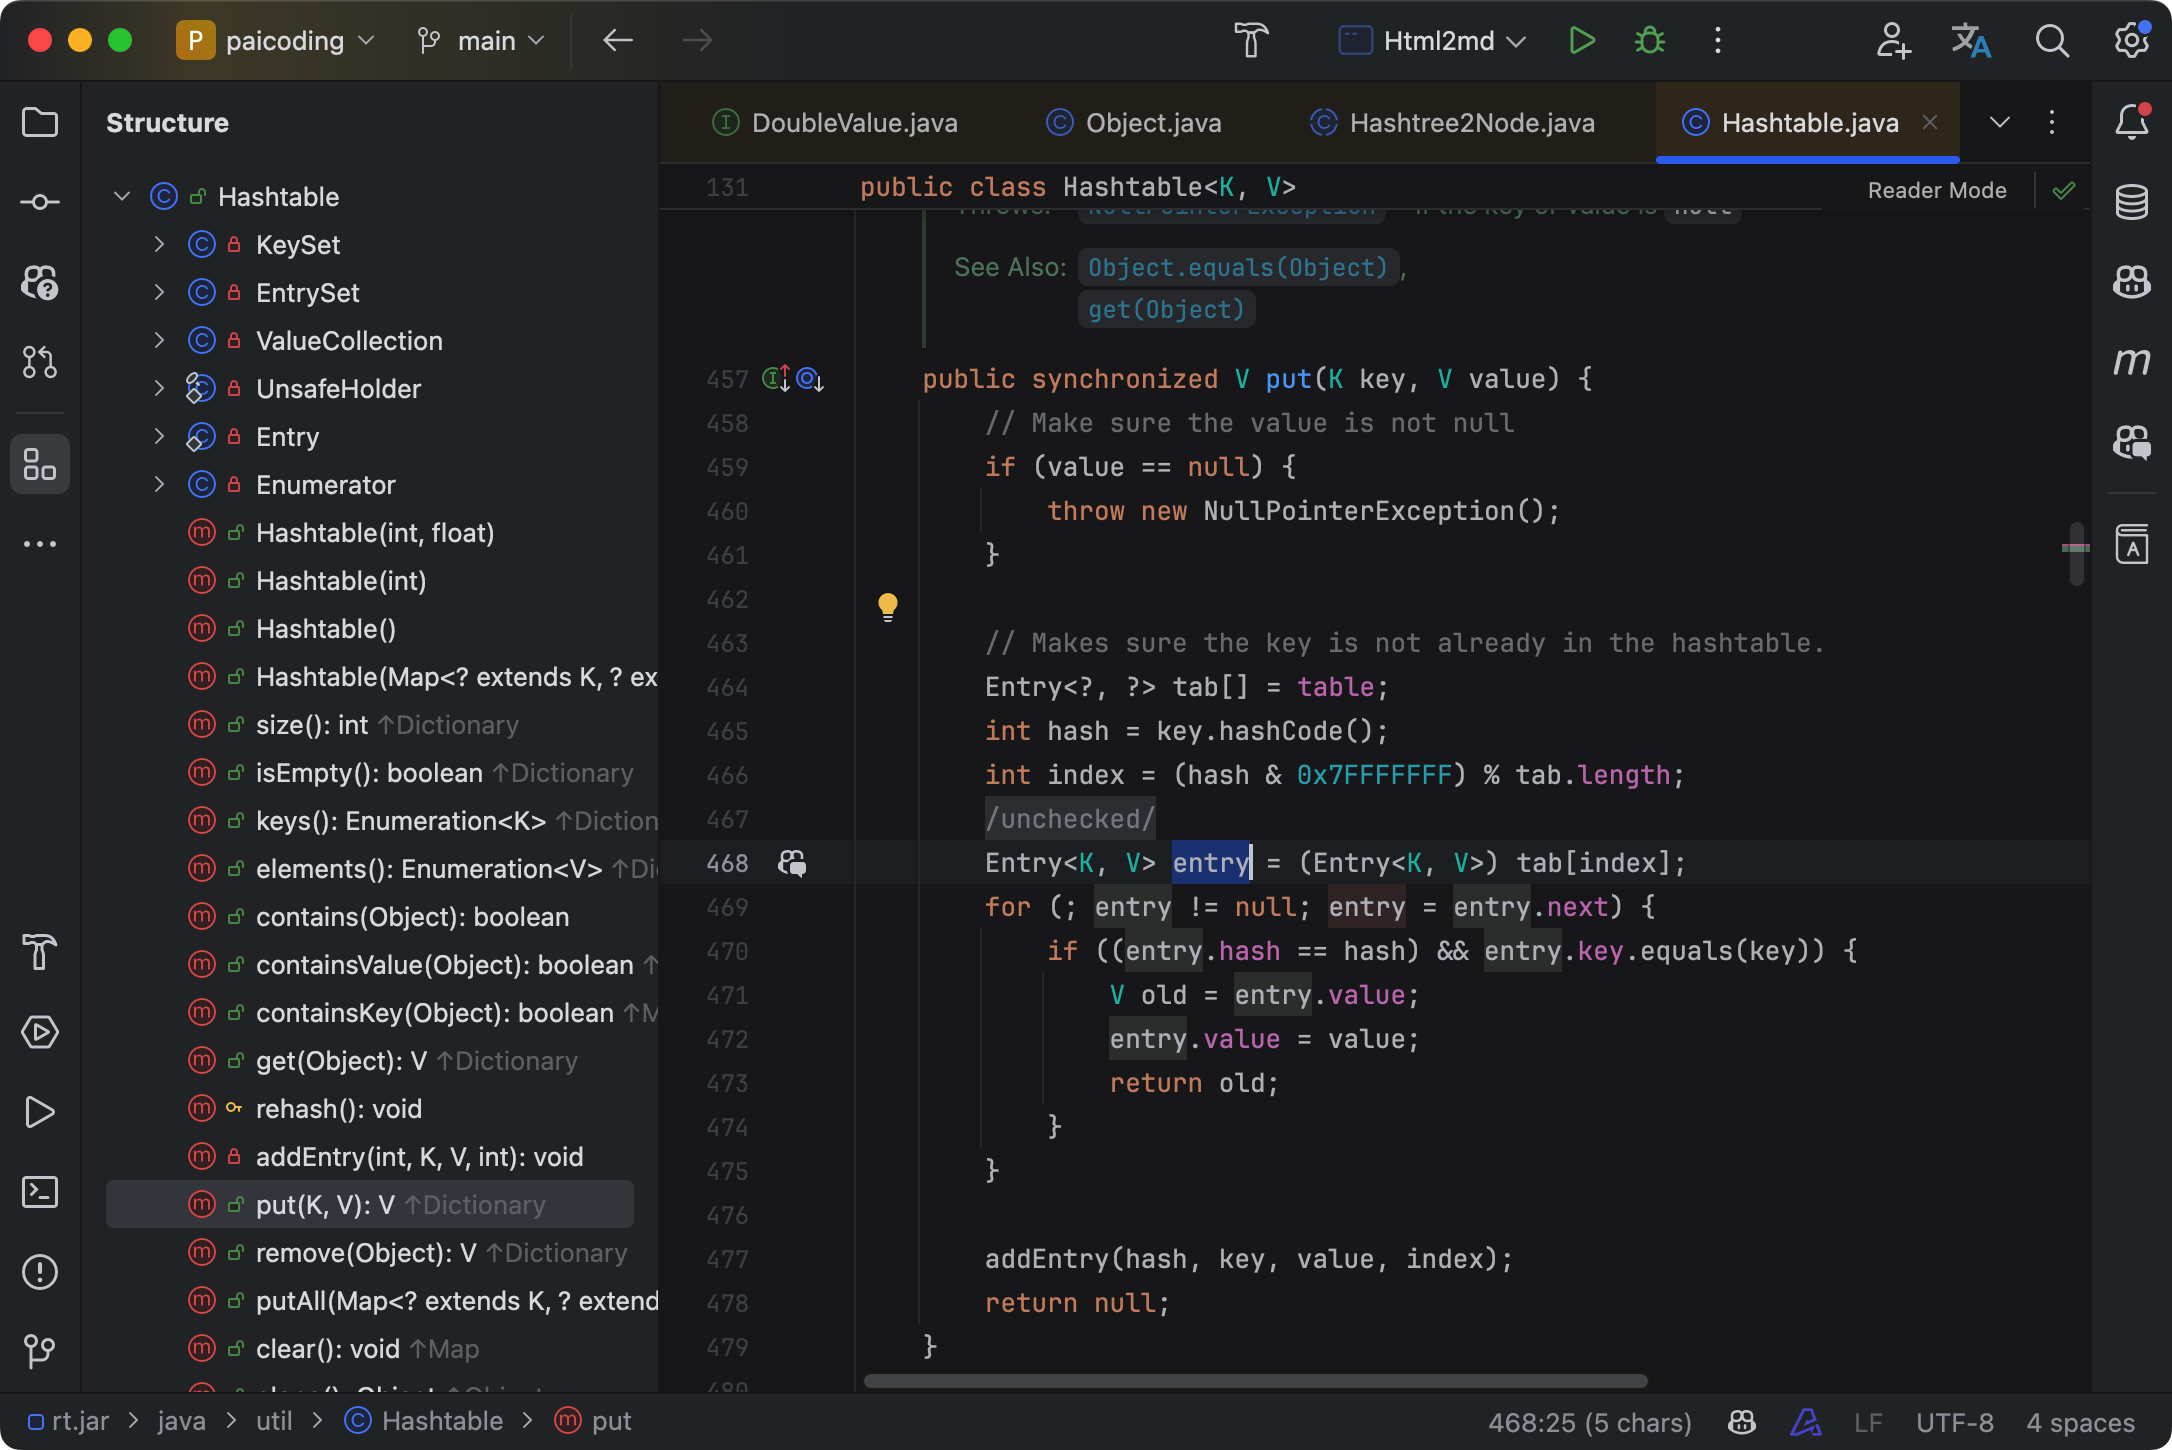
memo:2025 年 1 月 30 日修改至此。
ThreadLocal
推荐阅读:ThreadLocal 全面解析
🌟12.ThreadLocal 是什么?
ThreadLocal 是一种用于实现线程局部变量的工具类。它允许每个线程都拥有自己的独立副本,从而实现线程隔离。
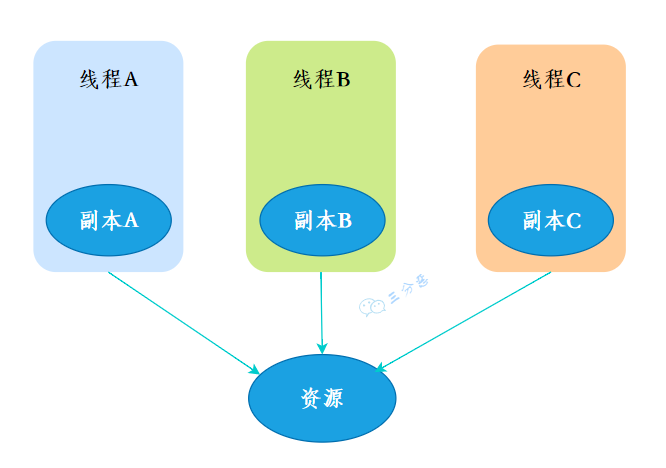
使用 ThreadLocal 通常分为四步:
①、创建 ThreadLocal
//创建一个ThreadLocal变量
public static ThreadLocal<String> localVariable = new ThreadLocal<>();②、设置 ThreadLocal 的值
//设置ThreadLocal变量的值
localVariable.set("沉默王二是沙雕");③、获取 ThreadLocal 的值
//获取ThreadLocal变量的值
String value = localVariable.get();④、删除 ThreadLocal 的值
//删除ThreadLocal变量的值
localVariable.remove();在 Web 应用中,可以使用 ThreadLocal 存储用户会话信息,这样每个线程在处理用户请求时都能方便地访问当前用户的会话信息。
在数据库操作中,可以使用 ThreadLocal 存储数据库连接对象,每个线程有自己独立的数据库连接,从而避免了多线程竞争同一数据库连接的问题。
在格式化操作中,例如日期格式化,可以使用 ThreadLocal 存储 SimpleDateFormat 实例,避免多线程共享同一实例导致的线程安全问题。
ThreadLocal 有哪些优点?
每个线程访问的变量副本都是独立的,避免了共享变量引起的线程安全问题。由于 ThreadLocal 实现了变量的线程独占,使得变量不需要同步处理,因此能够避免资源竞争。
ThreadLocal 可用于跨方法、跨类时传递上下文数据,不需要在方法间传递参数。
13.你在工作中用到过 ThreadLocal 吗?
有用到过,用来存储用户信息。
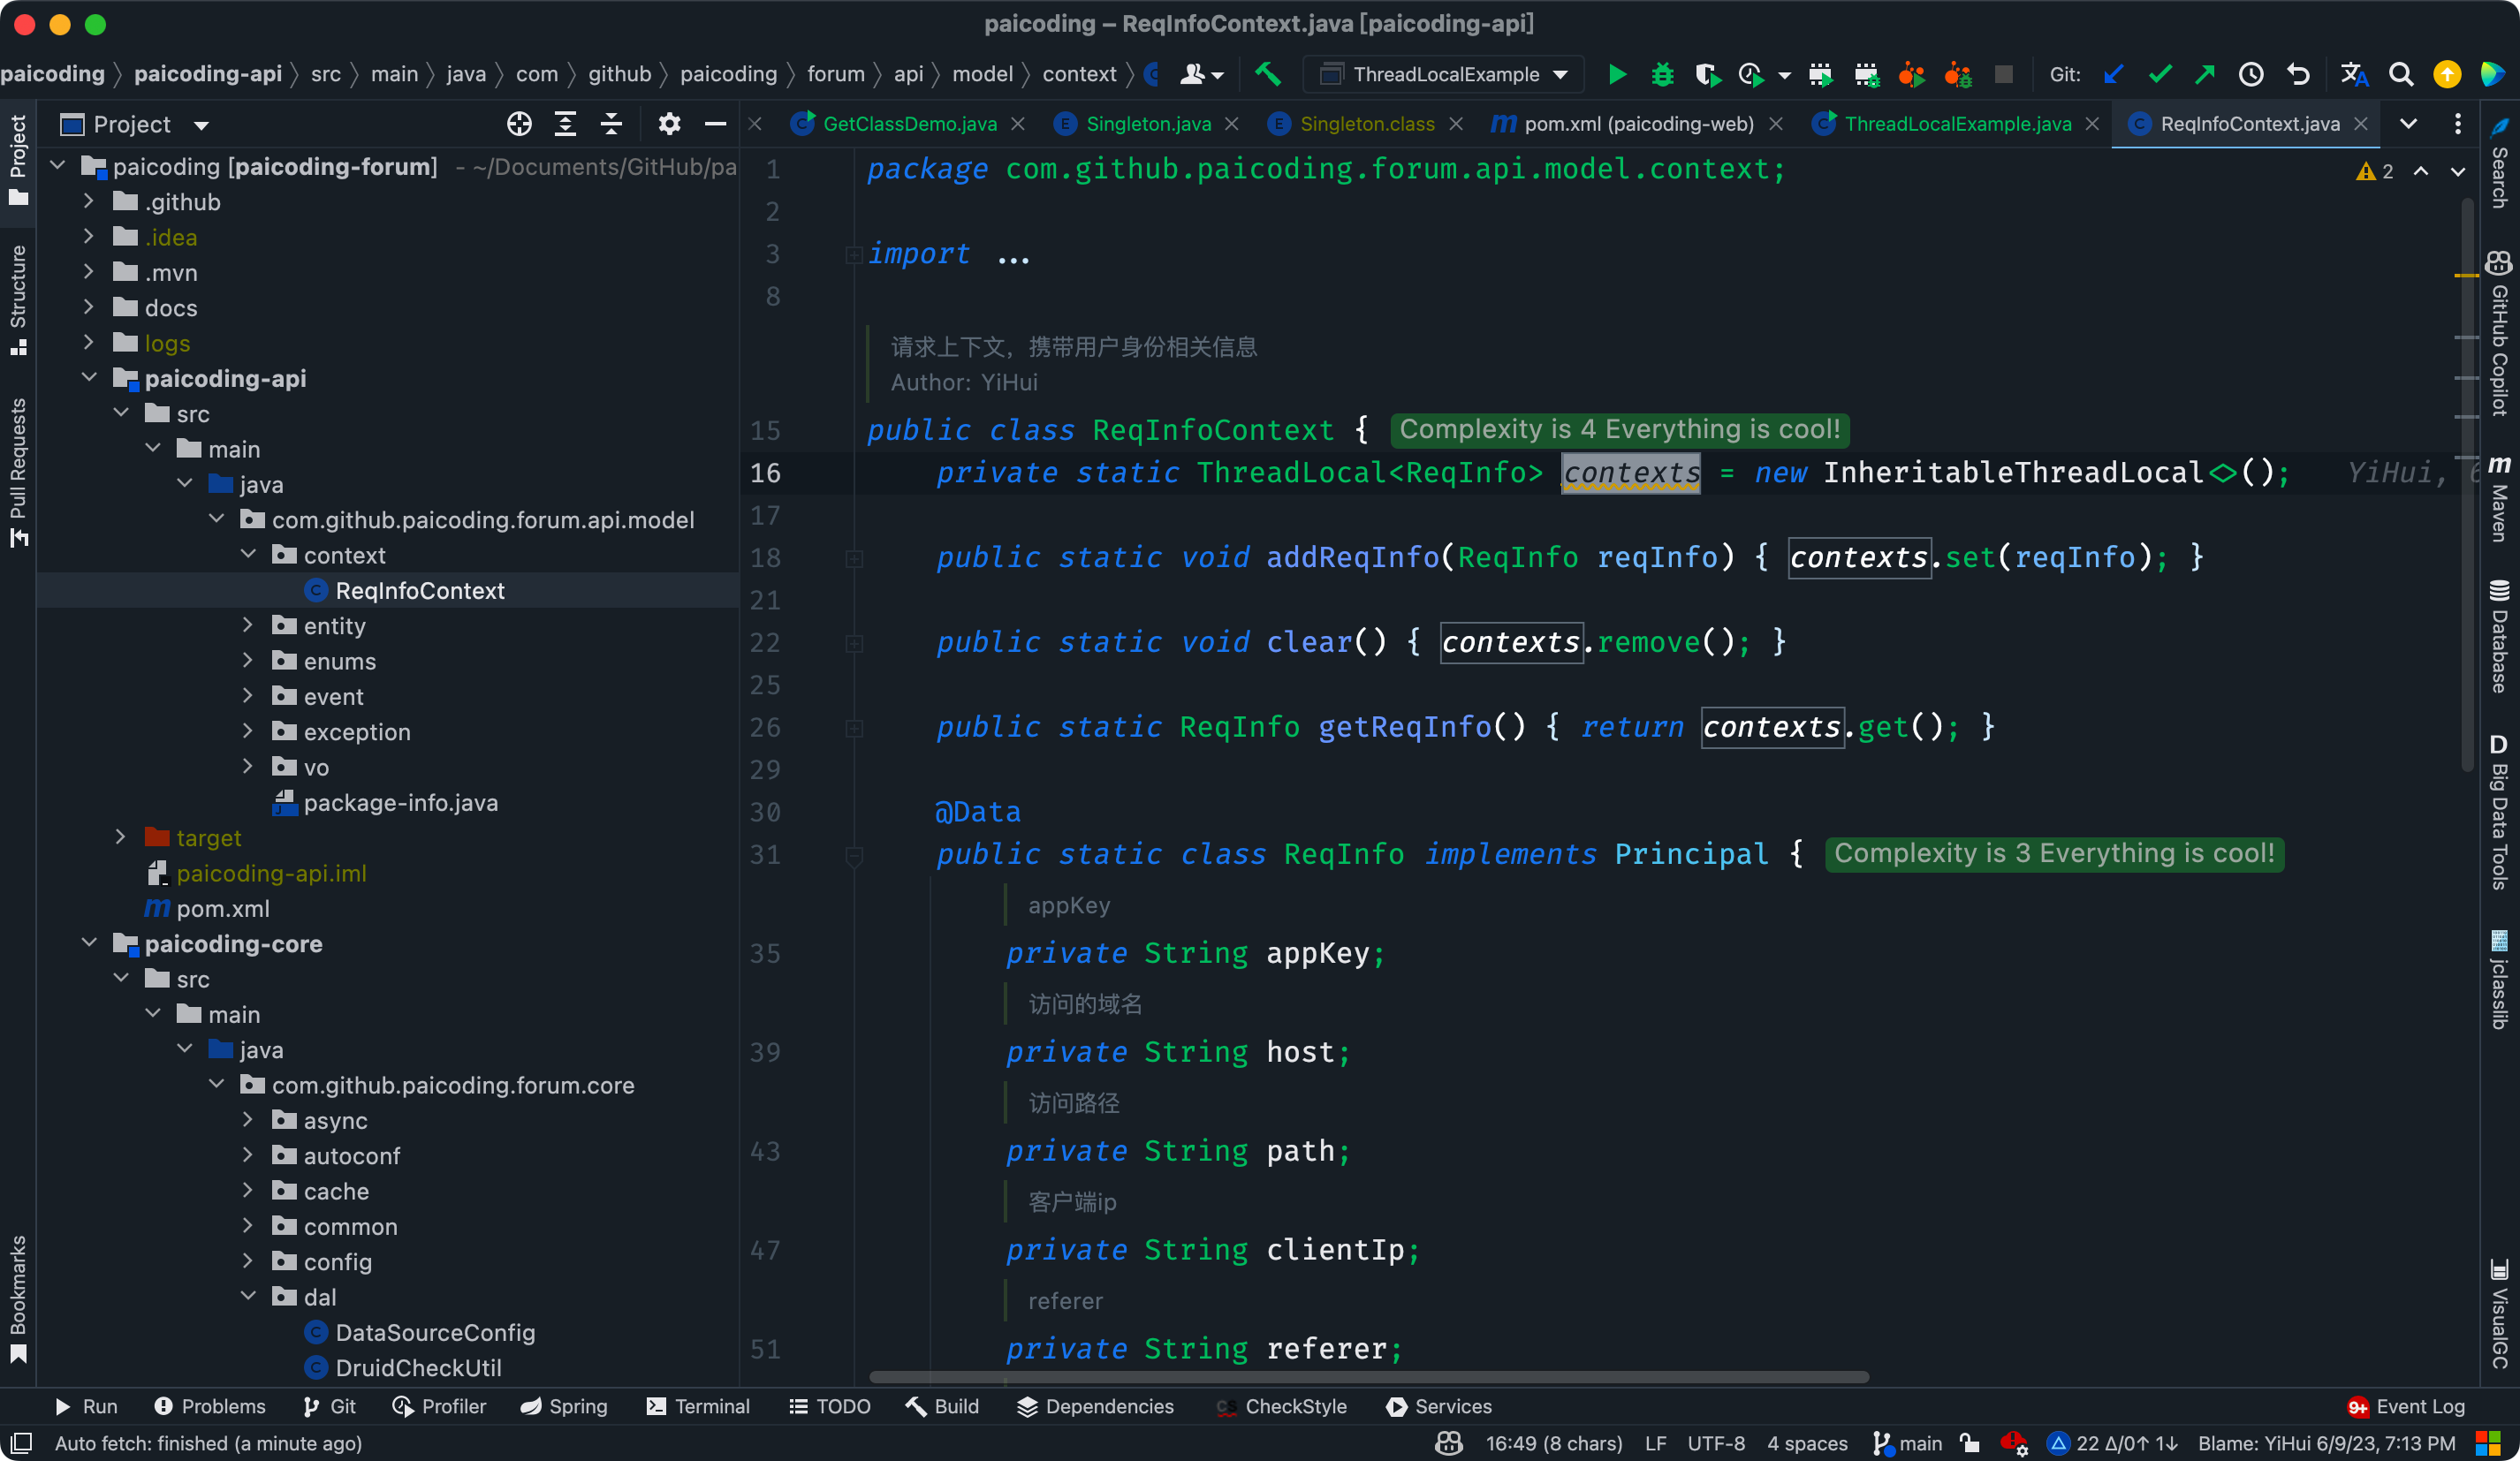
技术派实战项目是典型的 MVC 架构,登录后的用户每次访问接口,都会在请求头中携带一个 token,在控制层可以根据这个 token,解析出用户的基本信息。
假如在服务层和持久层也要用到用户信息,就可以在控制层拦截请求把用户信息存入 ThreadLocal。
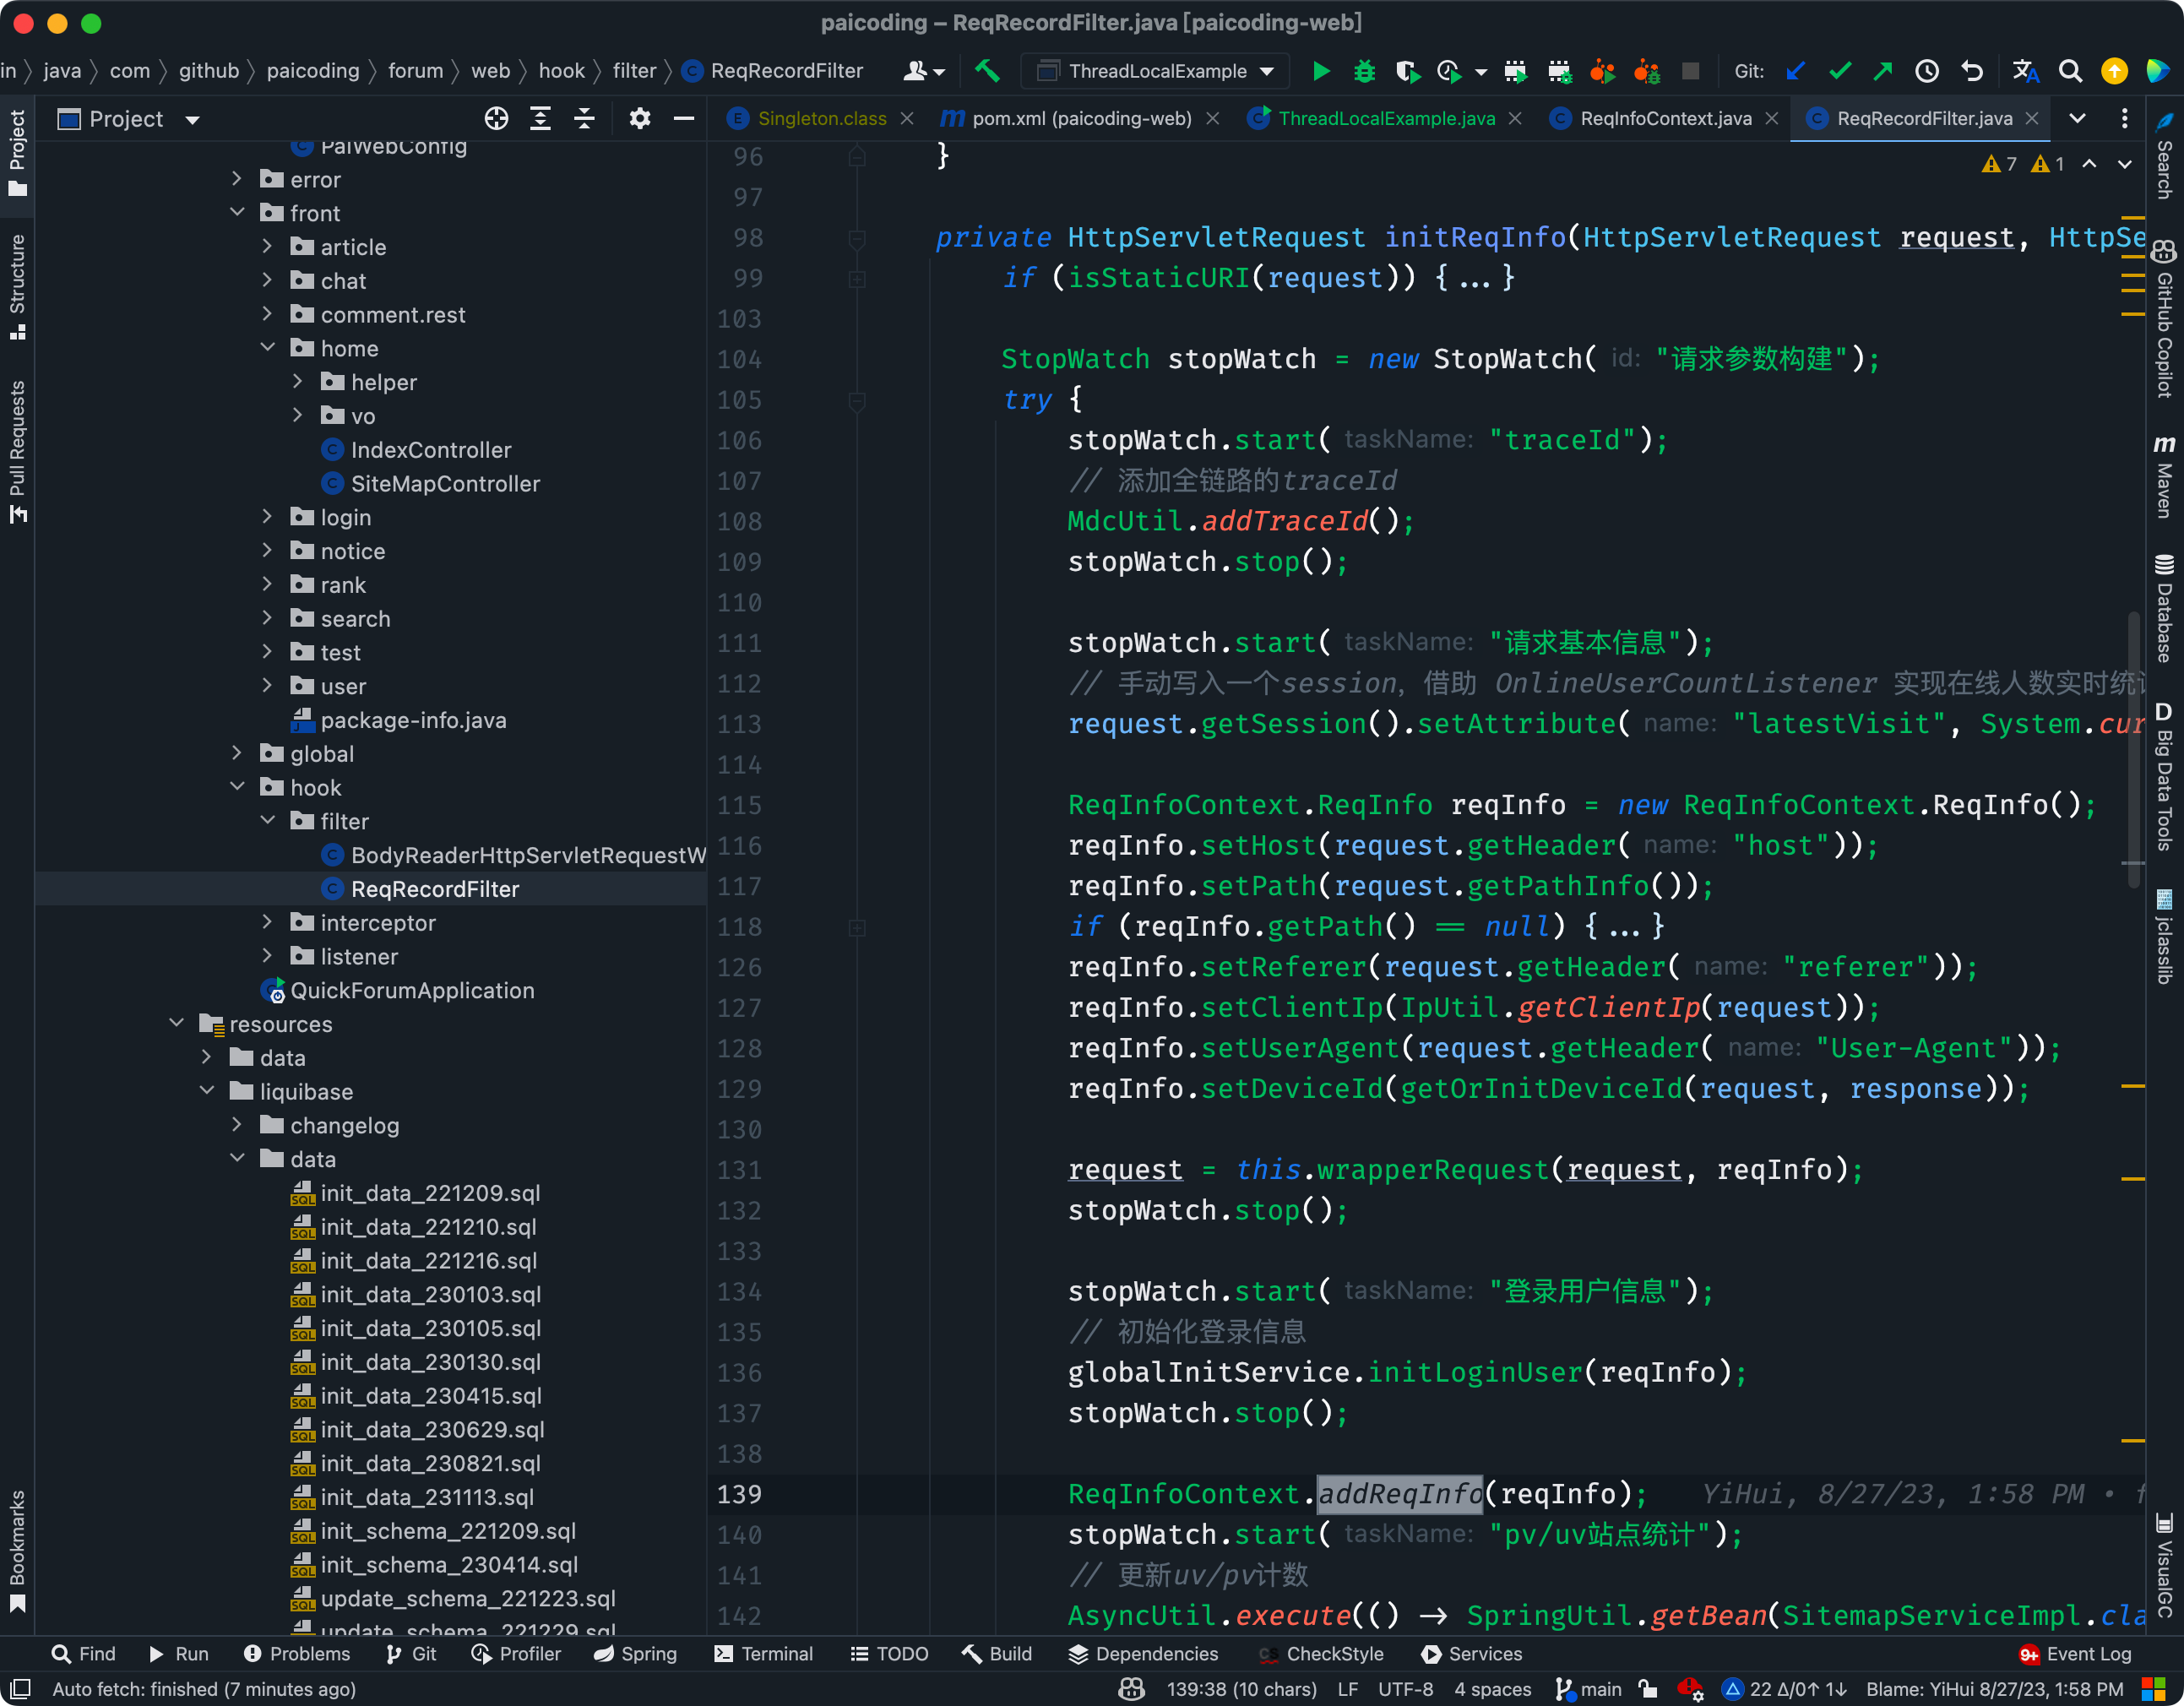
这样我们在任何一个地方,都可以取出 ThreadLocal 中存的用户信息。
很多其它场景的 cookie、session 等等数据隔离都可以通过 ThreadLocal 去实现。
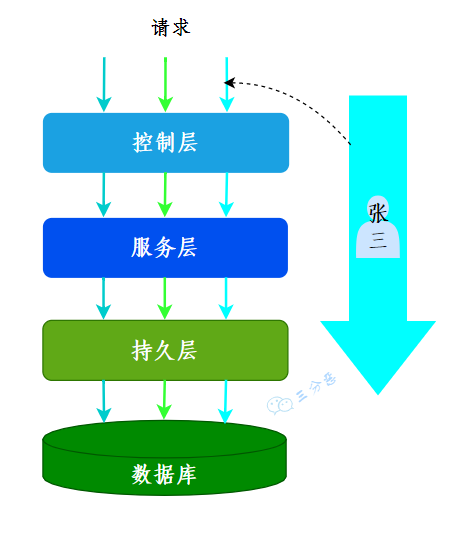
memo:2025 年 1 月 31 日修改至此。
🌟14.ThreadLocal 怎么实现的呢?
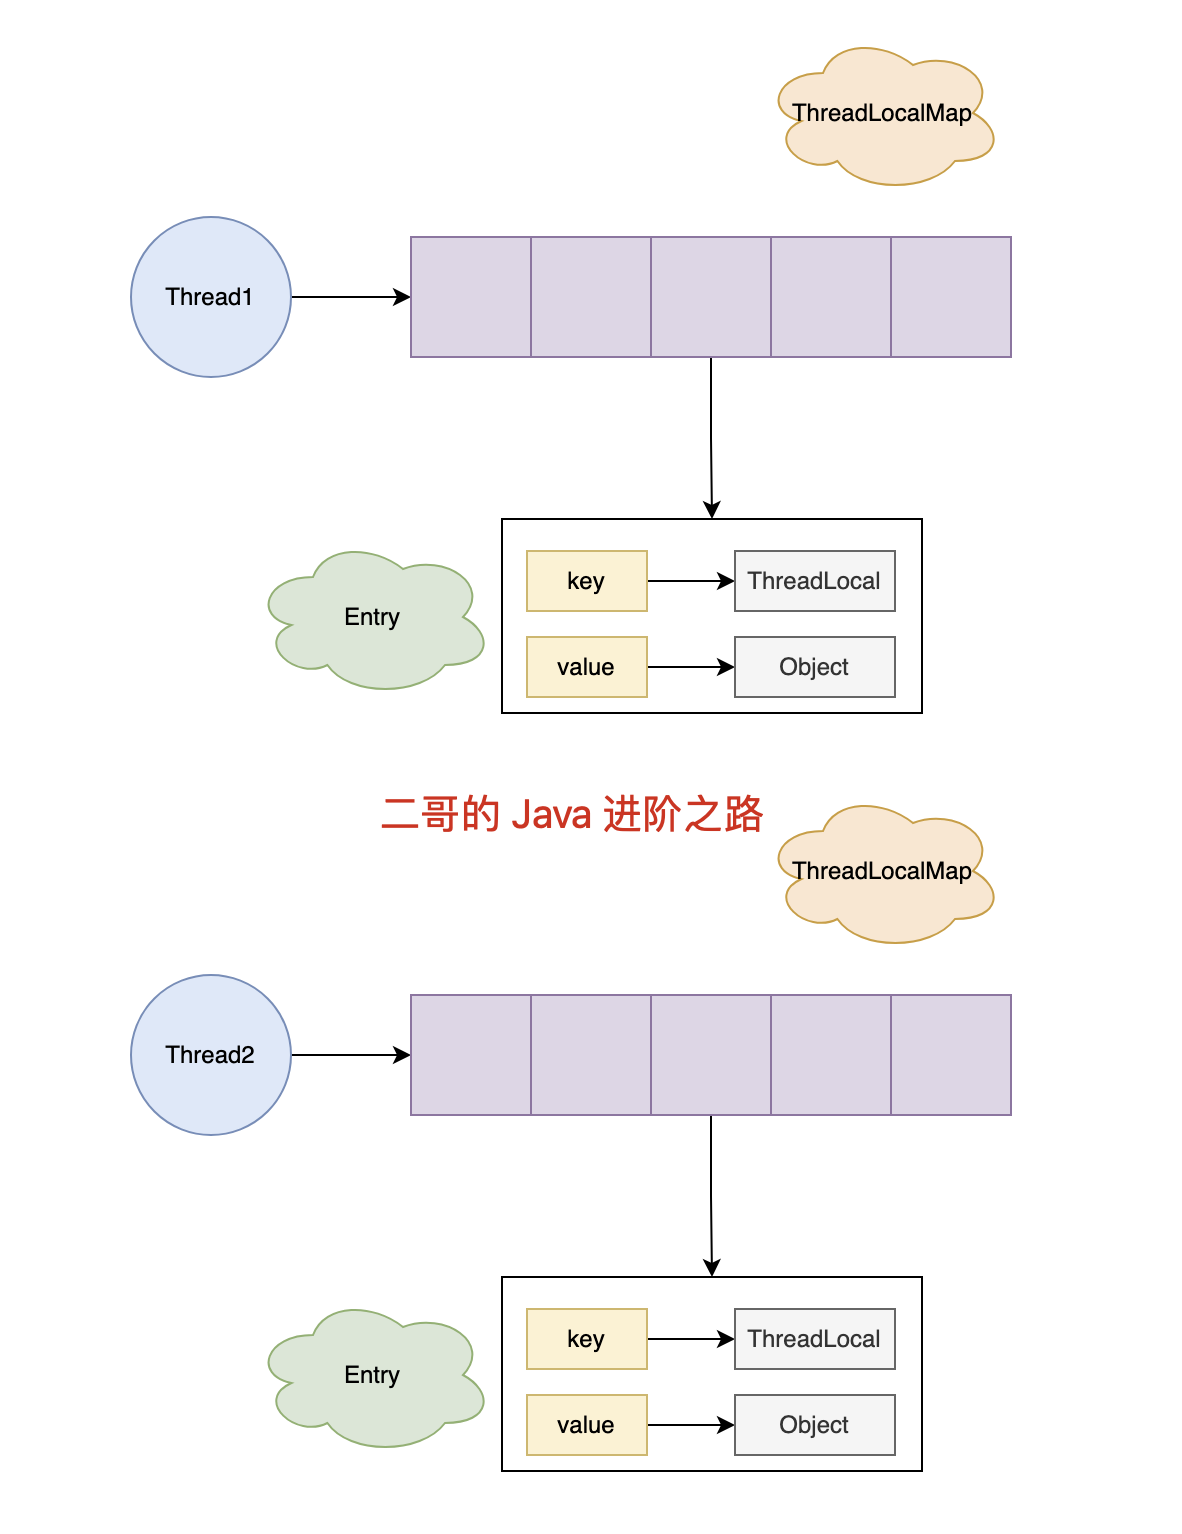
当我们创建一个 ThreadLocal 对象并调用 set 方法时,其实是在当前线程中初始化了一个 ThreadLocalMap。
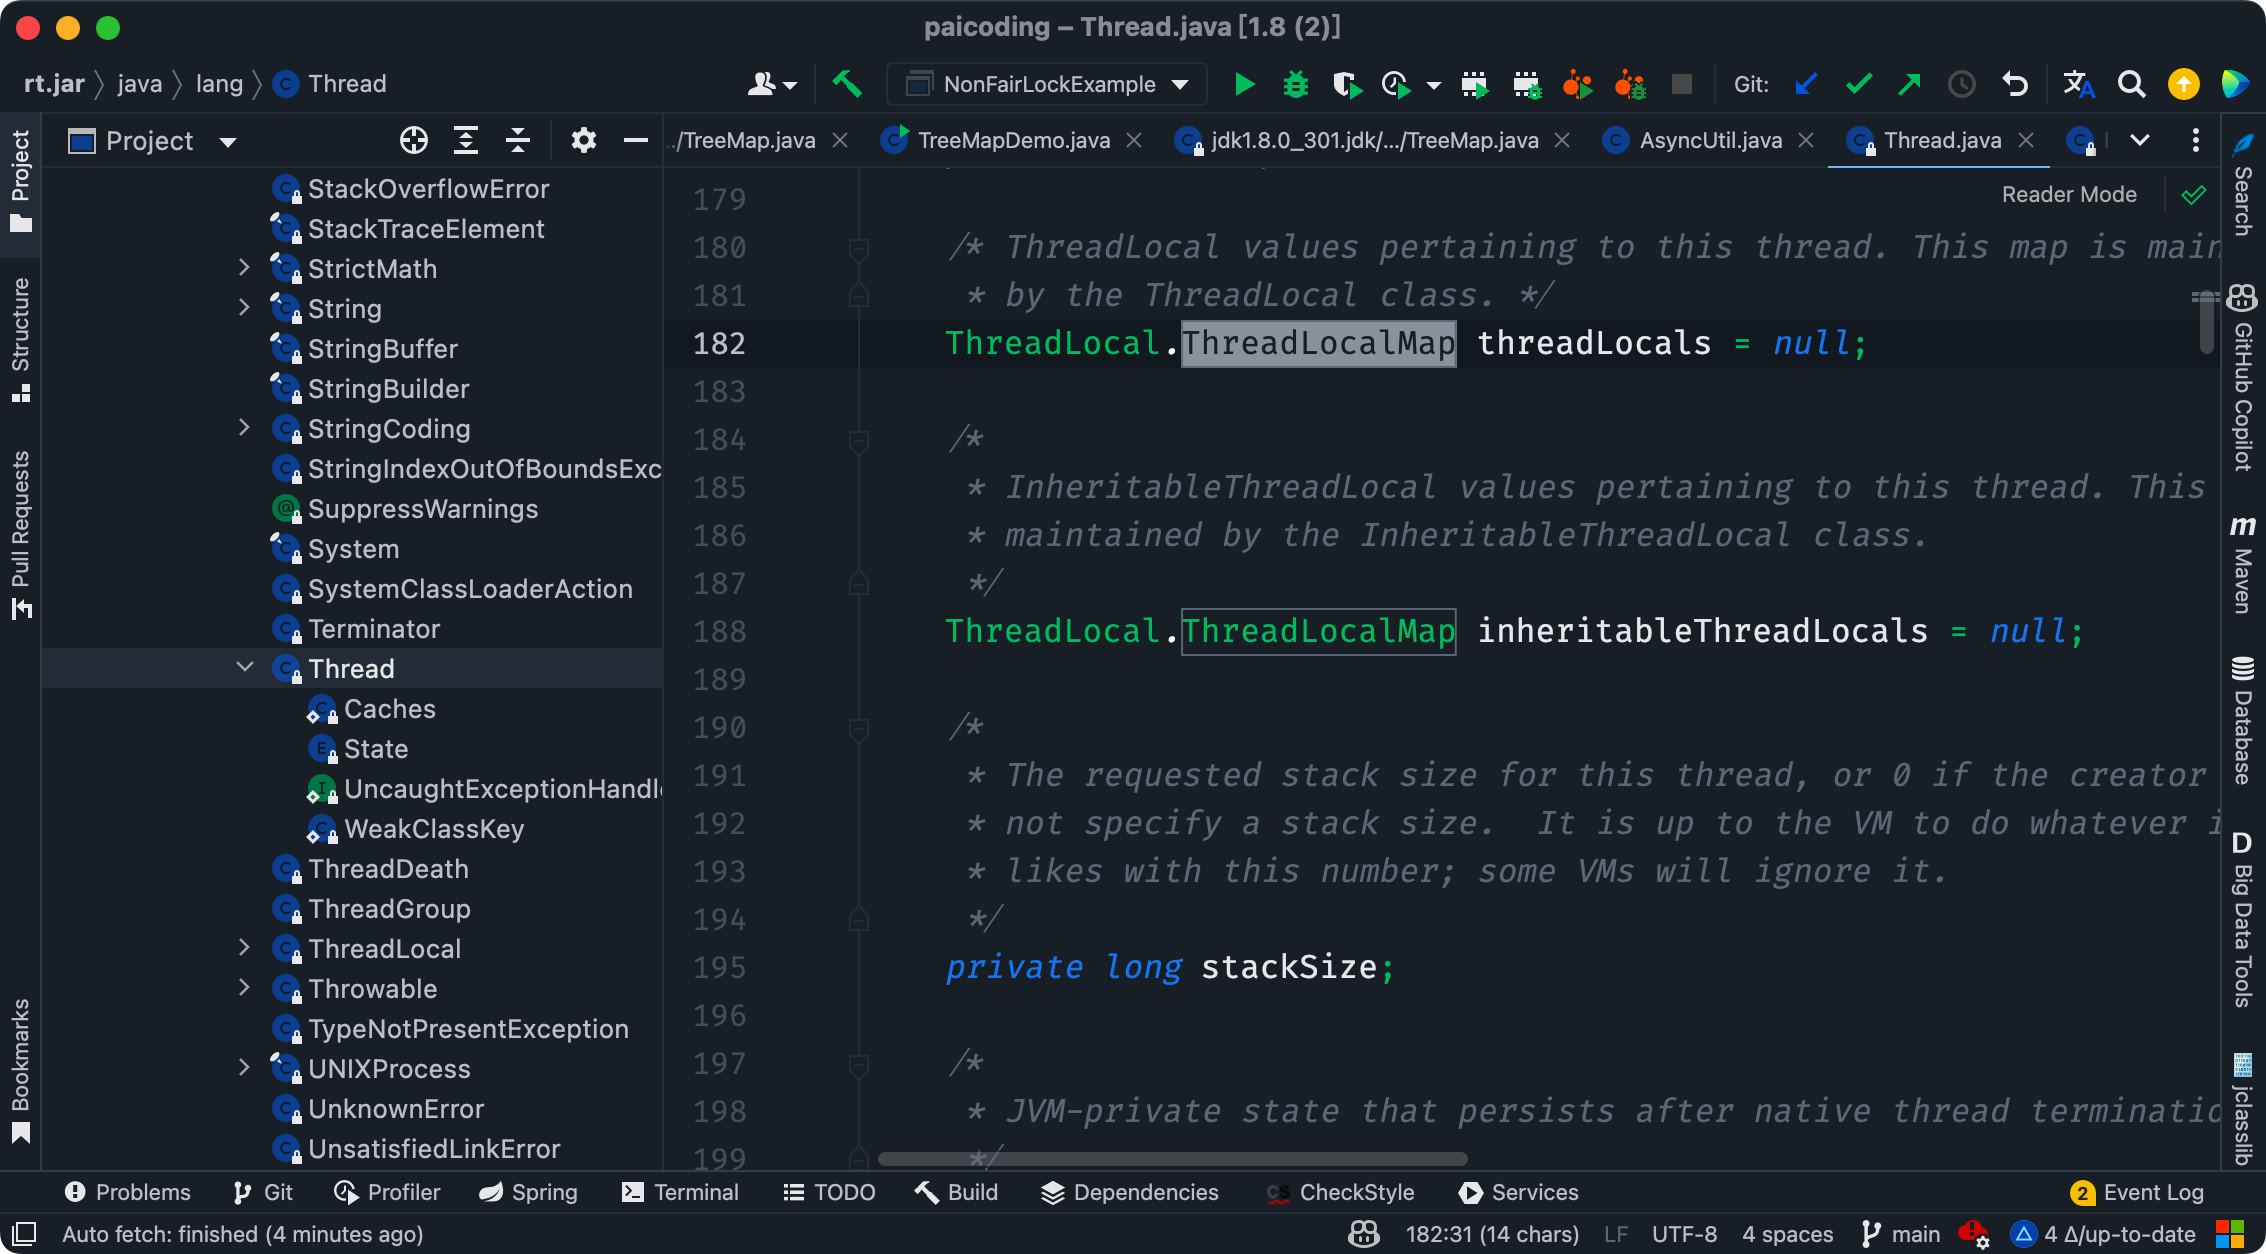
ThreadLocalMap 是 ThreadLocal 的一个静态内部类,它内部维护了一个 Entry 数组,key 是 ThreadLocal 对象,value 是线程的局部变量,这样就相当于为每个线程维护了一个变量副本。
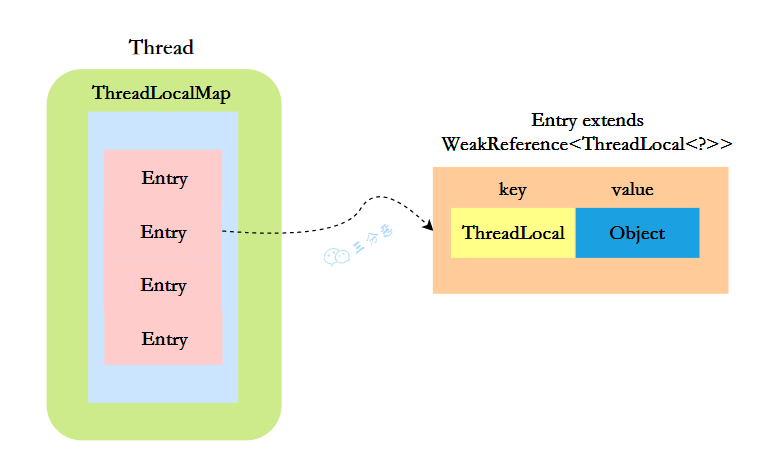
Entry 继承了 WeakReference,它限定了 key 是一个弱引用,弱引用的好处是当内存不足时,JVM 会回收 ThreadLocal 对象,并且将其对应的 Entry.value 设置为 null,这样可以在很大程度上避免内存泄漏。
static class Entry extends WeakReference<ThreadLocal<?>> {
    /** The value associated with this ThreadLocal. */
    Object value;

    //节点类
    Entry(ThreadLocal<?> k, Object v) {
        //key赋值
        super(k);
        //value赋值
        value = v;
    }
}总结一下:
ThreadLocal 的实现原理是,每个线程维护一个 Map,key 为 ThreadLocal 对象,value 为想要实现线程隔离的对象。
1、通过 ThreadLocal 的 set 方法将对象存入 Map 中。
2、通过 ThreadLocal 的 get 方法从 Map 中取出对象。
3、Map 的大小由 ThreadLocal 对象的多少决定。
什么是弱引用,什么是强引用?
我先说一下强引用,比如 User user = new User("沉默王二") 中,user 就是一个强引用,new User("沉默王二") 就是强引用对象。
当 user 被置为 null 时(user = null),new User("沉默王二") 对象就会被垃圾回收;否则即便是内存空间不足,JVM 也不会回收 new User("沉默王二") 这个强引用对象,宁愿抛出 OutOfMemoryError。
弱引用,比如说在使用 ThreadLocal 中,Entry 的 key 就是一个弱引用对象。
ThreadLocal<User> userThreadLocal = new ThreadLocal<>();
userThreadLocal.set(new User("沉默王二"));userThreadLocal 是一个强引用,new ThreadLocal<>() 是一个强引用对象;
new User("沉默王二") 是一个强引用对象。
调用 set 方法后,会将 key = new ThreadLocal<>() 放入 ThreadLocalMap 中,此时的 key 是一个弱引用对象。当 JVM 进行垃圾回收时,如果发现了弱引用对象,就会将其回收。
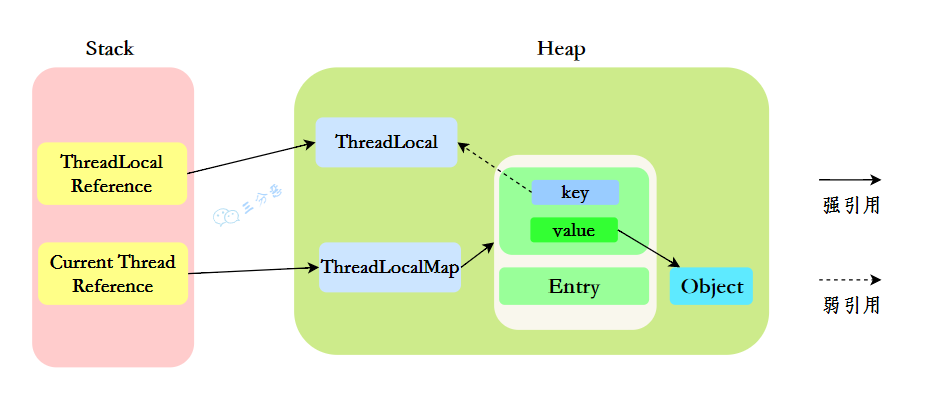
其关系链就是:
- ThreadLocal 强引用 -> ThreadLocal 对象。
- Thread 强引用 -> ThreadLocalMap。
ThreadLocalMap[i]强引用了 -> Entry。- Entry.key 弱引用 -> ThreadLocal 对象。
- Entry.value 强引用 -> 线程的局部变量对象。
memo:2025 年 02 月 01 日修改至此。
🌟15.ThreadLocal 内存泄露是怎么回事?
ThreadLocalMap 的 Key 是 弱引用,但 Value 是强引用。
如果一个线程一直在运行,并且 value 一直指向某个强引用对象,那么这个对象就不会被回收,从而导致内存泄漏。

那怎么解决内存泄漏问题呢?
很简单,使用完 ThreadLocal 后,及时调用 remove() 方法释放内存空间。
try {
    threadLocal.set(value);
    // 执行业务操作
} finally {
    threadLocal.remove(); // 确保能够执行清理
}remove() 方法会将当前线程的 ThreadLocalMap 中的所有 key 为 null 的 Entry 全部清除,这样就能避免内存泄漏问题。
private void remove(ThreadLocal<?> key) {
    Entry[] tab = table;
    int len = tab.length;
    // 计算 key 的 hash 值
    int i = key.threadLocalHashCode & (len-1);
    // 遍历数组,找到 key 为 null 的 Entry
    for (Entry e = tab[i];
            e != null;
            e = tab[i = nextIndex(i, len)]) {
        if (e.get() == key) {
            // 将 key 为 null 的 Entry 清除
            e.clear();
            expungeStaleEntry(i);
            return;
        }
    }
}

public void clear() {
    this.referent = null;
}那为什么 key 要设计成弱引用?
弱引用的好处是,当内存不足的时候,JVM 能够及时回收掉弱引用的对象。
比如说:
WeakReference key = new WeakReference(new ThreadLocal());key 是弱引用,new WeakReference(new ThreadLocal()) 是弱引用对象,当 JVM 进行垃圾回收时,只要发现了弱引用对象,就会将其回收。
一旦 key 被回收,ThreadLocalMap 在进行 set、get 的时候就会对 key 为 null 的 Entry 进行清理。
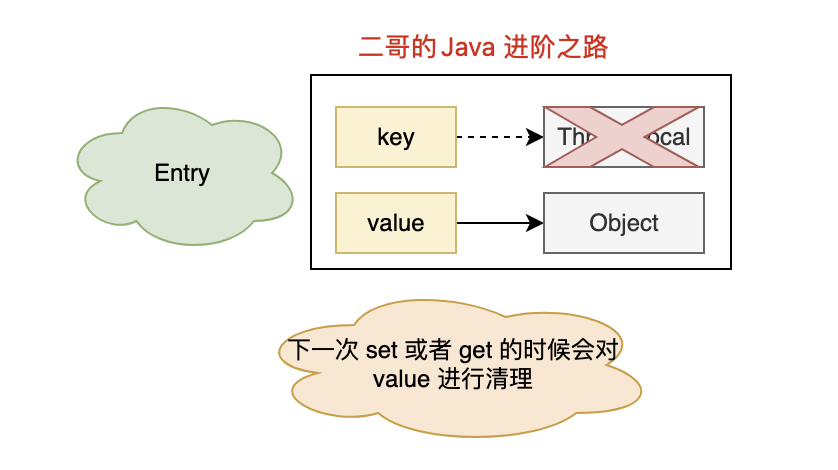
总结一下,在 ThreadLocal 被垃圾收集后,下一次访问 ThreadLocalMap 时,Java 会自动清理那些键为 null 的 entry,这个过程会在执行 get()、set()、remove()时触发。
你了解哪些 ThreadLocal 的改进方案?
在 JDK 20 Early-Access Build 28 版本中,出现了 ThreadLocal 的改进方案,即 ScopedValue。
还有 Netty 中的 FastThreadLocal,它是 Netty 对 ThreadLocal 的优化,内部维护了一个索引常量 index,每次创建 FastThreadLocal 中都会自动+1,用来取代 hash 冲突带来的损耗,用空间换时间。
private final int index;

public FastThreadLocal() {
    index = InternalThreadLocalMap.nextVariableIndex();
}
public static int nextVariableIndex() {
    int index = nextIndex.getAndIncrement();
    if (index < 0) {
        nextIndex.decrementAndGet();
    }
    return index;
}以及阿里的 TransmittableThreadLocal,不仅实现了子线程可以继承父线程 ThreadLocal 的功能,并且还可以跨线程池传递值。
TransmittableThreadLocal<String> context = new TransmittableThreadLocal<>();

// 在父线程中设置
context.set("value-set-in-parent");

// 在子线程中可以读取,值是"value-set-in-parent"
String value = context.get();memo:2025 年 02 月 02 日修改至此。
16.ThreadLocalMap 的源码看过吗?
有研究过。
ThreadLocalMap 虽然被叫做 Map,但它并没有实现 Map 接口,是一个简单的线性探测哈希表。
static class ThreadLocalMap {
    static class Entry extends WeakReference<ThreadLocal<?>> {
        Object value;

        Entry(ThreadLocal<?> k, Object v) {
            super(k);  // 这里的 Key 是 WeakReference
            value = v;
        }
    }

    private Entry[] table;  // 存储 ThreadLocal 变量的数组
    private int size;       // 当前 Entry 数量
    private int threshold;  // 触发扩容的阈值
}底层的数据结构也是数组,数组中的每个元素是一个 Entry 对象,Entry 对象继承了 WeakReference,key 是 ThreadLocal 对象,value 是线程的局部变量。
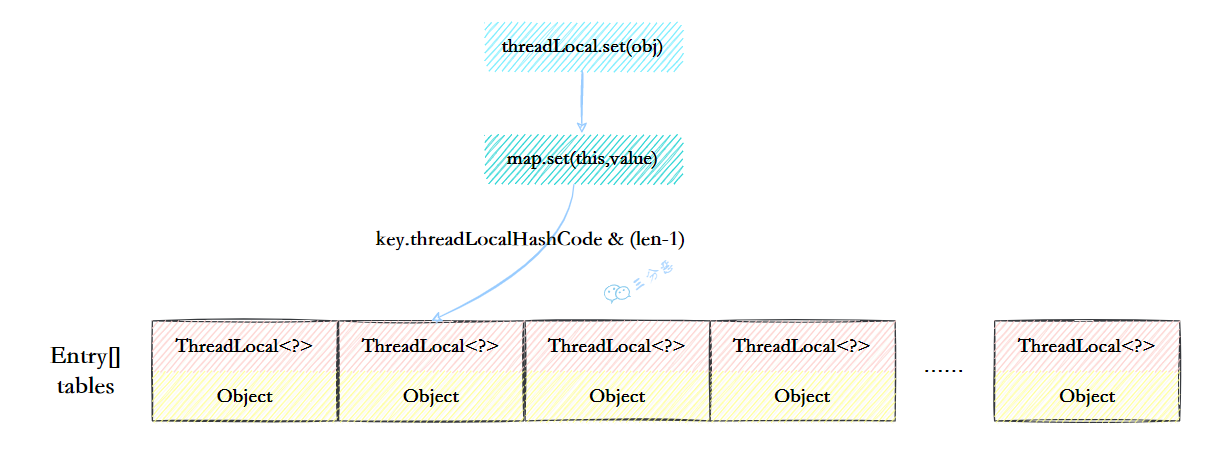
当调用 ThreadLocal.set(value) 时,会将 value 存入 ThreadLocalMap。
public void set(T value) {
    Thread t = Thread.currentThread();
    ThreadLocalMap map = getMap(t);
    if (map != null) {
        map.set(this, value);
    } else {
        createMap(t, value);
    }
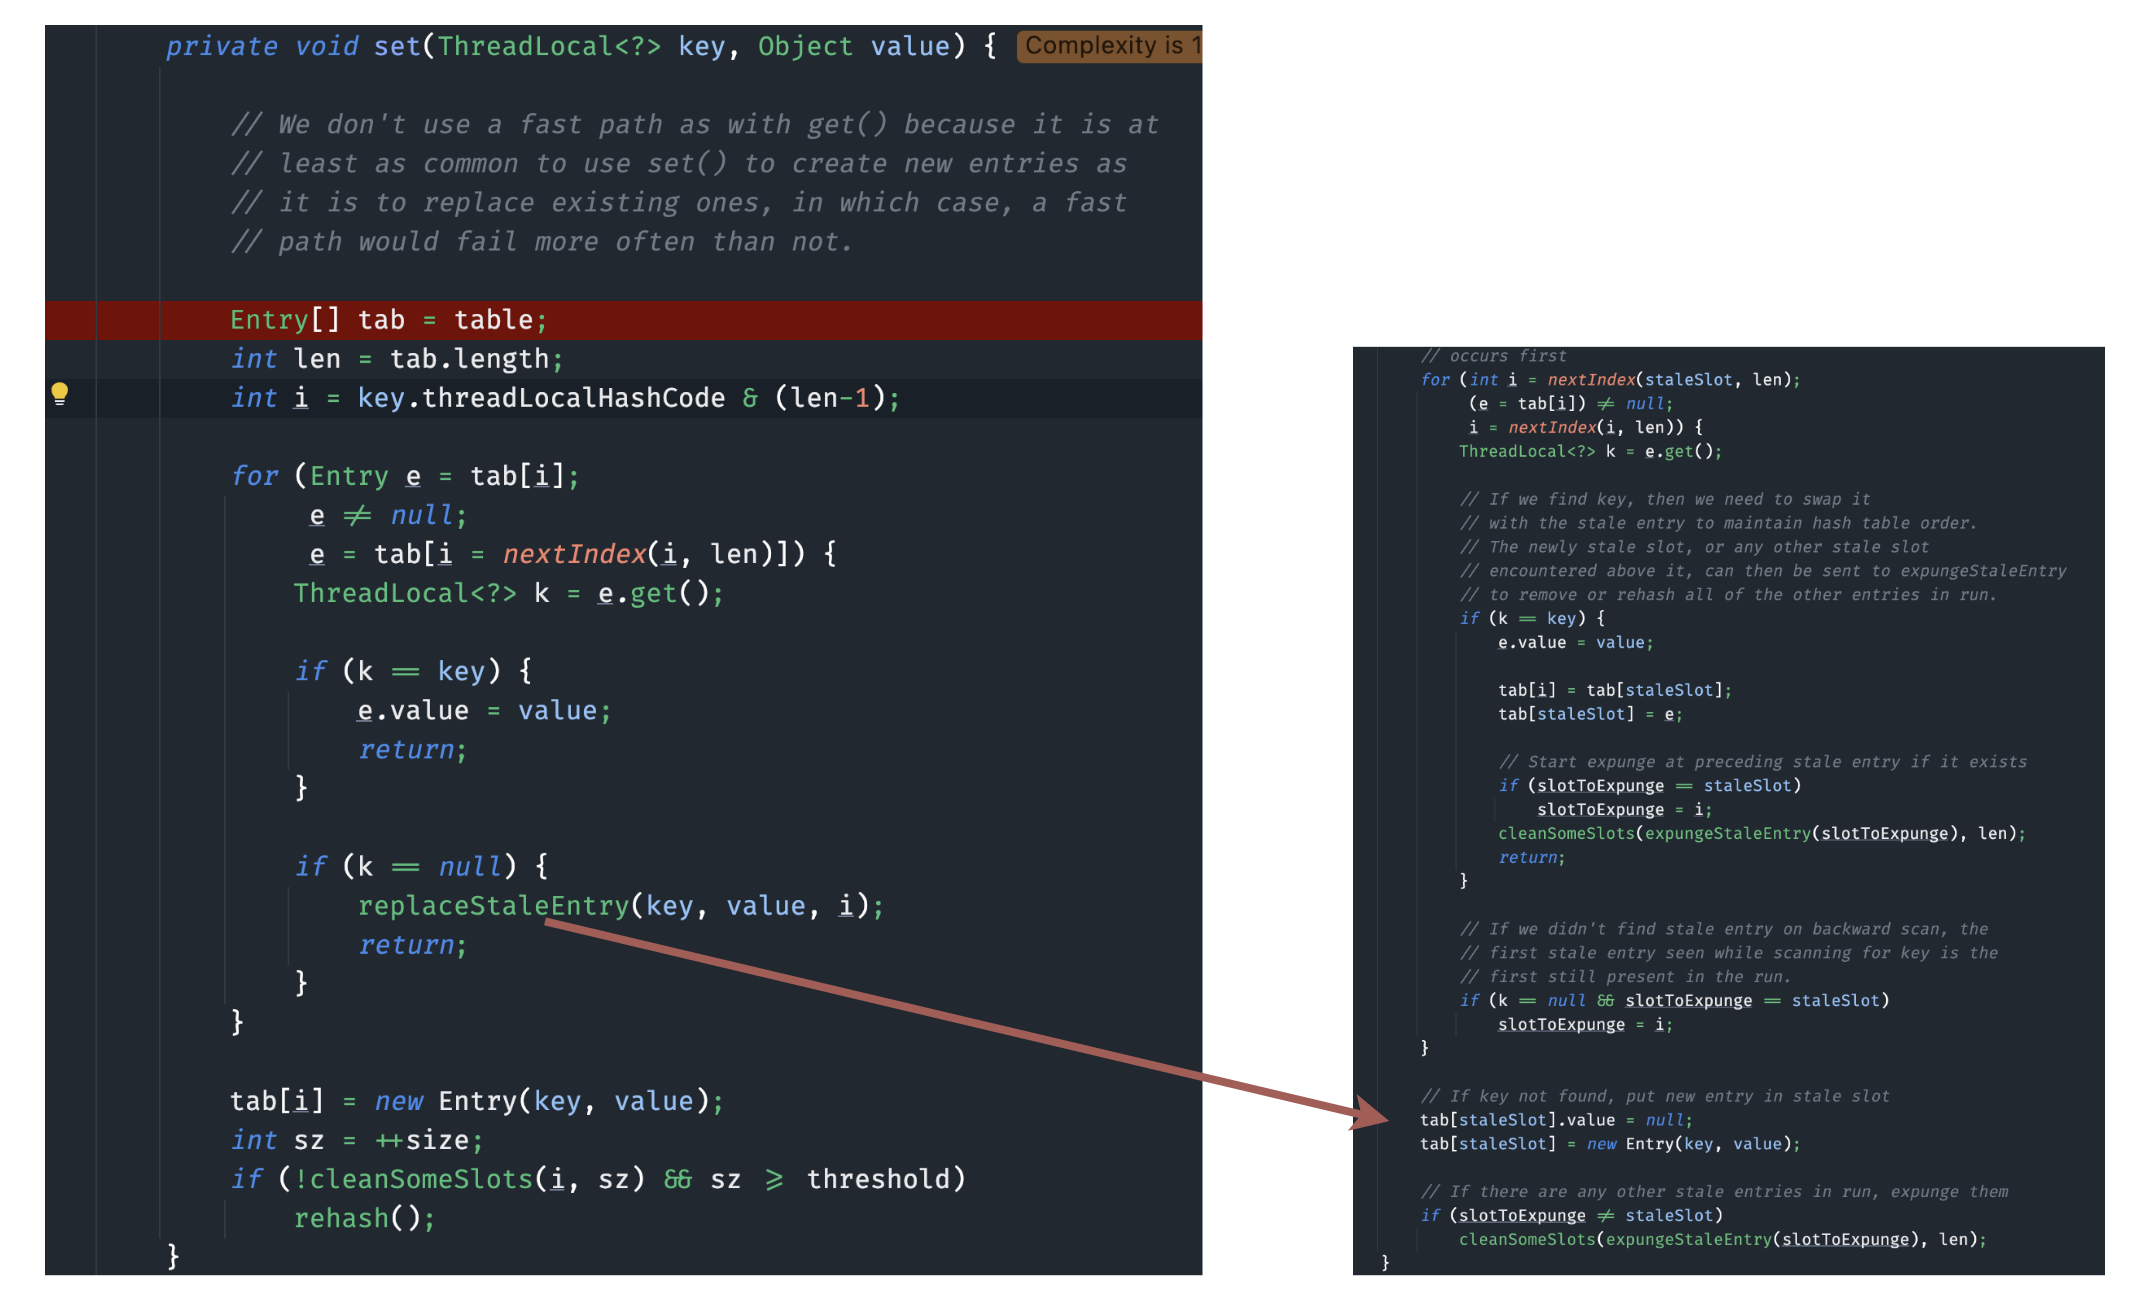
}set() 方法是 ThreadLocalMap 的核心方法,通过 key 的哈希码与数组长度取模,计算出 key 在数组中的位置,这一点和 HashMap 的实现类似。
private void set(ThreadLocal<?> key, Object value) {
    Entry[] tab = table;
    int len = tab.length;
    int i = key.threadLocalHashCode & (len - 1); // 计算索引

    for (Entry e = tab[i]; e != null; e = tab[nextIndex(i, len)]) {
        ThreadLocal<?> k = e.get();
        if (k == key) { // 如果 key 已存在,更新 value
            e.value = value;
            return;
        }
        if (k == null) { // Key 为 null,清理无效 Entry
            replaceStaleEntry(key, value, i);
            return;
        }
    }

    tab[i] = new Entry(key, value); // 直接插入 Entry
    size++;
    if (size >= threshold) {
        rehash();
    }
}threadLocalHashCode 的计算有点东西,每创建一个 ThreadLocal 对象,它就会新增一个黄金分割数,可以让哈希码分布的非常均匀。
private static final int HASH_INCREMENT = 0x61c88647;

private static int nextHashCode() {
    return nextHashCode.getAndAdd(HASH_INCREMENT);
}当调用 ThreadLocal.get() 时,会调用 ThreadLocalMap 的 getEntry() 方法,根据 key 的哈希码找到对应的线程局部变量。
private Entry getEntry(ThreadLocal<?> key) {
    int i = key.threadLocalHashCode & (table.length - 1);
    Entry e = table[i];

    if (e != null && e.get() == key) { // 如果 key 存在,直接返回
        return e;
    } else {
        return getEntryAfterMiss(key, i, e); // 继续查找
    }
}当调用 ThreadLocal.remove() 时,会调用 ThreadLocalMap 的 remove() 方法,根据 key 的哈希码找到对应的线程局部变量,将其清除,防止内存泄漏。
private void remove(ThreadLocal<?> key) {
    Entry[] tab = table;
    int len = tab.length;
    int i = key.threadLocalHashCode & (len - 1);

    for (Entry e = tab[i]; e != null; e = tab[nextIndex(i, len)]) {
        if (e.get() == key) {
            e.clear(); // 清除 WeakReference
            e.value = null; // 释放 Value
            expungeStaleEntries();
            return;
        }
    }
}17.ThreadLocalMap 怎么解决 Hash 冲突的?
开放定址法。
如果计算得到的槽位 i 已经被占用,ThreadLocalMap 会采用开放地址法中的线性探测来寻找下一个空闲槽位:
如果 i 位置被占用,尝试 i+1。
如果 i+1 也被占用,继续探测 i+2,直到找到一个空位。
如果到达数组末尾,则回到数组头部,继续寻找空位。
private static int nextIndex(int i, int len) {
    return ((i + 1 < len) ? i + 1 : 0);
}为什么要用线性探测法而不是 HashMap 的拉链法来解决哈希冲突?
ThreadLocalMap 设计的目的是存储线程私有数据,不会有大量的 Key,所以采用线性探测更节省空间。
拉链法还需要单独维护一个链表,甚至红黑树,不适合 ThreadLocal 这种场景。
开放地址法了解吗?
简单来说,就是这个坑被人占了,那就接着去找空着的坑。
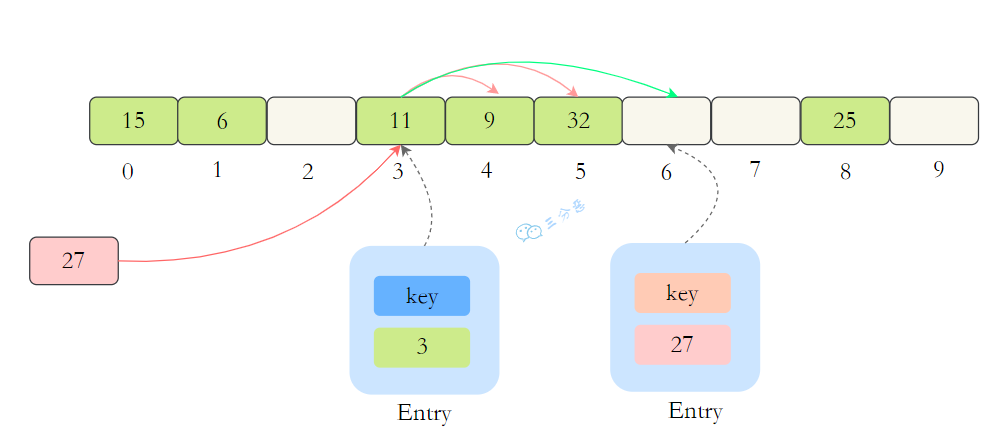
如果我们插入一个 value=27 的数据,通过 hash 计算后应该落入第 4 个槽位,而槽位 4 已经有数据了,而且 key 和当前的不等。
此时就会线性向后查找,一直找到 Entry 为 null 的槽位才会停止。
memo:2025 年 02 月 03 日修改至此。
18.ThreadLocalMap 扩容机制了解吗?
了解。
与 HashMap 不同,ThreadLocalMap 并不会直接在元素数量达到阈值时立即扩容,而是先清理被 GC 回收的 key,然后在填充率达到四分之三时进行扩容。
private void rehash() {
    // 清理被 GC 回收的 key
    expungeStaleEntries();

    //扩容
    if (size >= threshold - threshold / 4)
        resize();
}清理过程会遍历整个数组,将 key 为 null 的 Entry 清除。
private void expungeStaleEntries() {
    Entry[] tab = table;
    int len = tab.length;
    for (int j = 0; j < len; j++) {
        Entry e = tab[j];
        // 如果 key 为 null,清理 Entry
        if (e != null && e.get() == null)
            expungeStaleEntry(j);
    }
}阈值 threshold 的默认值是数组长度的三分之二。
private void setThreshold(int len) {
    threshold = len * 2 / 3;
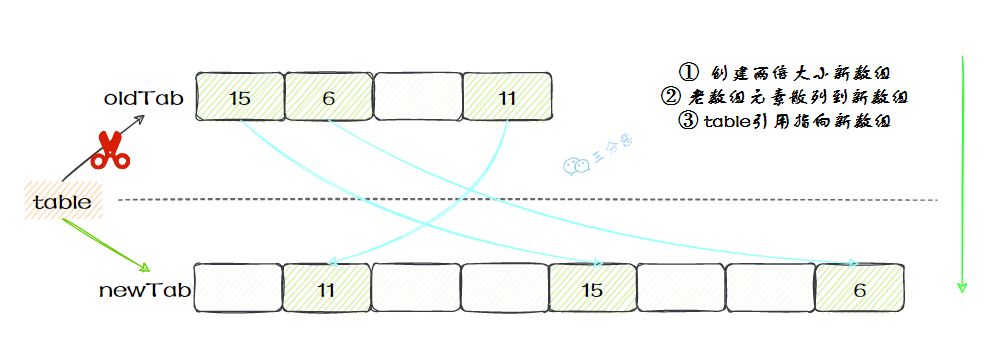
}扩容时,会将数组长度翻倍,然后重新计算每个 Entry 的位置,采用线性探测法来寻找新的空位,然后将 Entry 放入新的数组中。
private void resize() {
    Entry[] oldTab = table;
    int oldLen = oldTab.length;
    // 扩容为原来的两倍
    int newLen = oldLen * 2;
    Entry[] newTab = new Entry[newLen];

    int count = 0;
    // 遍历老数组
    for (int j = 0; j < oldLen; ++j) {
        Entry e = oldTab[j];
        if (e != null) {
            ThreadLocal<?> k = e.get();
            if (k == null) {
                e.value = null; // 释放 Value,防止内存泄漏
            } else {
                // 重新计算位置
                int h = k.threadLocalHashCode & (newLen - 1);
                while (newTab[h] != null) {
                    // 线性探测寻找新位置
                    h = nextIndex(h, newLen);
                }
                // 放入新数组
                newTab[h] = e;
                count++;
            }
        }
    }
    table = newTab;
    size = count;
    threshold = newLen * 2 / 3; // 重新计算扩容阈值
}一句话总结:ThreadLocalMap 采用的是“先清理再扩容”的策略,扩容时,数组长度翻倍,并重新计算索引,如果发生哈希冲突,采用线性探测法来解决。
19.父线程能用 ThreadLocal 给子线程传值吗?
不能。
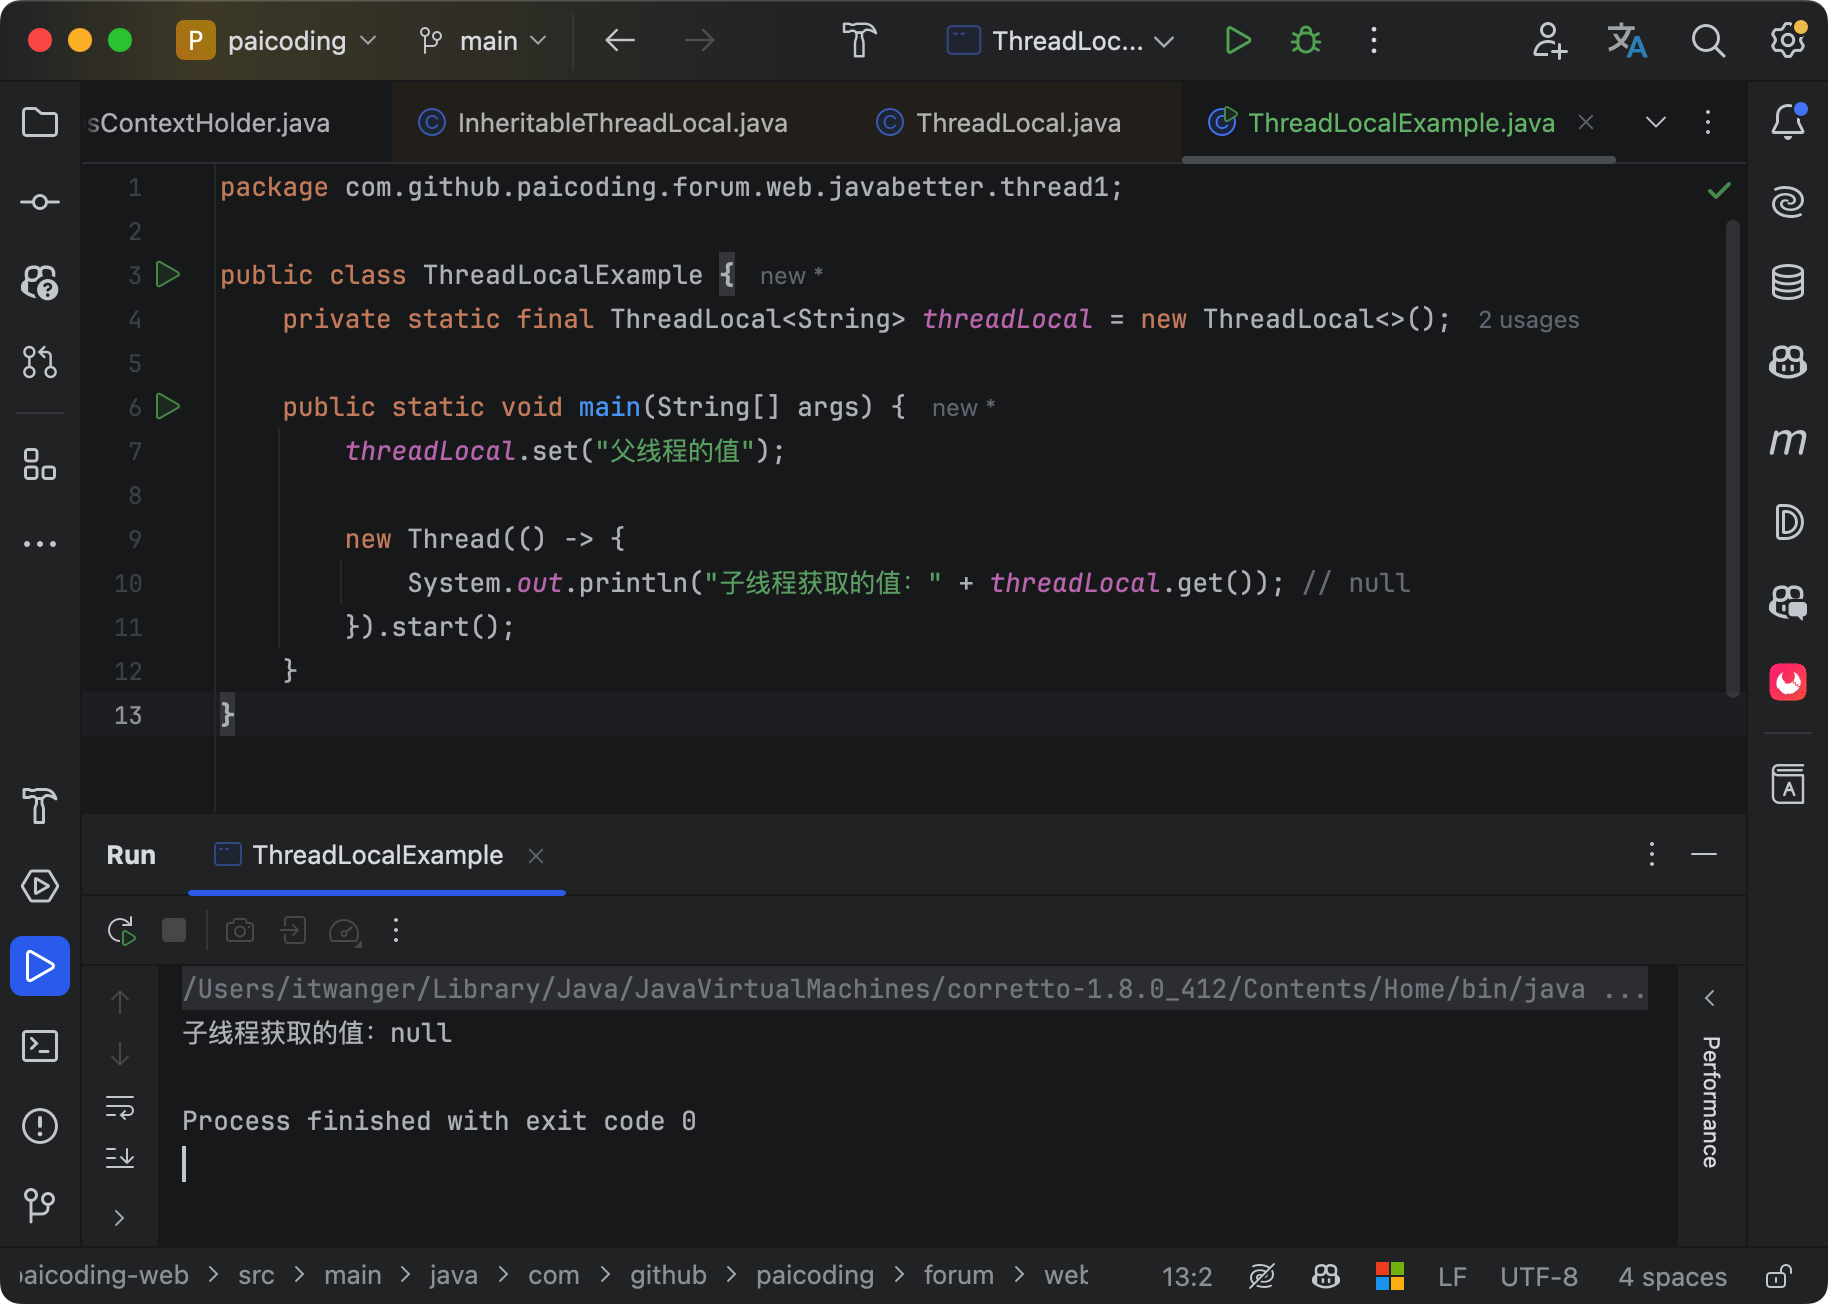
因为 ThreadLocal 变量存储在每个线程的 ThreadLocalMap 中,而子线程不会继承父线程的 ThreadLocalMap。
可以使用 InheritableThreadLocal来解决这个问题。
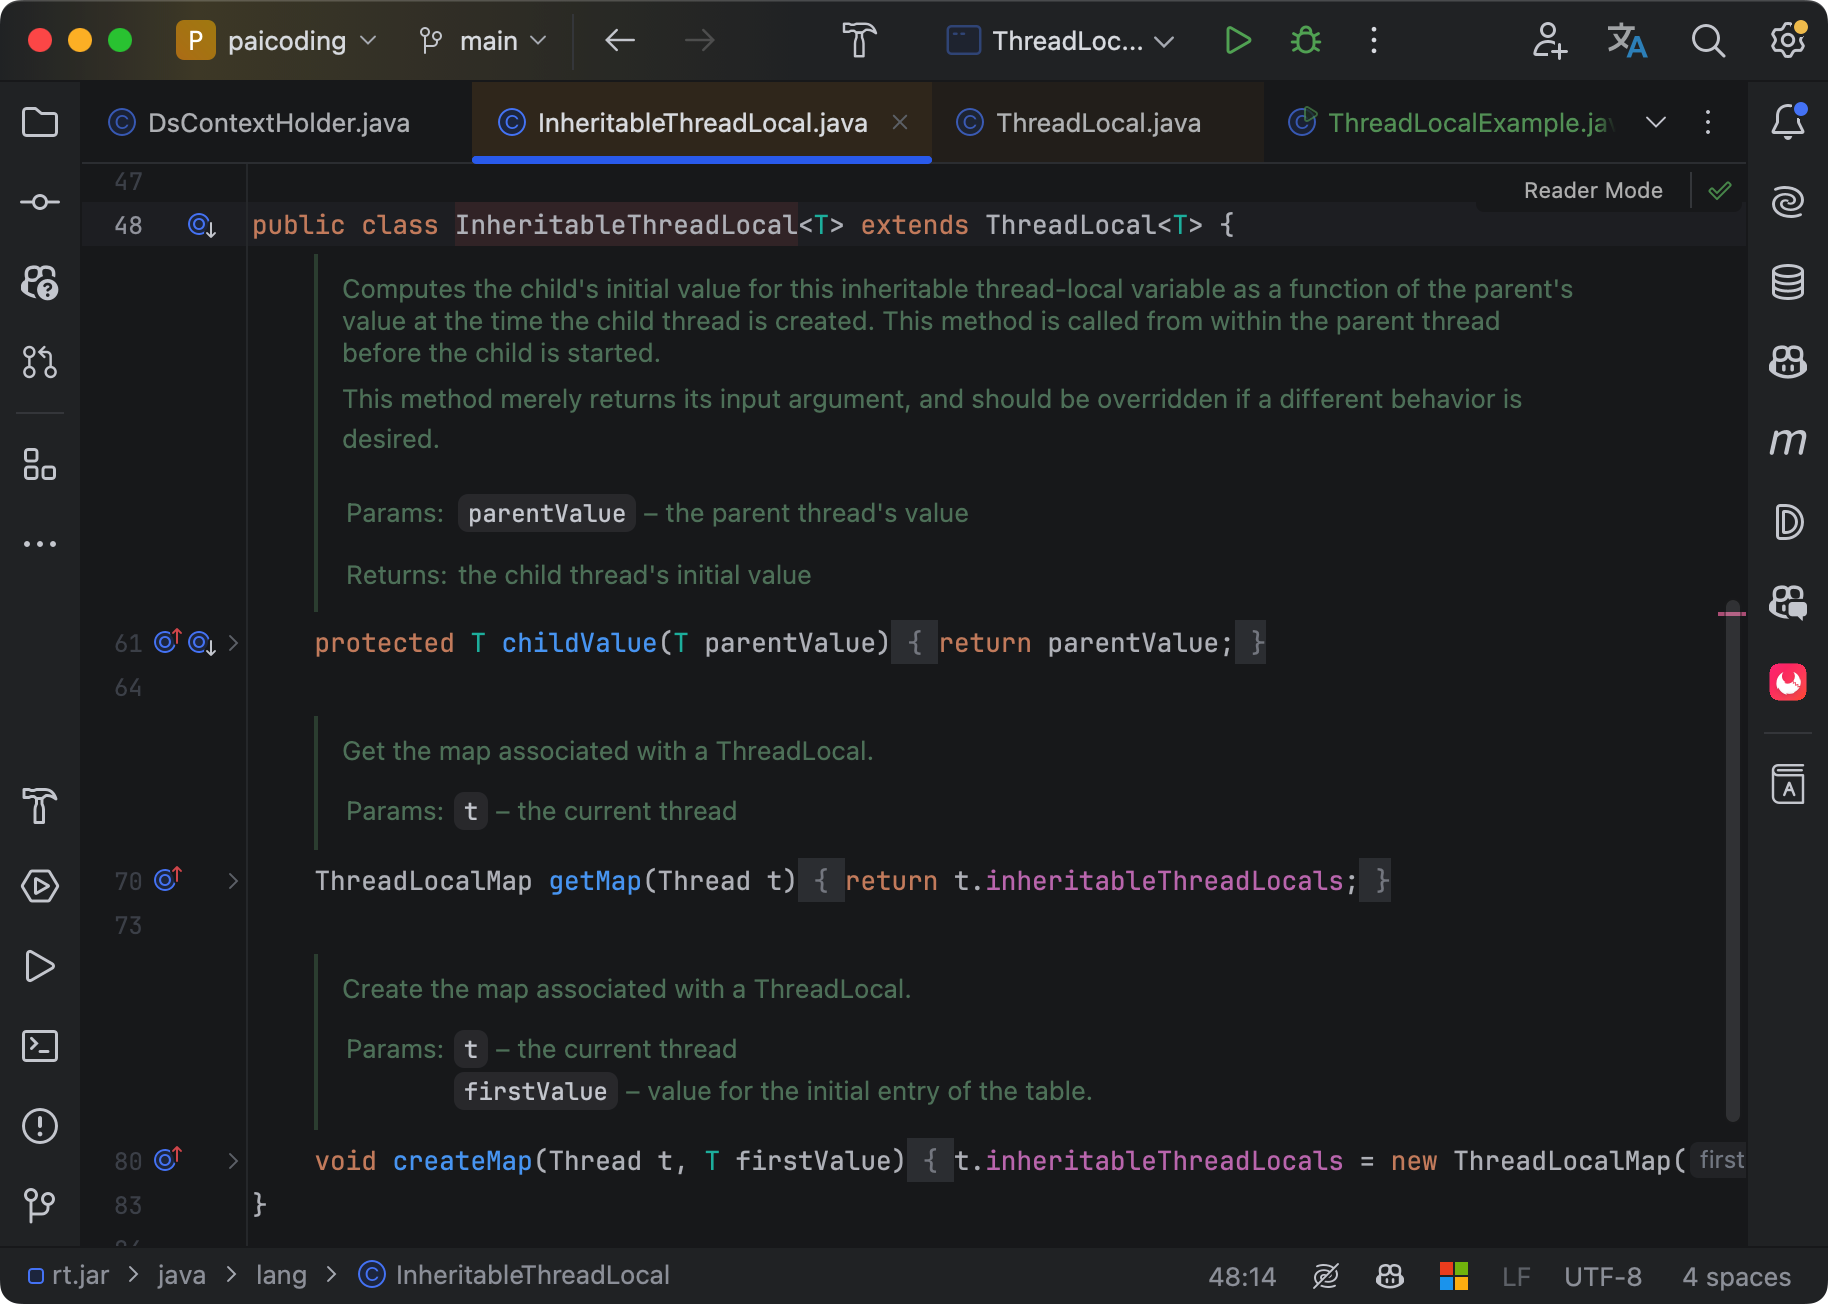
子线程在创建的时候会拷贝父线程的 InheritableThreadLocal 变量。
来看一下使用示例:
class InheritableThreadLocalExample {
    private static final InheritableThreadLocal<String> inheritableThreadLocal = new InheritableThreadLocal<>();

    public static void main(String[] args) {
        inheritableThreadLocal.set("父线程的值");

        new Thread(() -> {
            System.out.println("子线程获取的值:" + inheritableThreadLocal.get()); // 继承了父线程的值
        }).start();
    }
}InheritableThreadLocal 的原理了解吗?
了解。
在 Thread 类的定义中,每个线程都有两个 ThreadLocalMap:
public class Thread {
    /* 普通 ThreadLocal 变量存储的地方 */
    ThreadLocal.ThreadLocalMap threadLocals = null;

    /* InheritableThreadLocal 变量存储的地方 */
    ThreadLocal.ThreadLocalMap inheritableThreadLocals = null;
}普通 ThreadLocal 变量存储在 threadLocals 中,不会被子线程继承。
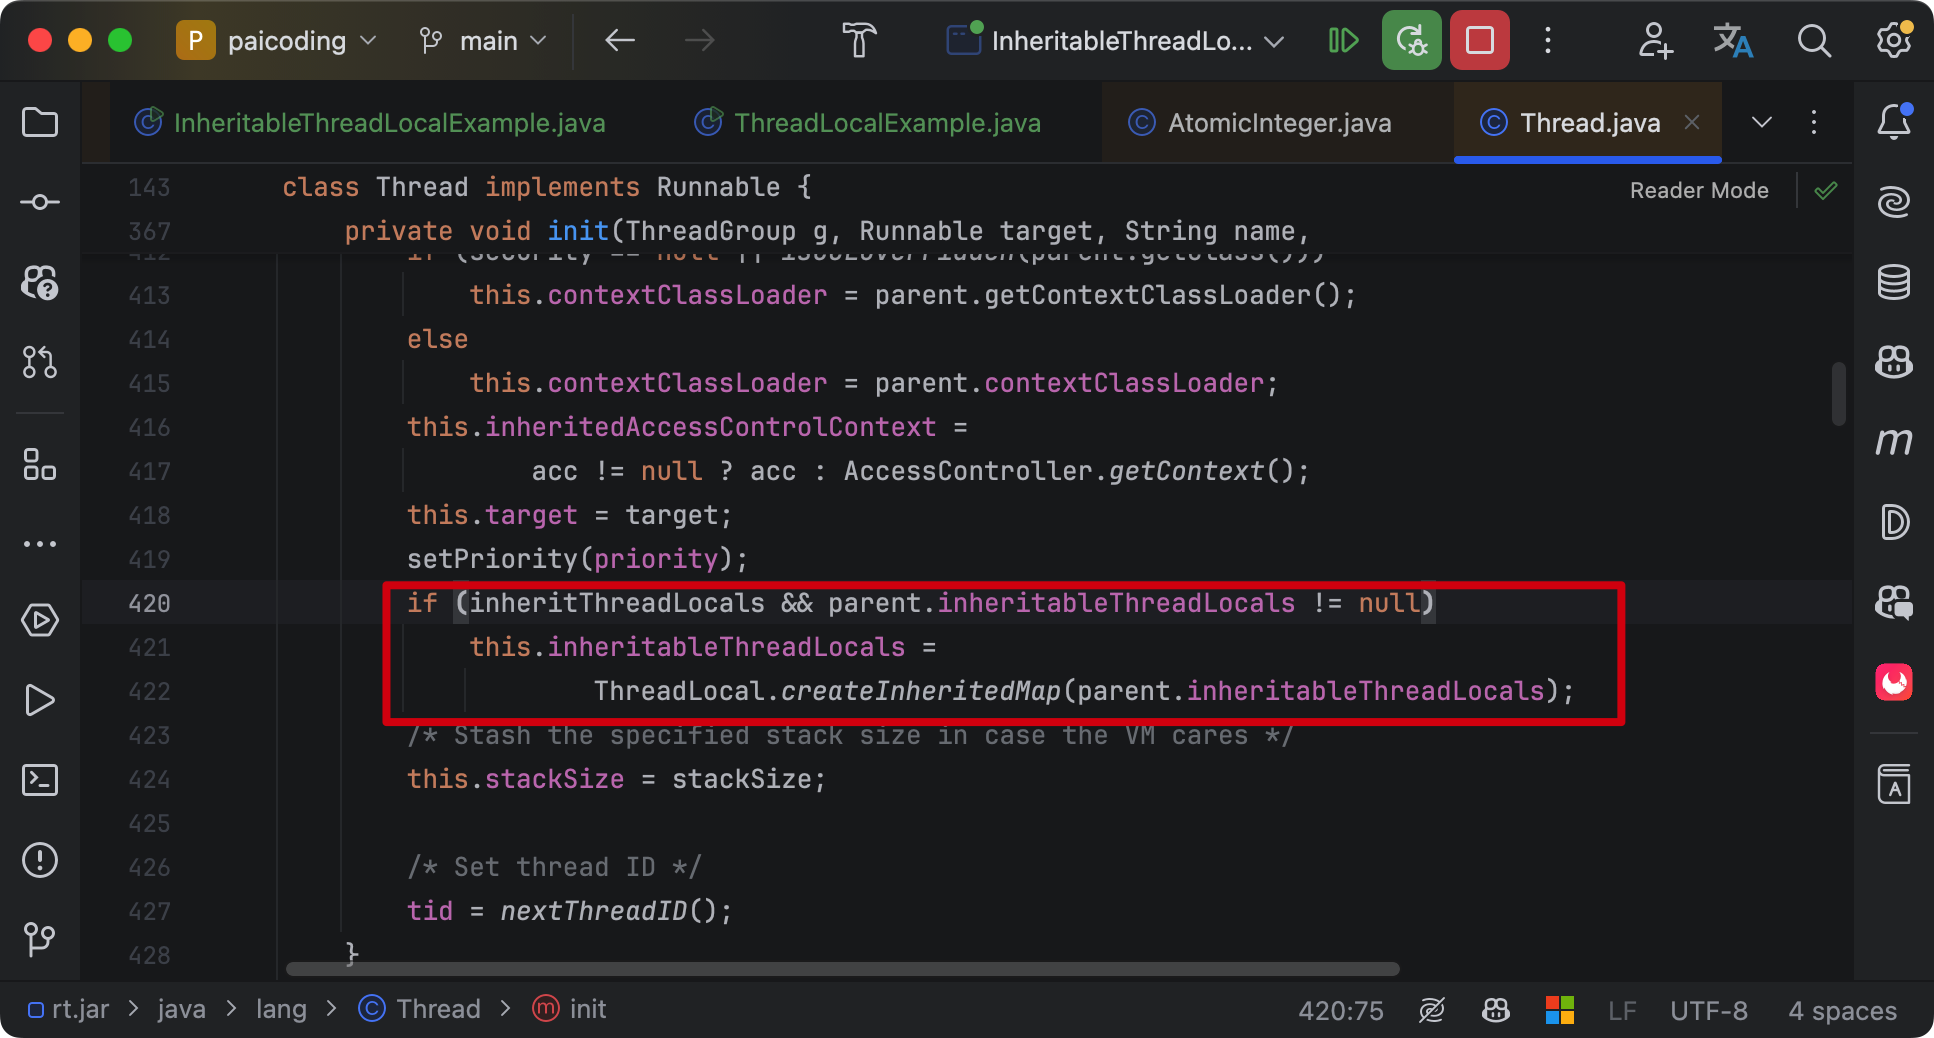
InheritableThreadLocal 变量存储在 inheritableThreadLocals 中,当 new Thread() 创建一个子线程时,Thread 的 init() 方法会检查父线程是否有 inheritableThreadLocals,如果有,就会拷贝 InheritableThreadLocal 变量到子线程:
private void init(ThreadGroup g, Runnable target, String name, long stackSize) {
    // 获取当前父线程
    Thread parent = currentThread();
    // 复制 InheritableThreadLocal 变量
    if (parent.inheritableThreadLocals != null) {
        this.inheritableThreadLocals =
            ThreadLocal.createInheritedMap(parent.inheritableThreadLocals);
    }
}memo:2025 年 02 月 04 日修改至此。
Java 内存模型
🌟20.说一下你对 Java 内存模型的理解?
推荐阅读:说说 Java 的内存模型
Java 内存模型是 Java 虚拟机规范中定义的一个抽象模型,用来描述多线程环境中共享变量的内存可见性。
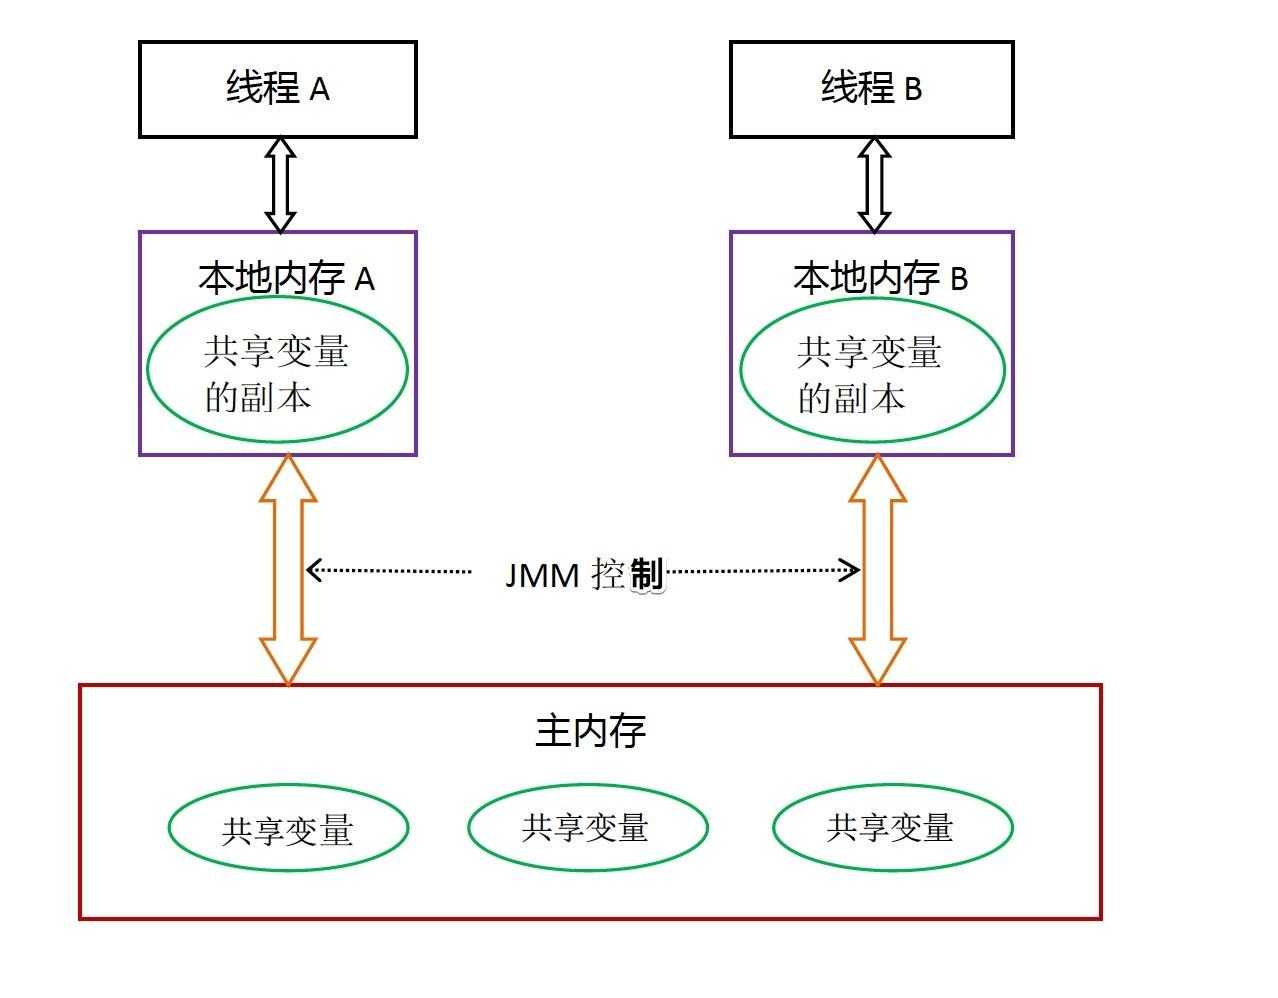
共享变量存储在主内存中,每个线程都有一个私有的本地内存,存储了共享变量的副本。
- 当一个线程更改了本地内存中共享变量的副本,它需要 JVM 刷新到主内存中,以确保其他线程可以看到这些更改。
- 当一个线程需要读取共享变量时,它一版会从本地内存中读取。如果本地内存中的副本是过时的,JVM 会将主内存中的共享变量最新值刷新到本地内存中。
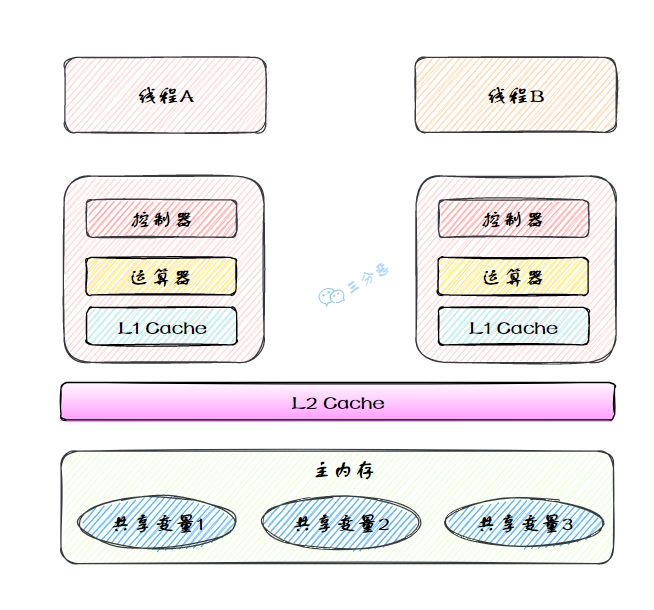
为什么线程要用自己的内存?
线程从主内存拷贝变量到工作内存,可以减少 CPU 访问 RAM 的开销。
每个线程都有自己的变量副本,可以避免多个线程同时修改共享变量导致的数据冲突。
memo:2025 年 02 月 05 日修改至此。
21. i++是原子操作吗?
不是,它包括三个步骤:
- 从内存中读取 i 的值。
- 对 i 进行加 1 操作。
- 将新的值写回内存。
说说你对原子性、可见性、有序性的理解?
原子性要求一个操作是不可分割的,要么全部执行成功,要么完全不执行。
举个例子:就比如说 count++ 就不是一个原子操作,它包括读取 count 的值、加 1、写回 count 三个步骤,所以需要加锁或者使用AtomicInteger代替 int 来保证原子性。
可见性要求一个线程对共享变量的修改,能够被其他线程及时看见。
我通过下面的代码解释一下:
private static boolean flag = true;

public static void main(String[] args) {
    new Thread(() -> {
        while (flag) {} // 线程 A 可能一直看不到 flag=false
        System.out.println("线程 A 退出");
    }).start();

    try { Thread.sleep(1000); } catch (InterruptedException e) {}

    flag = false; // 线程 B 修改 flag
}线程 A 会在本地内存中缓存 flag=true,虽然线程 B 修改了 flag=false,但不会立即同步到主内存以及线程 A 的本地内存,因此线程 A 会一直处于死循环。
解决办法就是通过 volatile 关键字来保证可见性。
有序性是指程序执行的顺序是否按照代码编写的顺序执行。
在单线程环境下,代码能够准确无误地按照编写顺序执行。但在多线程环境下,CPU 和编译器可能会进行指令重排,代码的执行顺序因此会发生变化。
我通过下面的代码解释一下:
int a = 0, b = 0;
boolean flag = false;

void thread1() {
    a = 1;
    flag = true; // 可能会被 CPU 优化,先执行
}

void thread2() {
    if (flag) {
        System.out.println(a); // 可能打印 0,而不是 1
    }
}由于指令重排,flag = true 可能会在 a = 1 之前执行,导致 thread2() 读取 flag=true 后,a 仍然是 0,出现不符合代码逻辑的情况。
简要回答:
原子性保证操作不可中断,可见性保证变量修改后线程能看到最新值,有序性保证代码执行顺序一致,可以通过 volatile、synchronized 和 CAS 机制来保证这些特性。
下面的代码是原子操作吗?
int i = 2;
int j = i;
i++;
i = i + 1;- 第 1 行代码是基本类型赋值,是原子性操作。
- 第 2 行先读 i 的值,再赋值给 j,不是原子操作。
- 第 3 和第 4 行都不是原子操作,都需要先读取 i 的值,再+1,然后再赋值给 i。
- Java 面试指南(付费)收录的京东同学 4 云实习面试原题:i++是原子操作吗
22.说说什么是指令重排?
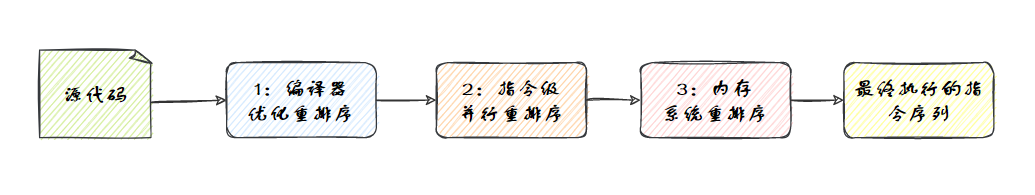
指令重排是指 CPU 或编译器为了提高程序的执行效率,改变代码执行顺序的一种优化技术。
从 Java 源代码到最终执行的指令序列,会经历 3 种重排序:编译器重排序、指令并行重排序、内存系统重排序。
指令重排可能会导致双重检查锁失效,比如下面的单例模式代码:
public class Singleton {
    private static Singleton instance;

    public static Singleton getInstance() {
        if (instance == null) { // 第一次检查
            synchronized (Singleton.class) {
                if (instance == null) { // 第二次检查
                    instance = new Singleton(); // 可能发生指令重排
                }
            }
        }
        return instance;
    }
}如果线程 A 执行了 instance = new Singleton();,但构造方法还没执行完,线程 B 可能会读取到一个未初始化的对象,导致出现空指针异常。
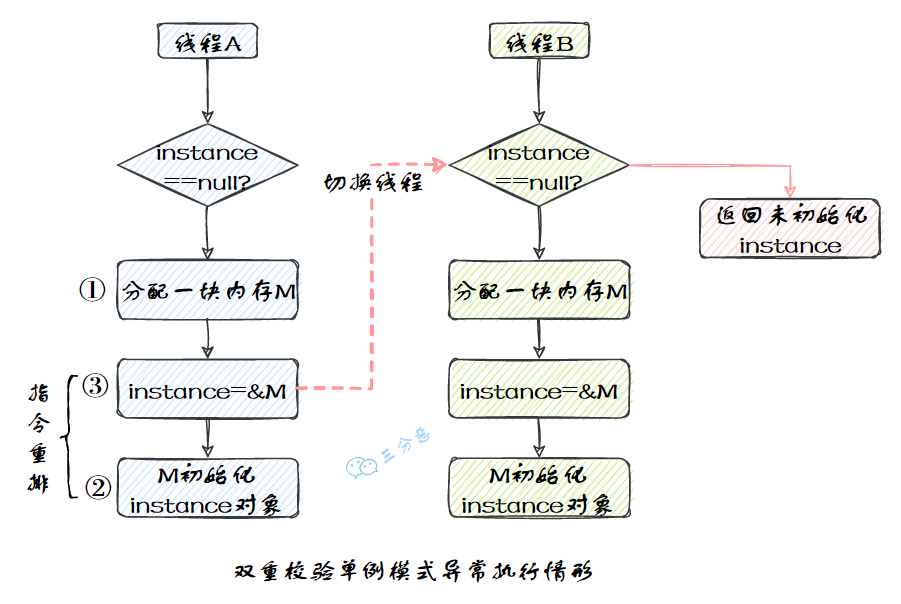
正确的方式是给 instance 变量加上 volatile 关键字,禁止指令重排。
class Singleton {
    private static volatile Singleton instance;

    public static Singleton getInstance() {
        if (instance == null) {
            synchronized (Singleton.class) {
                if (instance == null) {
                    instance = new Singleton(); // 由于 volatile,禁止指令重排
                }
            }
        }
        return instance;
    }
}memo:2025 年 02 月 06 日修改至此。
23.happens-before 了解吗?
Happens-Before 是 Java 内存模型定义的一种保证线程间可见性和有序性的规则。
如果操作 A Happens-Before 操作 B,那么:
- 操作 A 的结果对操作 B 可见。
- 操作 A 在时间上先于操作 B 执行。
换句话说,如果 A Happens-Before B,那么 A 的修改必须对 B 可见,并且 B 不能重排序到 A 之前。
你知道哪些 Happens-Before 规则?

JMM 规定了 6 种 Happens-Before 规则,满足这些规则的操作不会被重排序,并且保证了数据的可见性。
①、程序顺序规则:单线程内,代码按顺序执行;比如 a = 1; b = 2;,a 先于 b 执行。
②、监视器锁定规则:unlock() Happens-Before lock();比如 synchronized 释放锁后,获取锁的线程能够看到最新的数据。
③、volatile 变量规则:写 volatile 变量 Happens-Before 读 volatile。
④、传递性规则:A Happens-Before B 且 B Happens-Before C,则 A Happens-Before C。例如 a = 1 先于 b = 2,b = 2 先于 c = 3,则 a = 1 先于 c = 3。
⑤、线程启动规则:线程 A 执行操作 ThreadB.start(),那么 A 线程的 ThreadB.start() 操作 happens-before 于线程 B 中的任意操作。
⑥、线程终止规则:线程的所有操作 Happens-Before Thread.join();例如 t.join(); 之后,主线程一定能看到 t 的修改。
memo:2025 年 02 月 07 日修改至此。
24.as-if-serial 了解吗?
As-If-Serial 规则允许 CPU 和编译器优化代码顺序,但不会改变单线程的执行结果。它只适用于单线程,多线程环境仍然可能发生指令重排,需要 volatile 和 synchronized 等机制来保证有序性。
来解释说明一下。
double pi = 3.14;   // A
double r = 1.0;   // B
double area = pi * r * r; // CC 依赖于 A,同时 C 也依赖着 B。
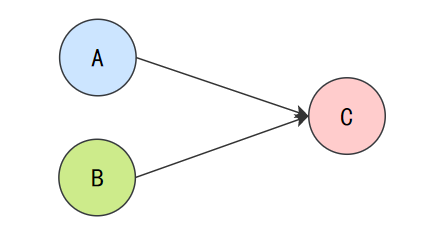
因此在最终执行的指令序列中,C 不能被重排序到 A 或者 B 的前面,否则就会出现错误。
但 A 和 B 之间没有依赖关系,因此编译器和处理器可以重排序 A 和 B 之间的执行顺序。
所以程序可能会有两种执行顺序:
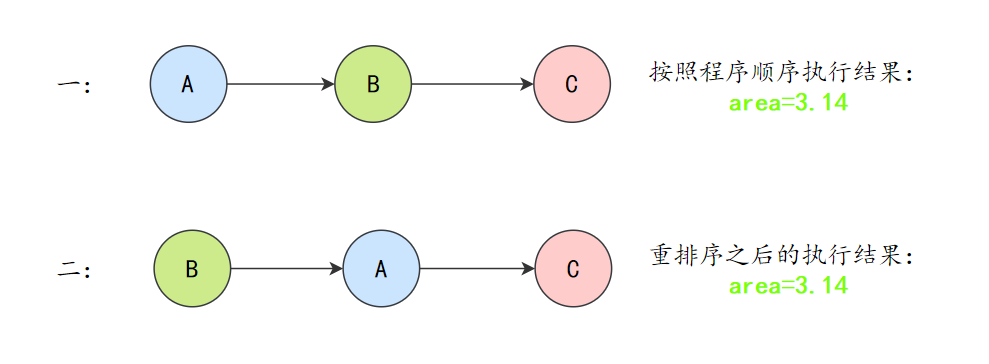
Happens-Before 规则保证了多线程环境下的有序性,防止指令重排导致的并发问题。As-If-Serial 规则保证了单线程代码不会因优化而执行错误。
25.volatile 了解吗?
推荐阅读:volatile 关键字解析
了解。
第一,保证可见性,线程修改 volatile 变量后,其他线程能够立即看到最新值;第二,防止指令重排,volatile 变量的写入不会被重排序到它之前的代码。
volatile 怎么保证可见性的?
当线程对 volatile 变量进行写操作时,JVM 会在这个变量写入之后插入一个写屏障指令,这个指令会强制将本地内存中的变量值刷新到主内存中。
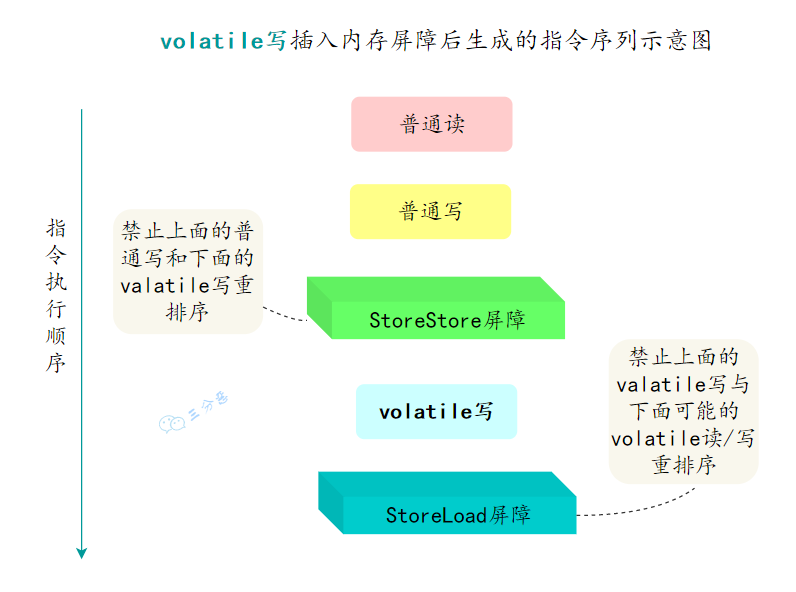
StoreStore;   // 保证写入之前的操作不会重排
volatile_write(); // 写入 volatile 变量
StoreLoad; // 保证写入后,其他线程立即可见在 x86 架构下,通常会使用 lock 指令来实现写屏障,例如:
mov [a], 2          ; 将值 2 写入内存地址 a
lock add [a], 0 ; lock 指令充当写屏障,确保内存可见性当线程对 volatile 变量进行读操作时,JVM 会插入一个读屏障指令,这个指令会强制让本地内存中的变量值失效,从而重新从主内存中读取最新的值。
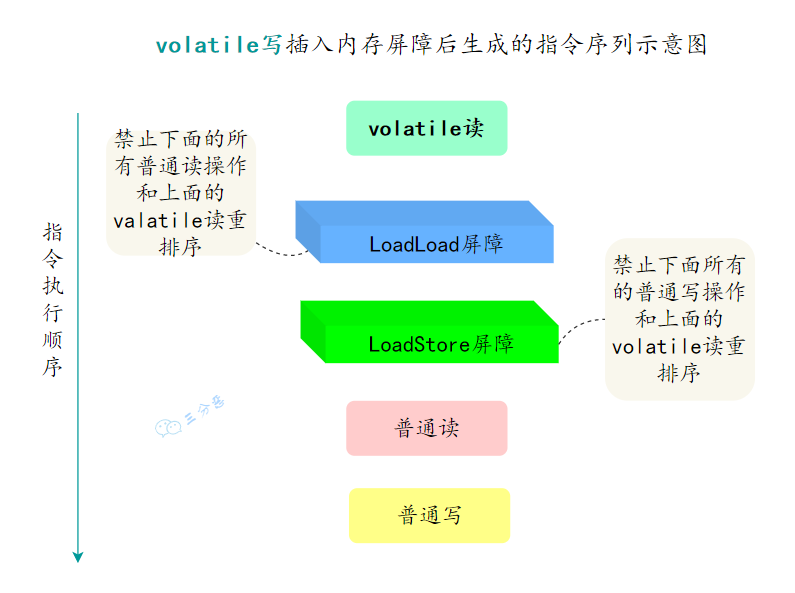
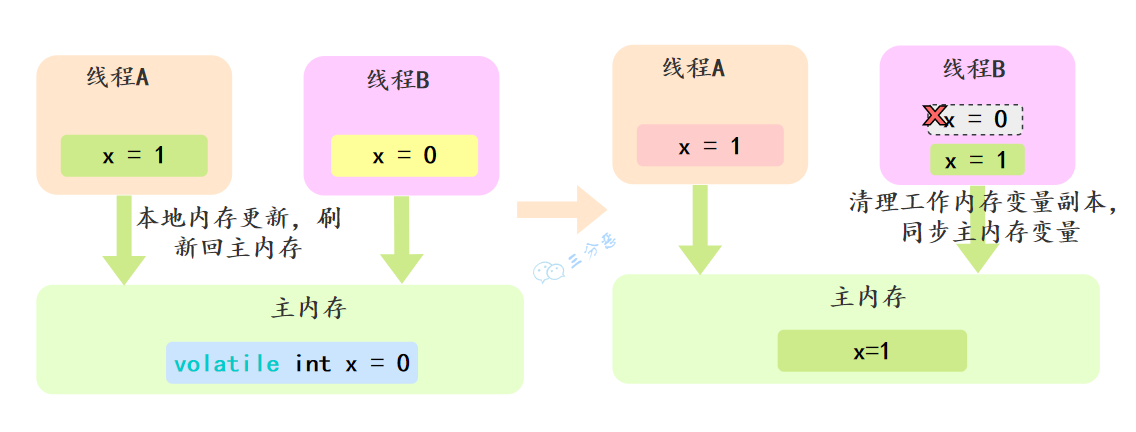
我们来声明一个 volatile 变量 x:
volatile int x = 0线程 A 对 x 写入后会将其最新的值刷新到主内存中,线程 B 读取 x 时由于本地内存中的 x 失效了,就会从主内存中读取最新的值。
volatile 怎么保证有序性的?
JVM 会在 volatile 变量的读写前后插入 “内存屏障”,以约束 CPU 和编译器的优化行为:
- StoreStore 屏障可以禁止普通写操作与 volatile 写操作的重排
- StoreLoad 屏障会禁止 volatile 写与 volatile 读重排
- LoadLoad 屏障会禁止 volatile 读与后续普通读操作重排
- LoadStore 屏障会禁止 volatile 读与后续普通写操作重排
volatile 和 synchronized 的区别?
volatile 关键字用于修饰变量,确保该变量的更新操作对所有线程是可见的,即一旦某个线程修改了 volatile 变量,其他线程会立即看到最新的值。
synchronized 关键字用于修饰方法或代码块,确保同一时刻只有一个线程能够执行该方法或代码块,从而实现互斥访问。
volatile 加在基本类型和对象上的区别?
当 volatile 用于基本数据类型时,能确保该变量的读写操作是直接从主内存中读取或写入的。
private volatile int count = 0;当 volatile 用于引用类型时,能确保引用本身的可见性,即确保引用指向的对象地址是最新的。
但是,volatile 并不能保证引用对象内部状态的线程安全。
private volatile SomeObject obj = new SomeObject();虽然 volatile 确保了 obj 引用的可见性,但对 obj 引用的 new SomeObject() 对象并不受 volatile 保护。
如果需要保证引用对象内部状态的线程安全,需要使用 synchronized 或 ReentrantLock 等锁机制。
memo:2025 年 02 月 08 日修改至此,昨天主要是做 deepseek API 技术派的集成。
锁
26.synchronized 用过吗?
用过,频率还很高。
synchronized 在 JDK 1.6 之后,进行了锁优化,增加了偏向锁、轻量级锁,大大提升了 synchronized 的性能。
synchronized 上锁的对象是什么?
synchronized 用在普通方法上时,上锁的是执行这个方法的对象。
public synchronized void increment() {
    this.count++;
}synchronized 用在静态方法上时,上锁的是这个类的 Class 对象。
public static synchronized void increment() {
    count++;
}synchronized 用在代码块上时,上锁的是括号中指定的对象,比如说当前对象 this。
public void increment() {
    synchronized (this) {
        this.count++;
    }
}
- Java 面试指南(付费)收录的 360 面经同学 3 Java 后端技术一面面试原题:说说别的你知道的关键字,比如 synchronized
27.synchronized 的实现原理了解吗?
synchronized 依赖 JVM 内部的 Monitor 对象来实现线程同步。使用的时候不用手动去 lock 和 unlock,JVM 会自动加锁和解锁。
synchronized 加锁代码块时,JVM 会通过 monitorenter、monitorexit 两个指令来实现同步:
- 前者表示线程正在尝试获取 lock 对象的 Monitor;
- 后者表示线程执行完了同步代码块,正在释放锁。
使用 javap -c -s -v -l SynchronizedDemo.class 反编译 synchronized 代码块时,就能看到这两个指令。
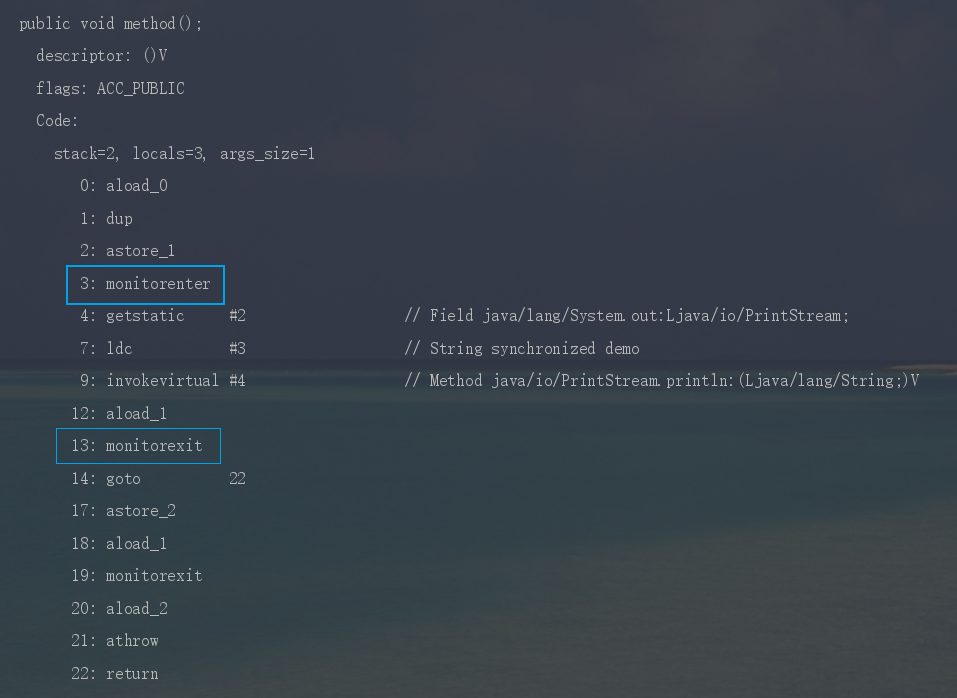
synchronized 修饰普通方法时,JVM 会通过 ACC_SYNCHRONIZED 标记符来实现同步。
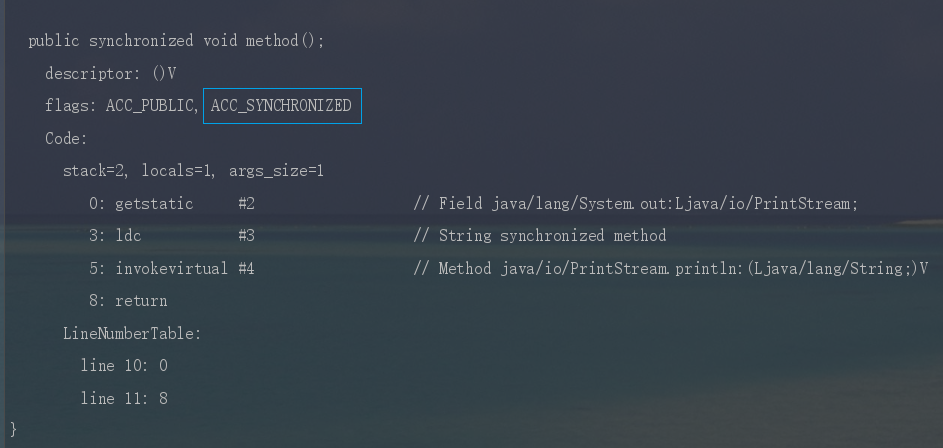
你对 Monitor 了解多少?
Monitor 是 JVM 内置的同步机制,每个对象在内存中都有一个对象头——Mark Word,用于存储锁的状态,以及 Monitor 对象的指针。
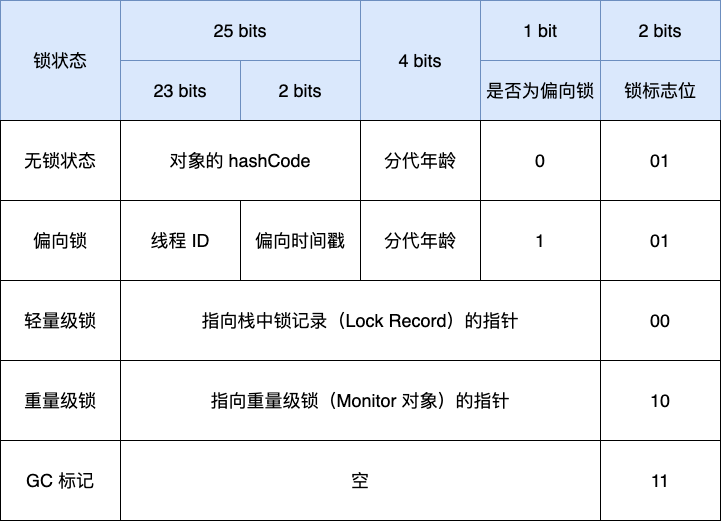
synchronized 依赖对象头的 Mark Word 进行状态管理,支持无锁、偏向锁、轻量级锁,以及重量级锁。
在 Hotspot 虚拟机中,Monitor 由 ObjectMonitor 实现:
ObjectMonitor() {
    _count        = 0; // 记录线程获取锁的次数
    _owner        = NULL;  // 指向持有ObjectMonitor对象的线程
    _WaitSet      = NULL;  // 处于wait状态的线程,会被加入到_WaitSet
    _cxq          = NULL ;
    _EntryList    = NULL ;  // 处于等待锁block状态的线程,会被加入到该列表
}- _owner:当前持有 ObjectMonitor 的线程,初始值为 null,表示没有线程持有锁。线程成功获取锁后,该值更新为线程 ID,释放锁后重置为 null。
- _count:记录当前线程获取锁的次数(可重入锁),每次成功加锁
_count + 1,释放锁_count - 1。 - _WaitSet:等待队列,调用
wait()方法后,线程会释放锁,并加入 _WaitSet,进入 WAITING 状态,等待notify()唤醒。 - _cxq:阻塞队列,用于存放刚进入 Monitor 的线程(还未进入 _EntryList)。
- _EntryList:竞争队列,所有等待获取锁的线程(BLOCKED 状态)会进入 _EntryList,等待锁释放后竞争执行权。
结构示意图:
+----------------------+
|  ObjectMonitor      |
|  ----------------   |
|  _owner = Thread-1  |  // 当前持有锁的线程
|  _count = 1         |  // 线程获取锁的次数
|  _WaitSet -> T3,T4  |  // 执行 wait() 的线程
|  _EntryList -> T2,T5|  // 竞争锁的线程
|  _cxq -> T6,T7      |  // 新进入的线程
+----------------------+会不会牵扯到 os 层面呢?
会,synchronized 升级为重量级锁时,依赖于操作系统的互斥量——mutex 来实现,mutex 用于保证任何给定时间内,只有一个线程可以执行某一段特定的代码段。
memo:2025 年 02 月 09 日修改至此。
28.synchronized 怎么保证可见性?
通过两步操作:
- 加锁时,线程必须从主内存读取最新数据。
- 释放锁时,线程必须将修改的数据刷回主内存,这样其他线程获取锁后,就能看到最新的数据。
线程 A                  线程 B
  ┌────────────────────┐
  │ synchronized(lock) │
  │    x = 1;          │  // 1. 线程 A 修改变量 x
  └────────────────────┘
        ↓ 释放锁
  (JVM 强制刷新 x 到主内存)

        (线程 B 获取锁)
  ┌────────────────────┐
  │ synchronized(lock) │
  │    print(x);       │  // 2. 线程 B 读取最新 x=1
└────────────────────┘synchronized 怎么保证有序性?
synchronized 通过 JVM 指令 monitorenter 和 monitorexit,来确保加锁代码块内的指令不会被重排。
来解释一下,比如说对于:
synchronized (lock) {
    x = 1;
    flag = true;
}javap 反编译后的伪代码:
monitorenter   // 获取锁
store x, 1     // 变量 x = 1
store flag, true  // 变量 flag = true
monitorexit // 释放锁实际 javap 反编译后的结果:
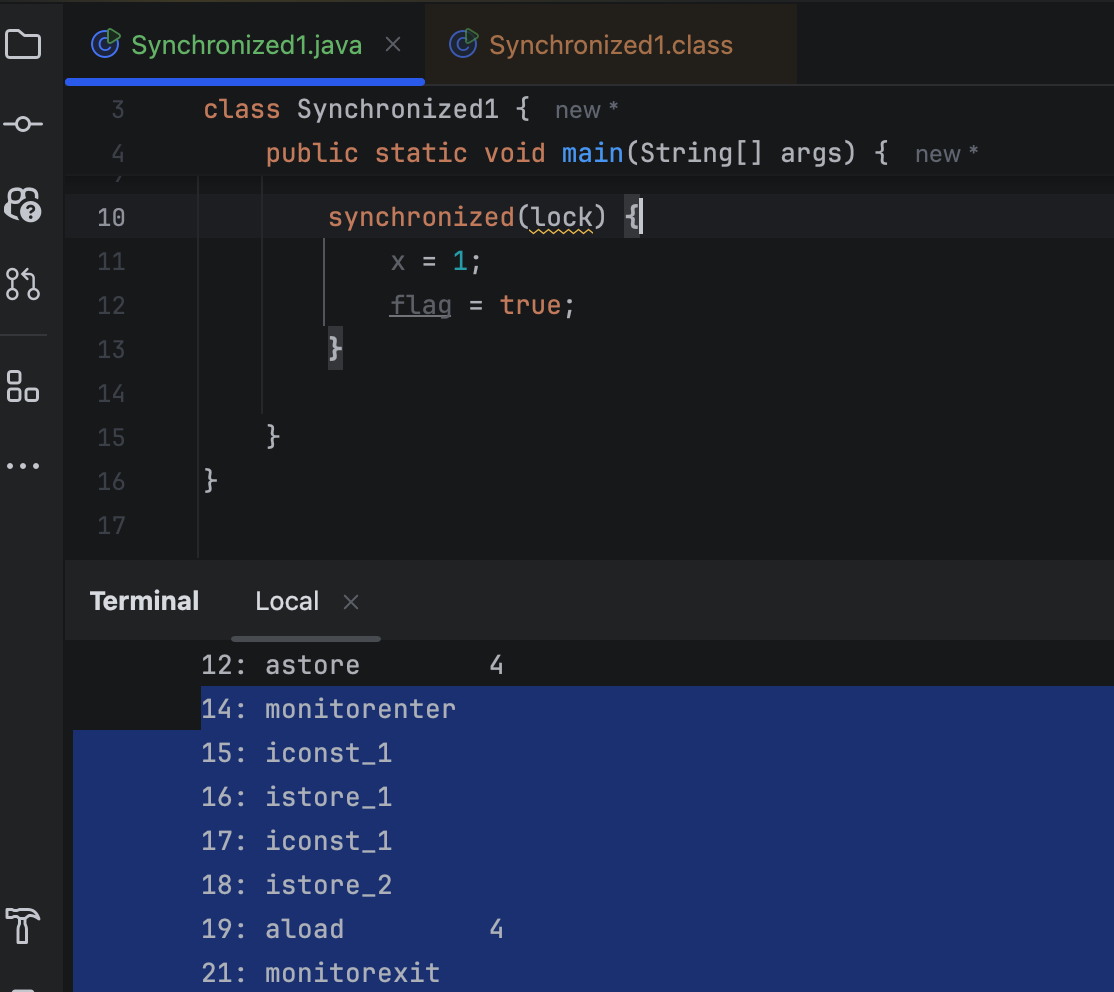
指令解释一下:
| 指令 | 作用 |
|---|---|
| monitorenter | 获取锁,进入同步代码块 |
| iconst_1 | 将整数 1 压入操作数栈 |
| istore_1 | 存储 1 到局部变量 x |
| iconst_1 | 再次将整数 1 压入操作数栈 |
| istore_2 | 存储 1 到局部变量 flag |
| aload 4 | 加载 lock 对象引用 |
| monitorexit | 释放锁,退出同步代码块 |
synchronized 怎么实现可重入的呢?
可重入意味着同一个线程可以多次获得同一个锁,而不会被阻塞。
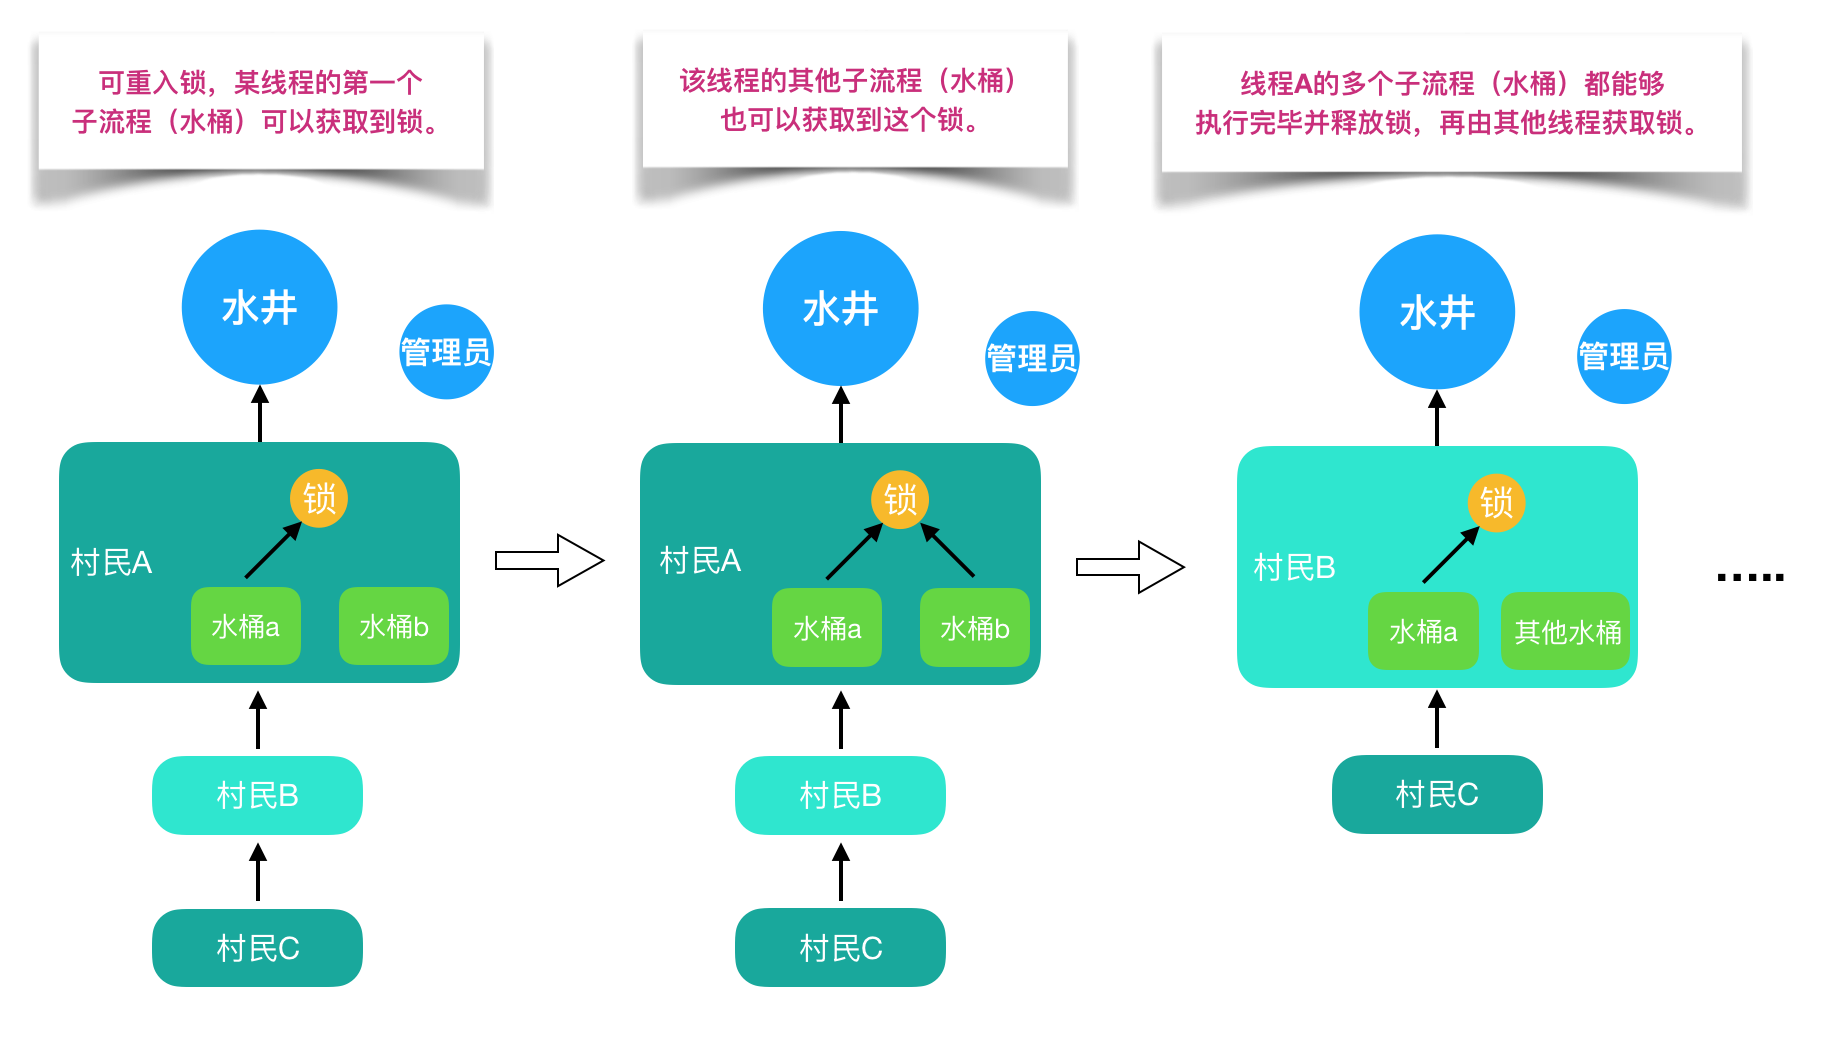
synchronized 之所以支持可重入,是因为 Java 的对象头包含了一个 Mark Word,用于存储对象的状态,包括锁信息。
当一个线程获取对象锁时,JVM 会将该线程的 ID 写入 Mark Word,并将锁计数器设为 1。
如果一个线程尝试再次获取已经持有的锁,JVM 会检查 Mark Word 中的线程 ID。如果 ID 匹配,表示的是同一个线程,锁计数器递增。
当线程退出同步块时,锁计数器递减。如果计数器值为零,JVM 将锁标记为未持有状态,并清除线程 ID 信息。
来解释一下:
class ReentrantExample {
    public synchronized void method1() {
        System.out.println("Method1 acquired lock");
        method2();  // 线程已经持有锁,能继续调用 method2
    }

    public synchronized void method2() {
        System.out.println("Method2 acquired lock");
    }

    public static void main(String[] args) {
        ReentrantExample example = new ReentrantExample();
        example.method1();
    }
}执行结果:
Method1 acquired lock
Method2 acquired lock因为 synchronized 支持可重入,所以 method1 获取锁后,method2 仍然可以获取锁。
底层是通过 Monitor 对象的 owner 和 count 字段实现的,owner 记录持有锁的线程,count 记录线程获取锁的次数。
+----------------------+
|  ObjectMonitor      |
|  ----------------   |
|  _owner = Thread-1  |  // 当前持有锁的线程
|  _count = 2         |  // 线程重入了 2 次
+----------------------+
- Java 面试指南(付费)收录的快手面经同学 5 面试原题:synchronized 可重入锁怎么实现的
memo:2025 年 02 月 10 日修改至此。
29.synchronized 锁升级了解吗?
推荐阅读:偏向锁、轻量级锁、重量级锁到底是什么?
JDK 1.6 的时候,为了提升 synchronized 的性能,引入了锁升级机制,从低开销的锁逐步升级到高开销的锁,以最大程度减少锁的竞争。
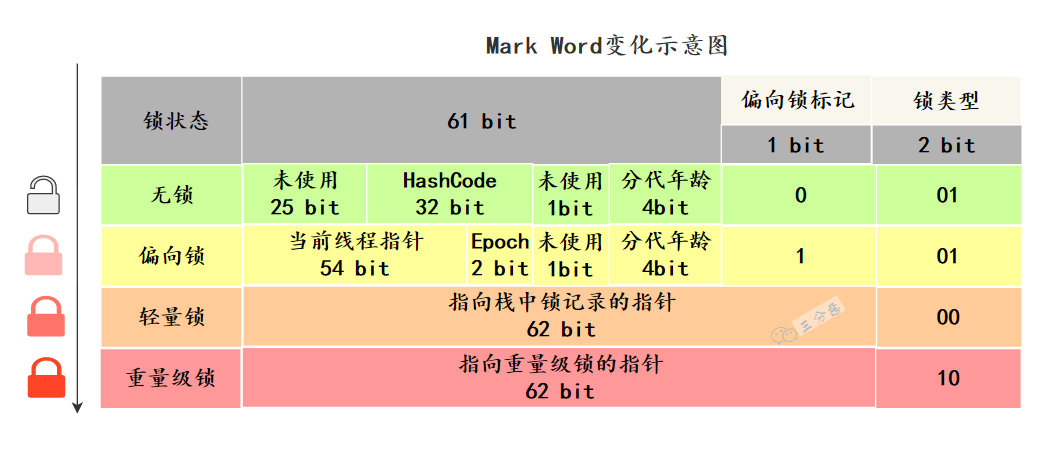
没有线程竞争时,就使用低开销的“偏向锁”,此时没有额外的 CAS 操作;轻度竞争时,使用“轻量级锁”,采用 CAS 自旋,避免线程阻塞;只有在重度竞争时,才使用“重量级锁”,由 Monitor 机制实现,需要线程阻塞。
了解 synchronized 四种锁状态吗?
了解。
①、无锁状态,对象未被锁定,Mark Word 存储对象的哈希码等信息。
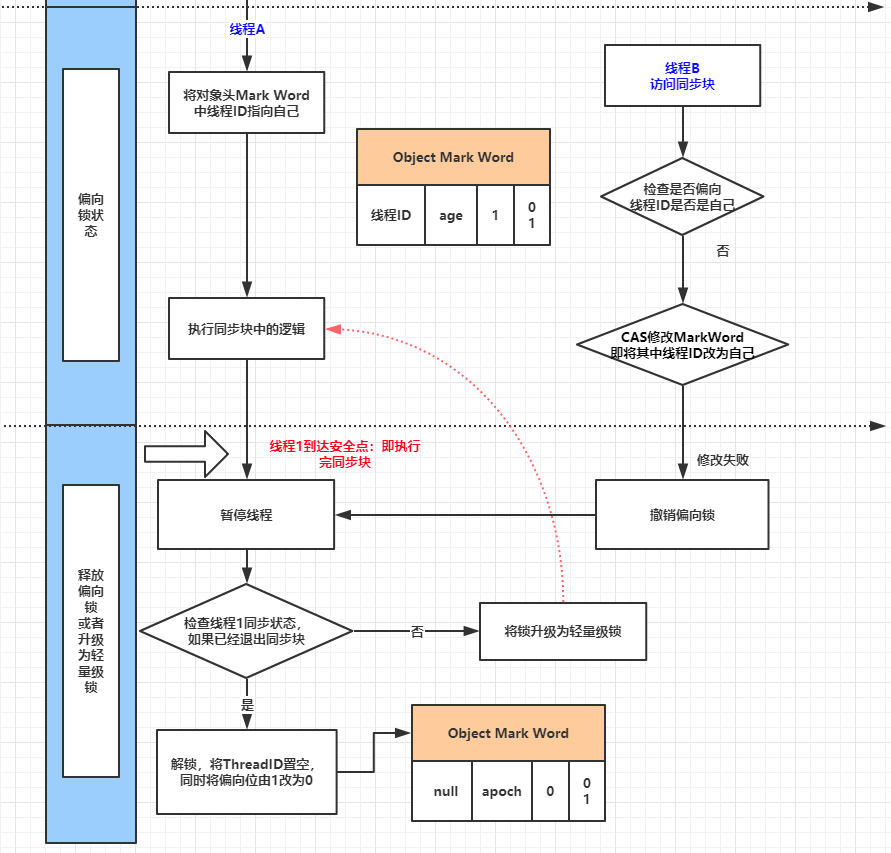
②、偏向锁,当线程第一次获取锁时,会进入偏向模式。Mark Word 会记录线程 ID,后续同一线程再次获取锁时,可以直接进入 synchronized 加锁的代码,无需额外加锁。
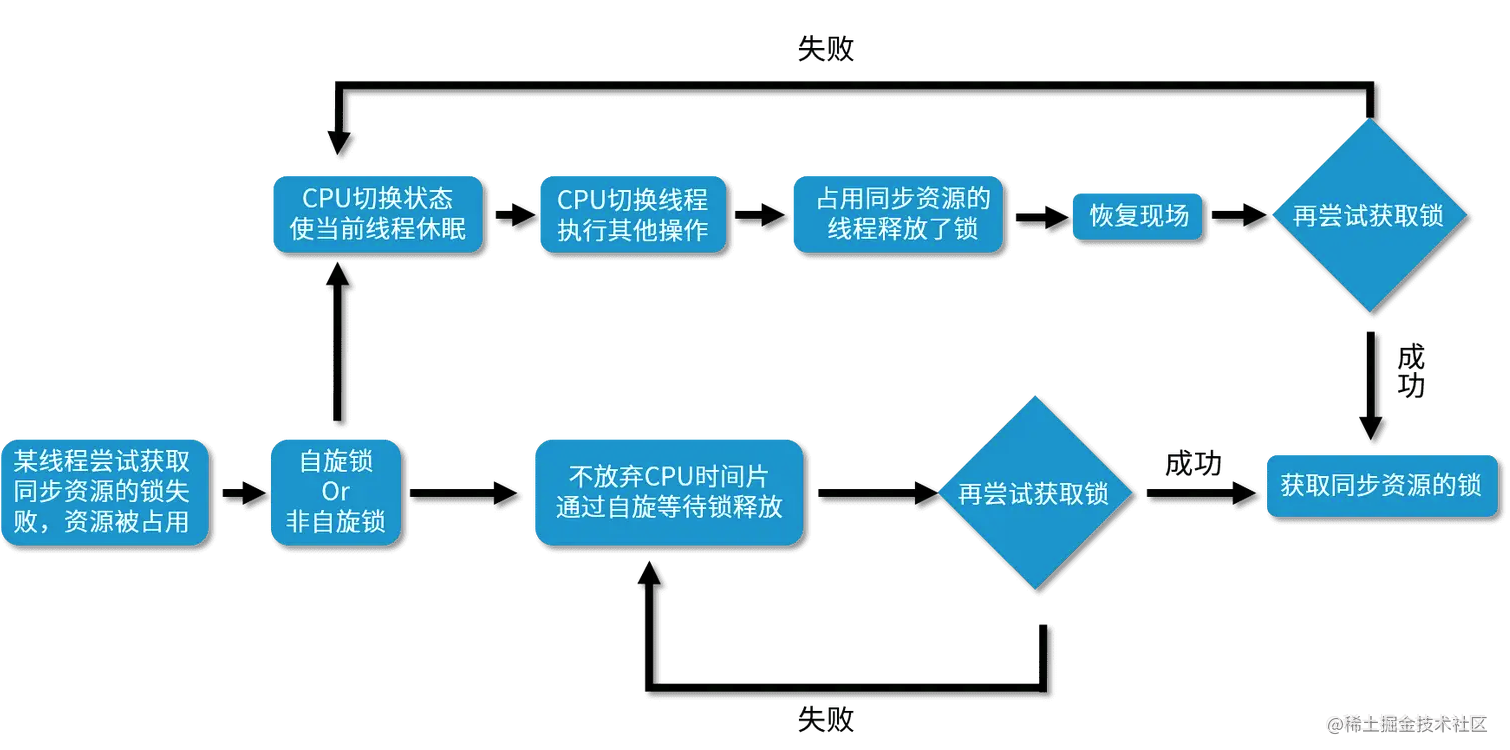
③、轻量级锁,当多个线程在不同时段获取同一把锁,即不存在锁竞争的情况时,JVM 会采用轻量级锁来避免线程阻塞。
未持有锁的线程通过CAS 自旋等待锁释放。
当线程进入 synchronized 加锁的代码时,如果对象的锁状态为偏向锁,也就是锁类型为“01”,偏向锁标记为“0”的状态。
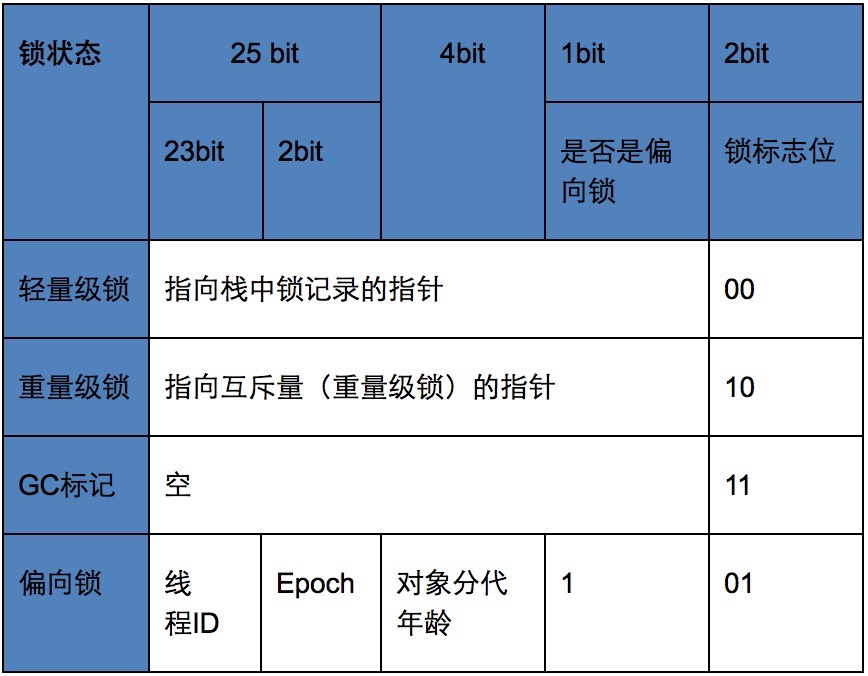
然后采用 CAS 自旋的方式,尝试将对象头中的 Mark Word 替换为指向 Lock Record 的指针,并将 Lock Record 中的 owner 指针指向对象的 Mark Word。
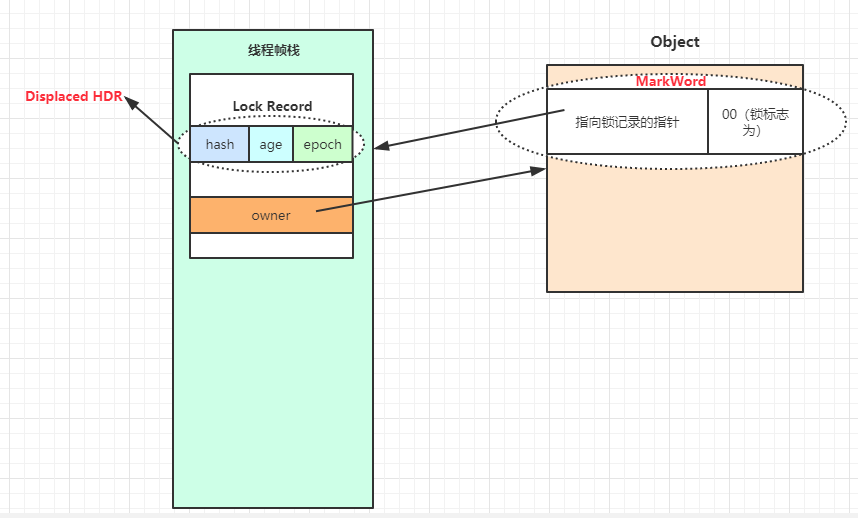
如果这个替换动作成功了,线程就拥有了该对象的锁,对象头 Mark Word 的锁标志位会更新为“00”,表示对象处于轻量级锁状态。
④、重量级锁,如果自旋超过一定的次数,或者一个线程持有锁,一个自旋,又有第三个线程进入 synchronized 加锁的代码时,轻量级锁就会升级为重量级锁。
此时,对象头的锁类型会更新为“10”,Mark Word 会存储指向 Monitor 对象的指针,其他等待锁的线程都会进入阻塞状态。
synchronized 做了哪些优化?
在 JDK 1.6 之前,synchronized 是直接调用 ObjectMonitor 的 enter 和 exit 指令实现的,这种锁也被称为重量级锁,性能较差。
随着 JDK 版本的更新,synchronized 的性能得到了极大的优化:
①、偏向锁:同一个线程可以多次获取同一把锁,无需重复加锁。
②、轻量级锁:当没有线程竞争时,通过 CAS 自旋等待锁,避免直接进入阻塞。
③、锁消除:JIT 可以在运行时进行代码分析,如果发现某些锁操作不可能被多个线程同时访问,就会对这些锁进行消除,从而减少上锁开销。
请详细说说锁升级的过程?
懵逼状态下的回答:锁升级会从无锁升级为偏向锁,再升级为轻量级锁,最后升级为重量级锁。
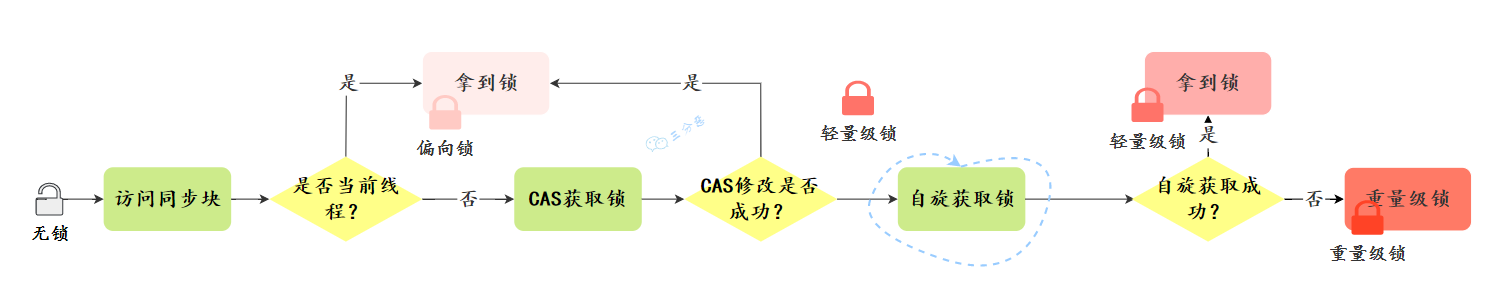
知道一点,但不深入的回答:
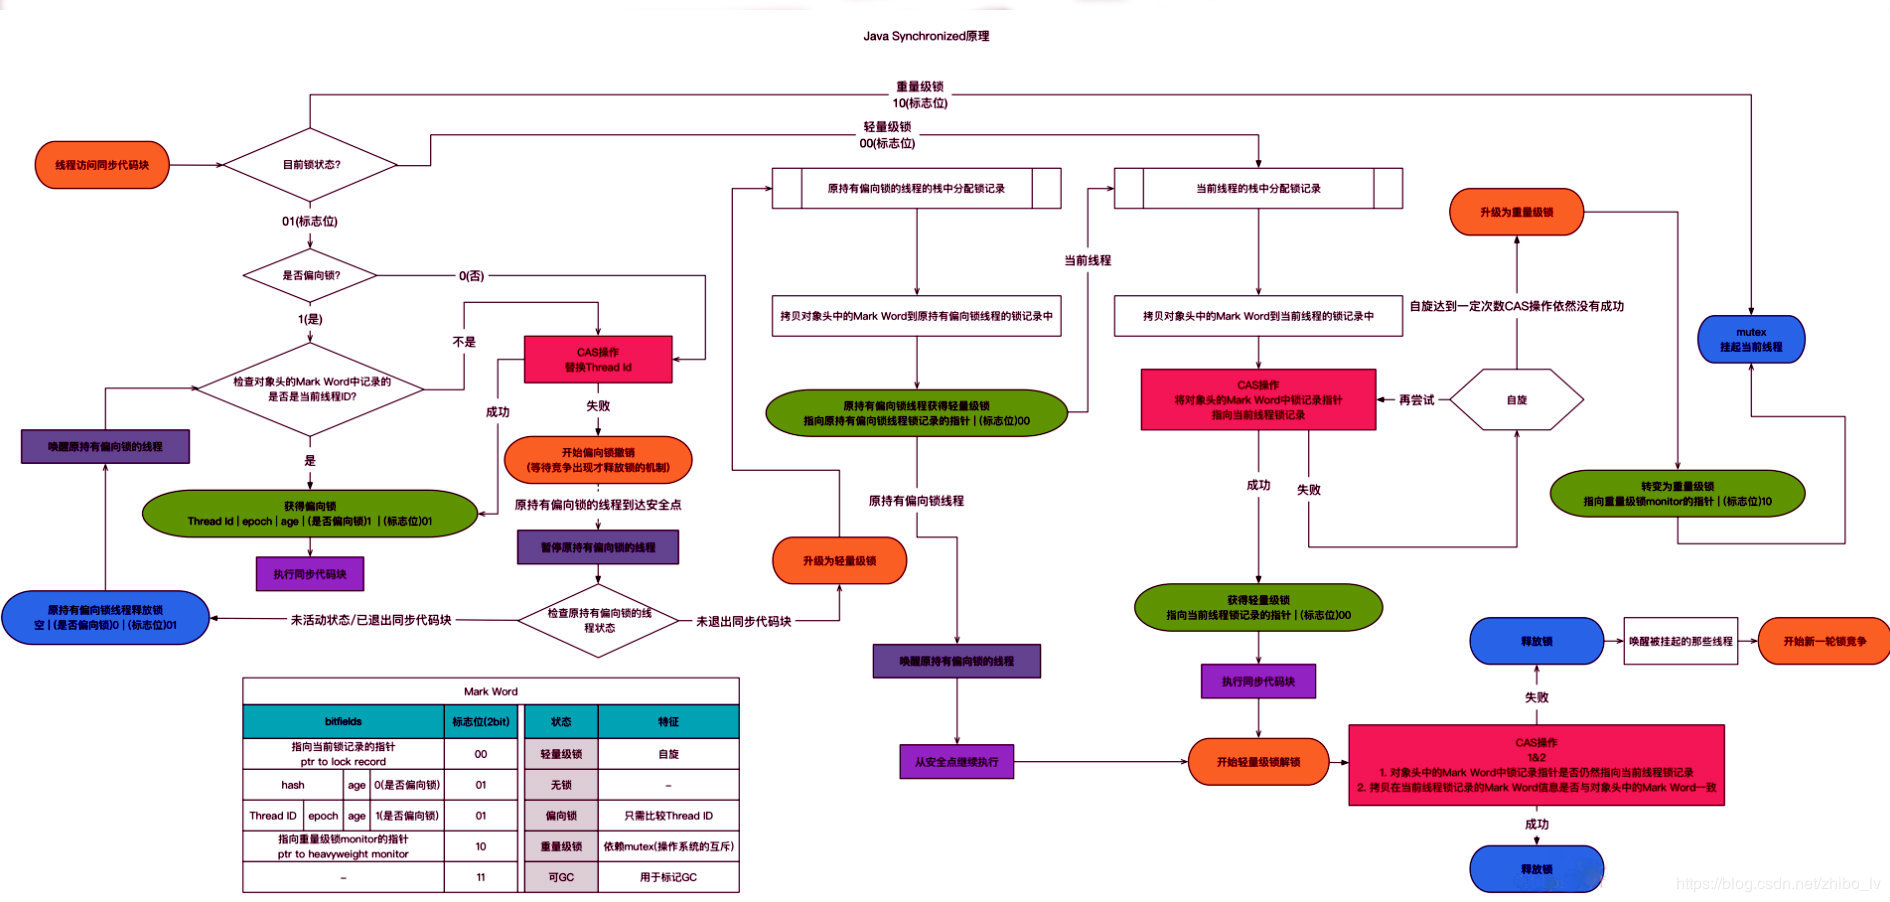
①、偏向锁:当一个线程第一次获取锁时,JVM 会在对象头的 Mark Word 记录这个线程 ID,下次进入 synchronized 时,如果还是同一个线程,可以直接执行,无需额外加锁。
②、轻量级锁:当多个线程尝试获取锁但不是同一个时段,偏向锁会升级为轻量级锁,等待锁的线程通过 CAS 自旋避免进入阻塞状态。
③、重量级锁:如果自旋失败,锁会升级为重量级锁,等待锁的线程会进入阻塞状态,等待监视器 Monitor 进行调度。
详细解释一下:
①、从无锁到偏向锁:
当一个线程首次访问同步代码时,如果此对象处于无锁状态且偏向锁未被禁用,JVM 会将该对象头的锁标记改为偏向锁状态,并记录当前线程 ID。此时,对象头中的 Mark Word 中存储了持有偏向锁的线程 ID。
如果另一个线程尝试获取这个已被偏向的锁,JVM 会检查当前持有偏向锁的线程是否活跃。如果持有偏向锁的线程不活跃,可以将锁偏向给新的线程;否则撤销偏向锁,升级为轻量级锁。
②、偏向锁的轻量级锁:
进行偏向锁撤销时,会遍历堆栈的所有锁记录,暂停拥有偏向锁的线程,并检查锁对象。如果这个过程中发现有其他线程试图获取这个锁,JVM 会撤销偏向锁,并将锁升级为轻量级锁。
当有两个或以上线程竞争同一个偏向锁时,偏向锁模式不再有效,此时偏向锁会被撤销,对象的锁状态会升级为轻量级锁。
③、轻量级锁到重量级锁:
轻量级锁通过自旋来等待锁释放。如果自旋超过预定次数(自旋次数是可调的,并且是自适应的,失败次数多自旋次数就少),表明锁竞争激烈。
当自旋多次失败,或者有线程在等待队列中等待相同的轻量级锁时,轻量级锁会升级为重量级锁。在这种情况下,JVM 会在操作系统层面创建一个互斥锁——Mutex,所有进一步尝试获取该锁的线程将会被阻塞,直到锁被释放。
memo:2025 年 02 月 11 日修改至此。synchronized 的锁升级是一块非常重要的内容,第二版的优化对这块内容进行了重新梳理,自认为更容易懂了,等大家的实际效果。
🌟30.synchronized 和 ReentrantLock 的区别了解吗?
两句话回答:synchronized 由 JVM 内部的 Monitor 机制实现,ReentrantLock基于 AQS 实现。
synchronized 可以自动加锁和解锁,ReentrantLock 需要手动 lock() 和 unlock()。
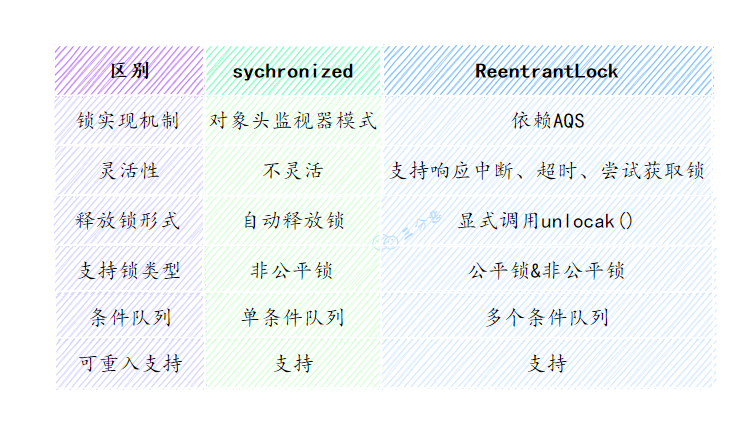
如果面试官还想知道更多,可以继续回答:
①、ReentrantLock 可以实现多路选择通知,绑定多个 Condition,而 synchronized 只能通过 wait 和 notify 唤醒,属于单路通知;
ReentrantLock lock = new ReentrantLock();
Condition condition = lock.newCondition();②、synchronized 可以在方法和代码块上加锁,ReentrantLock 只能在代码块上加锁,但可以指定是公平锁还是非公平锁。
// synchronized 修饰方法
public synchronized void method() {
    // 业务代码
}

// synchronized 修饰代码块
synchronized (this) {
    // 业务代码
}

// ReentrantLock 加锁
ReentrantLock lock = new ReentrantLock();
lock.lock();
try {
    // 业务代码
} finally {
    lock.unlock();
}③、ReentrantLock 提供了一种能够中断等待锁的线程机制,通过 lock.lockInterruptibly() 来实现。
ReentrantLock lock = new ReentrantLock();
try {
    lock.lockInterruptibly();
} catch (InterruptedException e) {
    // 处理中断异常
}并发量大的情况下,使用 synchronized 还是 ReentrantLock?
我更倾向于 ReentrantLock,因为:
- ReentrantLock 提供了超时和公平锁等特性,可以应对更复杂的并发场景。
- ReentrantLock 允许更细粒度的锁控制,能有效减少锁竞争。
- ReentrantLock 支持条件变量 Condition,可以实现比 synchronized 更友好的线程间通信机制。
Lock 了解吗?
Lock 是 JUC 中的一个接口,最常用的实现类包括可重入锁 ReentrantLock、读写锁 ReentrantReadWriteLock 等。
ReentrantLock 的 lock() 方法实现逻辑了解吗?
lock 方法的具体实现由 ReentrantLock 内部的 Sync 类来实现,涉及到线程的自旋、阻塞队列、CAS、AQS 等。
lock 方法会首先尝试通过 CAS 来获取锁。如果当前锁没有被持有,会将锁状态设置为 1,表示锁已被占用。否则,会将当前线程加入到 AQS 的等待队列中。
final void lock() {
    if (compareAndSetState(0, 1))  // 尝试直接获取锁
        setExclusiveOwnerThread(Thread.currentThread());
    else
        acquire(1);  // 如果获取失败,进入AQS队列等待
}31.AQS 了解多少?
推荐阅读:到底什么是 AQS?
AQS 是一个抽象类,它维护了一个共享变量 state 和一个线程等待队列,为 ReentrantLock 等类提供底层支持。
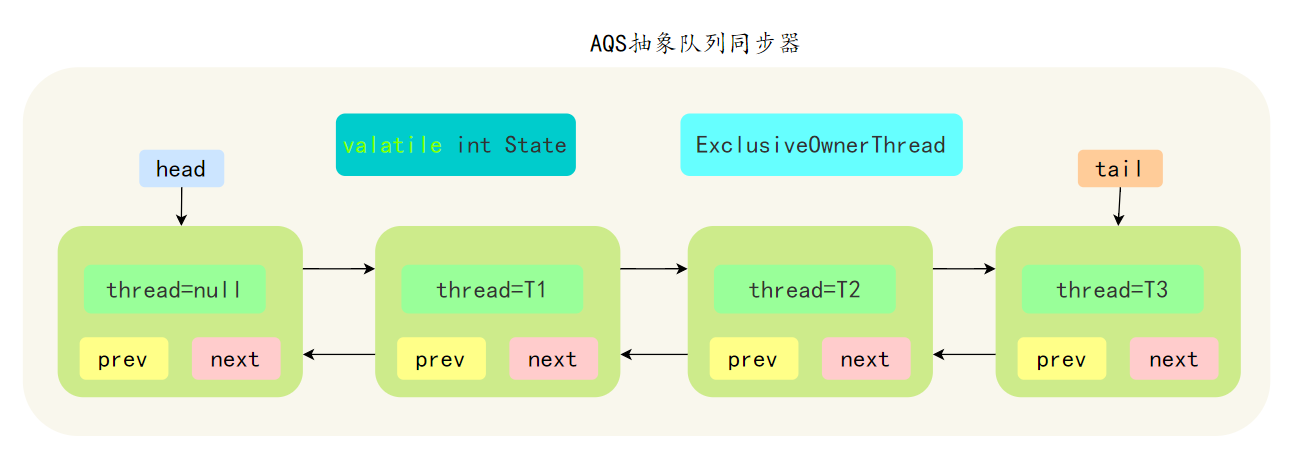
AQS 的思想是,如果被请求的共享资源处于空闲状态,则当前线程成功获取锁;否则,将当前线程加入到等待队列中,当其他线程释放锁时,从等待队列中挑选一个线程,把锁分配给它。
AQS 的源码阅读过吗?
有研究过。
第一,状态 state 由 volatile 变量修饰,用于保证多线程之间的可见性;
private volatile int state;②、同步队列由内部定义的 Node 类实现,每个 Node 包含了等待状态、前后节点、线程的引用等,是一个先进先出的双向链表。
static final class Node {
    static final int CANCELLED =  1;
    static final int SIGNAL    = -1;
    static final int CONDITION = -2;
    static final int PROPAGATE = -3;

    volatile Node prev;

    volatile Node next;

    volatile Thread thread;
}AQS 支持两种同步方式:
- 独占模式下:每次只能有一个线程持有锁,例如 ReentrantLock。
- 共享模式下:多个线程可以同时获取锁,例如 Semaphore 和 CountDownLatch。
核心方法包括:
acquire:获取锁,失败进入等待队列;release:释放锁,唤醒等待队列中的线程;acquireShared:共享模式获取锁;releaseShared:共享模式释放锁。
AQS 使用一个 CLH 队列来维护等待线程,CLH 是三个作者 Craig、Landin 和 Hagersten 的首字母缩写,是一种基于链表的自旋锁。
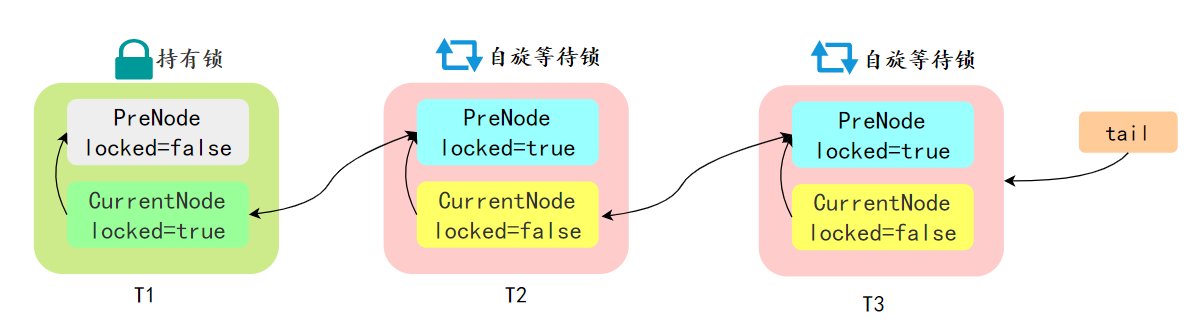
在 CLH 中,当一个线程尝试获取锁失败后,会被添加到队列的尾部并自旋,等待前一个节点的线程释放锁。
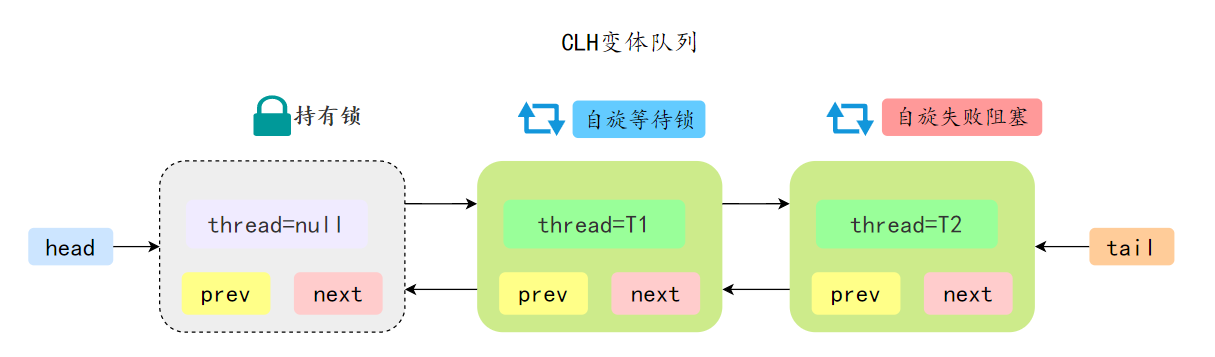
CLH 的优点是,假设有 100 个线程在等待锁,锁释放之后,只会通知队列中的第一个线程去竞争锁。避免同时唤醒大量线程,浪费 CPU 资源。
memo:2025 年 02 月 12 日修改至此,今天的其他时间在修改简历和调整技术派中派聪明 AI 助手的界面(接入了 Deepseek)。
32.说说 ReentrantLock 的实现原理?
ReentrantLock 是基于 AQS 实现的 可重入排他锁,使用 CAS 尝试获取锁,失败的话,会进入 CLH 阻塞队列,支持公平锁、非公平锁,可以中断、超时等待。

内部通过一个计数器 state 来跟踪锁的状态和持有次数。当线程调用 lock() 方法获取锁时,ReentrantLock 会检查 state 的值,如果为 0,通过 CAS 修改为 1,表示成功加锁。否则根据当前线程的公平性策略,加入到等待队列中。
线程首次获取锁时,state 值设为 1;如果同一个线程再次获取锁时,state 加 1;每释放一次锁,state 减 1。
当线程调用 unlock() 方法时,ReentrantLock 会将持有锁的 state 减 1,如果 state = 0,则释放锁,并唤醒等待队列中的线程来竞争锁。
使用方式非常简单:
class CounterWithLock {
    private int count = 0;
    private final Lock lock = new ReentrantLock();

    public void increment() {
        lock.lock();  // 获取锁
        try {
            count++;
        } finally {
            lock.unlock();  // 释放锁
        }
    }

    public int getCount() {
        return count;
    }
}new ReentrantLock() 默认创建的是非公平锁 NonfairSync。在非公平锁模式下,锁可能会授予刚刚请求它的线程,而不考虑等待时间。当切换到公平锁模式下,锁会授予等待时间最长的线程。
33.ReentrantLock 怎么创建公平锁?
很简单,创建 ReentrantLock 的时候,传递参数 true 就可以了。
ReentrantLock lock = new ReentrantLock(true);
// true 代表公平锁,false 代表非公平锁
public ReentrantLock(boolean fair) {
    sync = fair ? new FairSync() : new NonfairSync();
}怎么创建一个非公平锁呢?
创建 ReentrantLock 时,不传递参数或者传递参数就好了。
非公平锁和公平锁有什么不同?
两句话回答:
公平锁意味着在多个线程竞争锁时,获取锁的顺序与线程请求锁的顺序相同,即先来先服务。
非公平锁不保证线程获取锁的顺序,当锁被释放时,任何请求锁的线程都有机会获取锁,而不是按照请求的顺序。
公平锁的实现逻辑了解吗?
公平锁的核心逻辑在 AQS 的 hasQueuedPredecessors() 方法中,该方法用于判断当前线程前面是否有等待的线程。
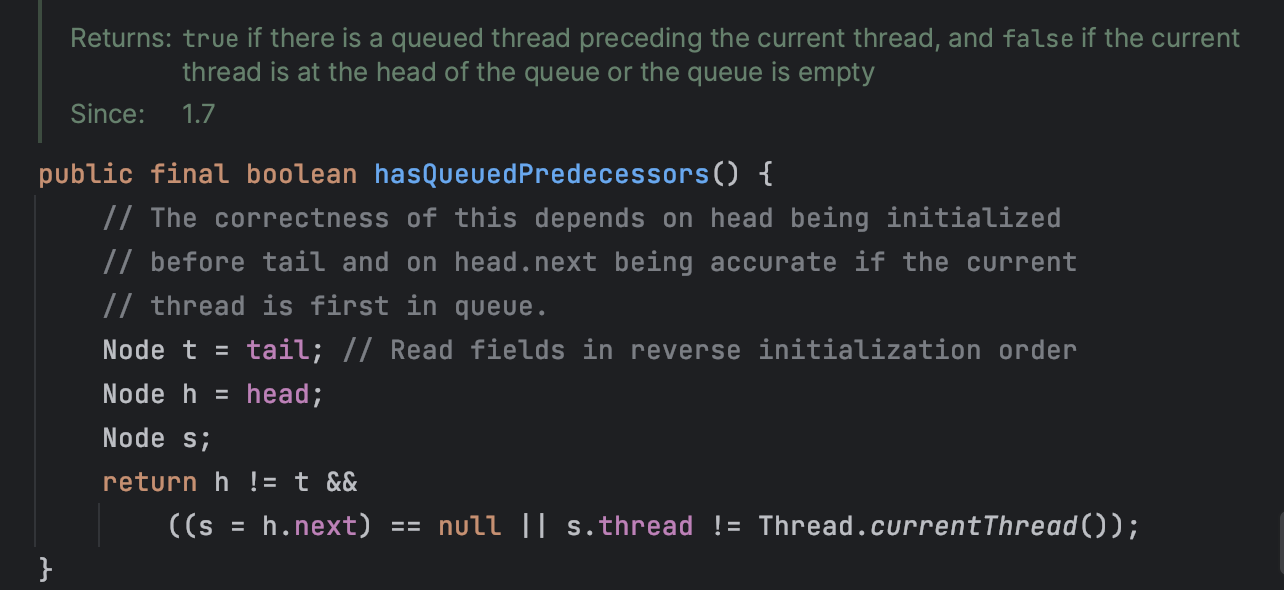
如果队列前面有等待线程,当前线程就不能抢占锁,必须按照队列顺序排队。如果队列前面没有线程,或者当前线程是队列头部的线程,就可以获取锁。
34.CAS 了解多少?
CAS 是一种乐观锁,用于比较一个变量的当前值是否等于预期值,如果相等,则更新值,否则重试。
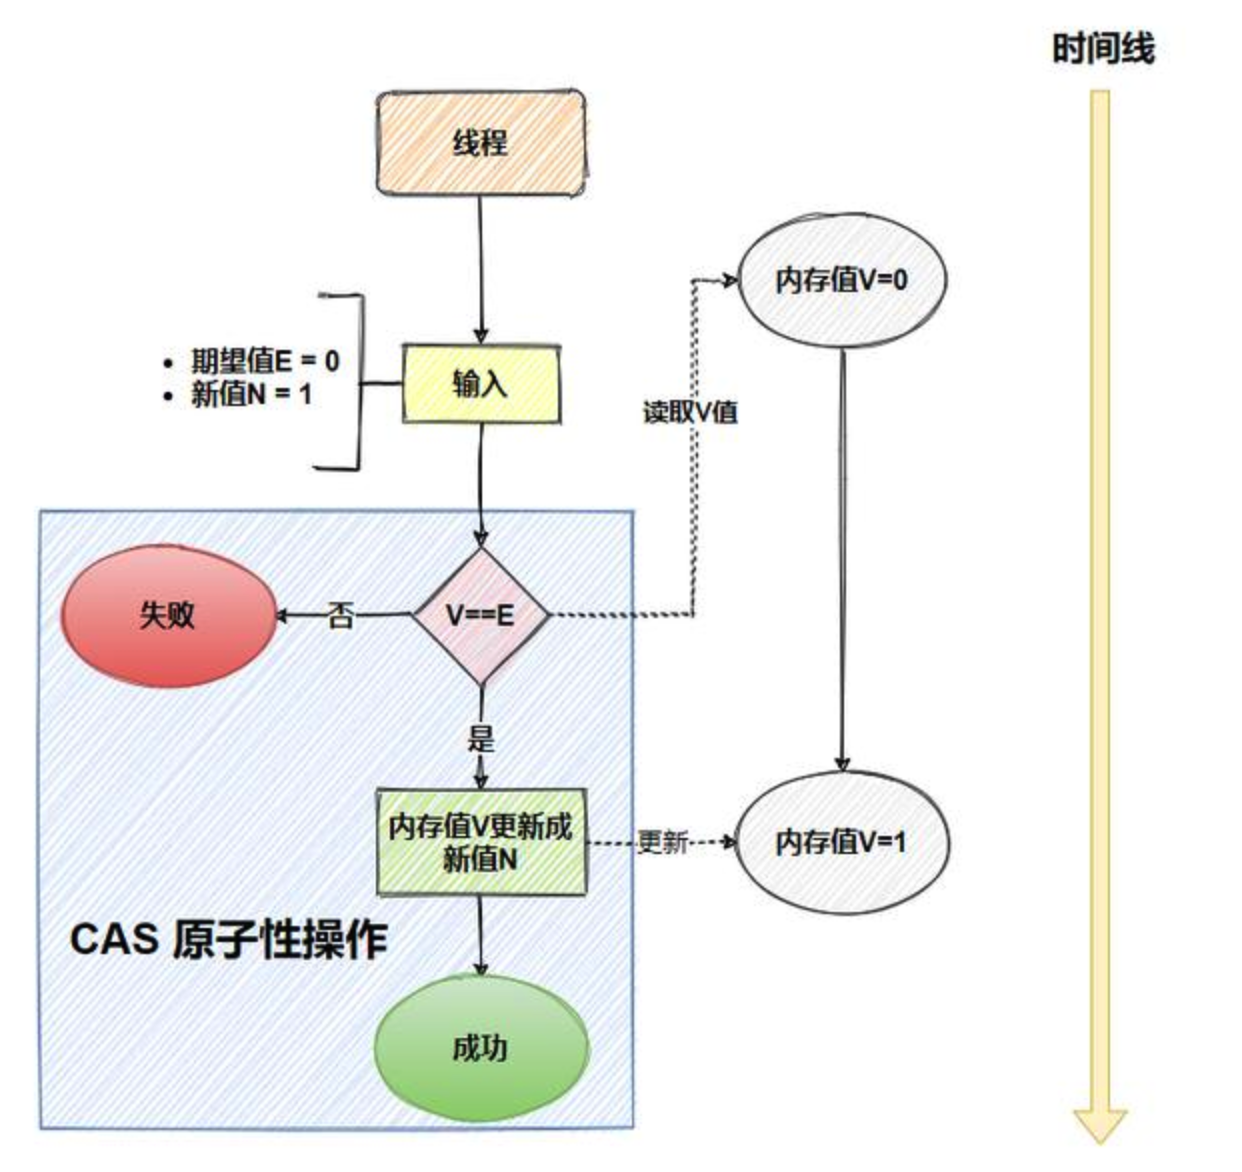
在 CAS 中,有三个值:
- V:要更新的变量(var)
- E:预期值(expected)
- N:新值(new)
先判断 V 是否等于 E,如果等于,将 V 的值设置为 N;如果不等,说明已经有其它线程更新了 V,当前线程就放弃更新。
这个比较和替换的操作需要是原子的,不可中断的。Java 中的 CAS 是由 Unsafe 类实现的。
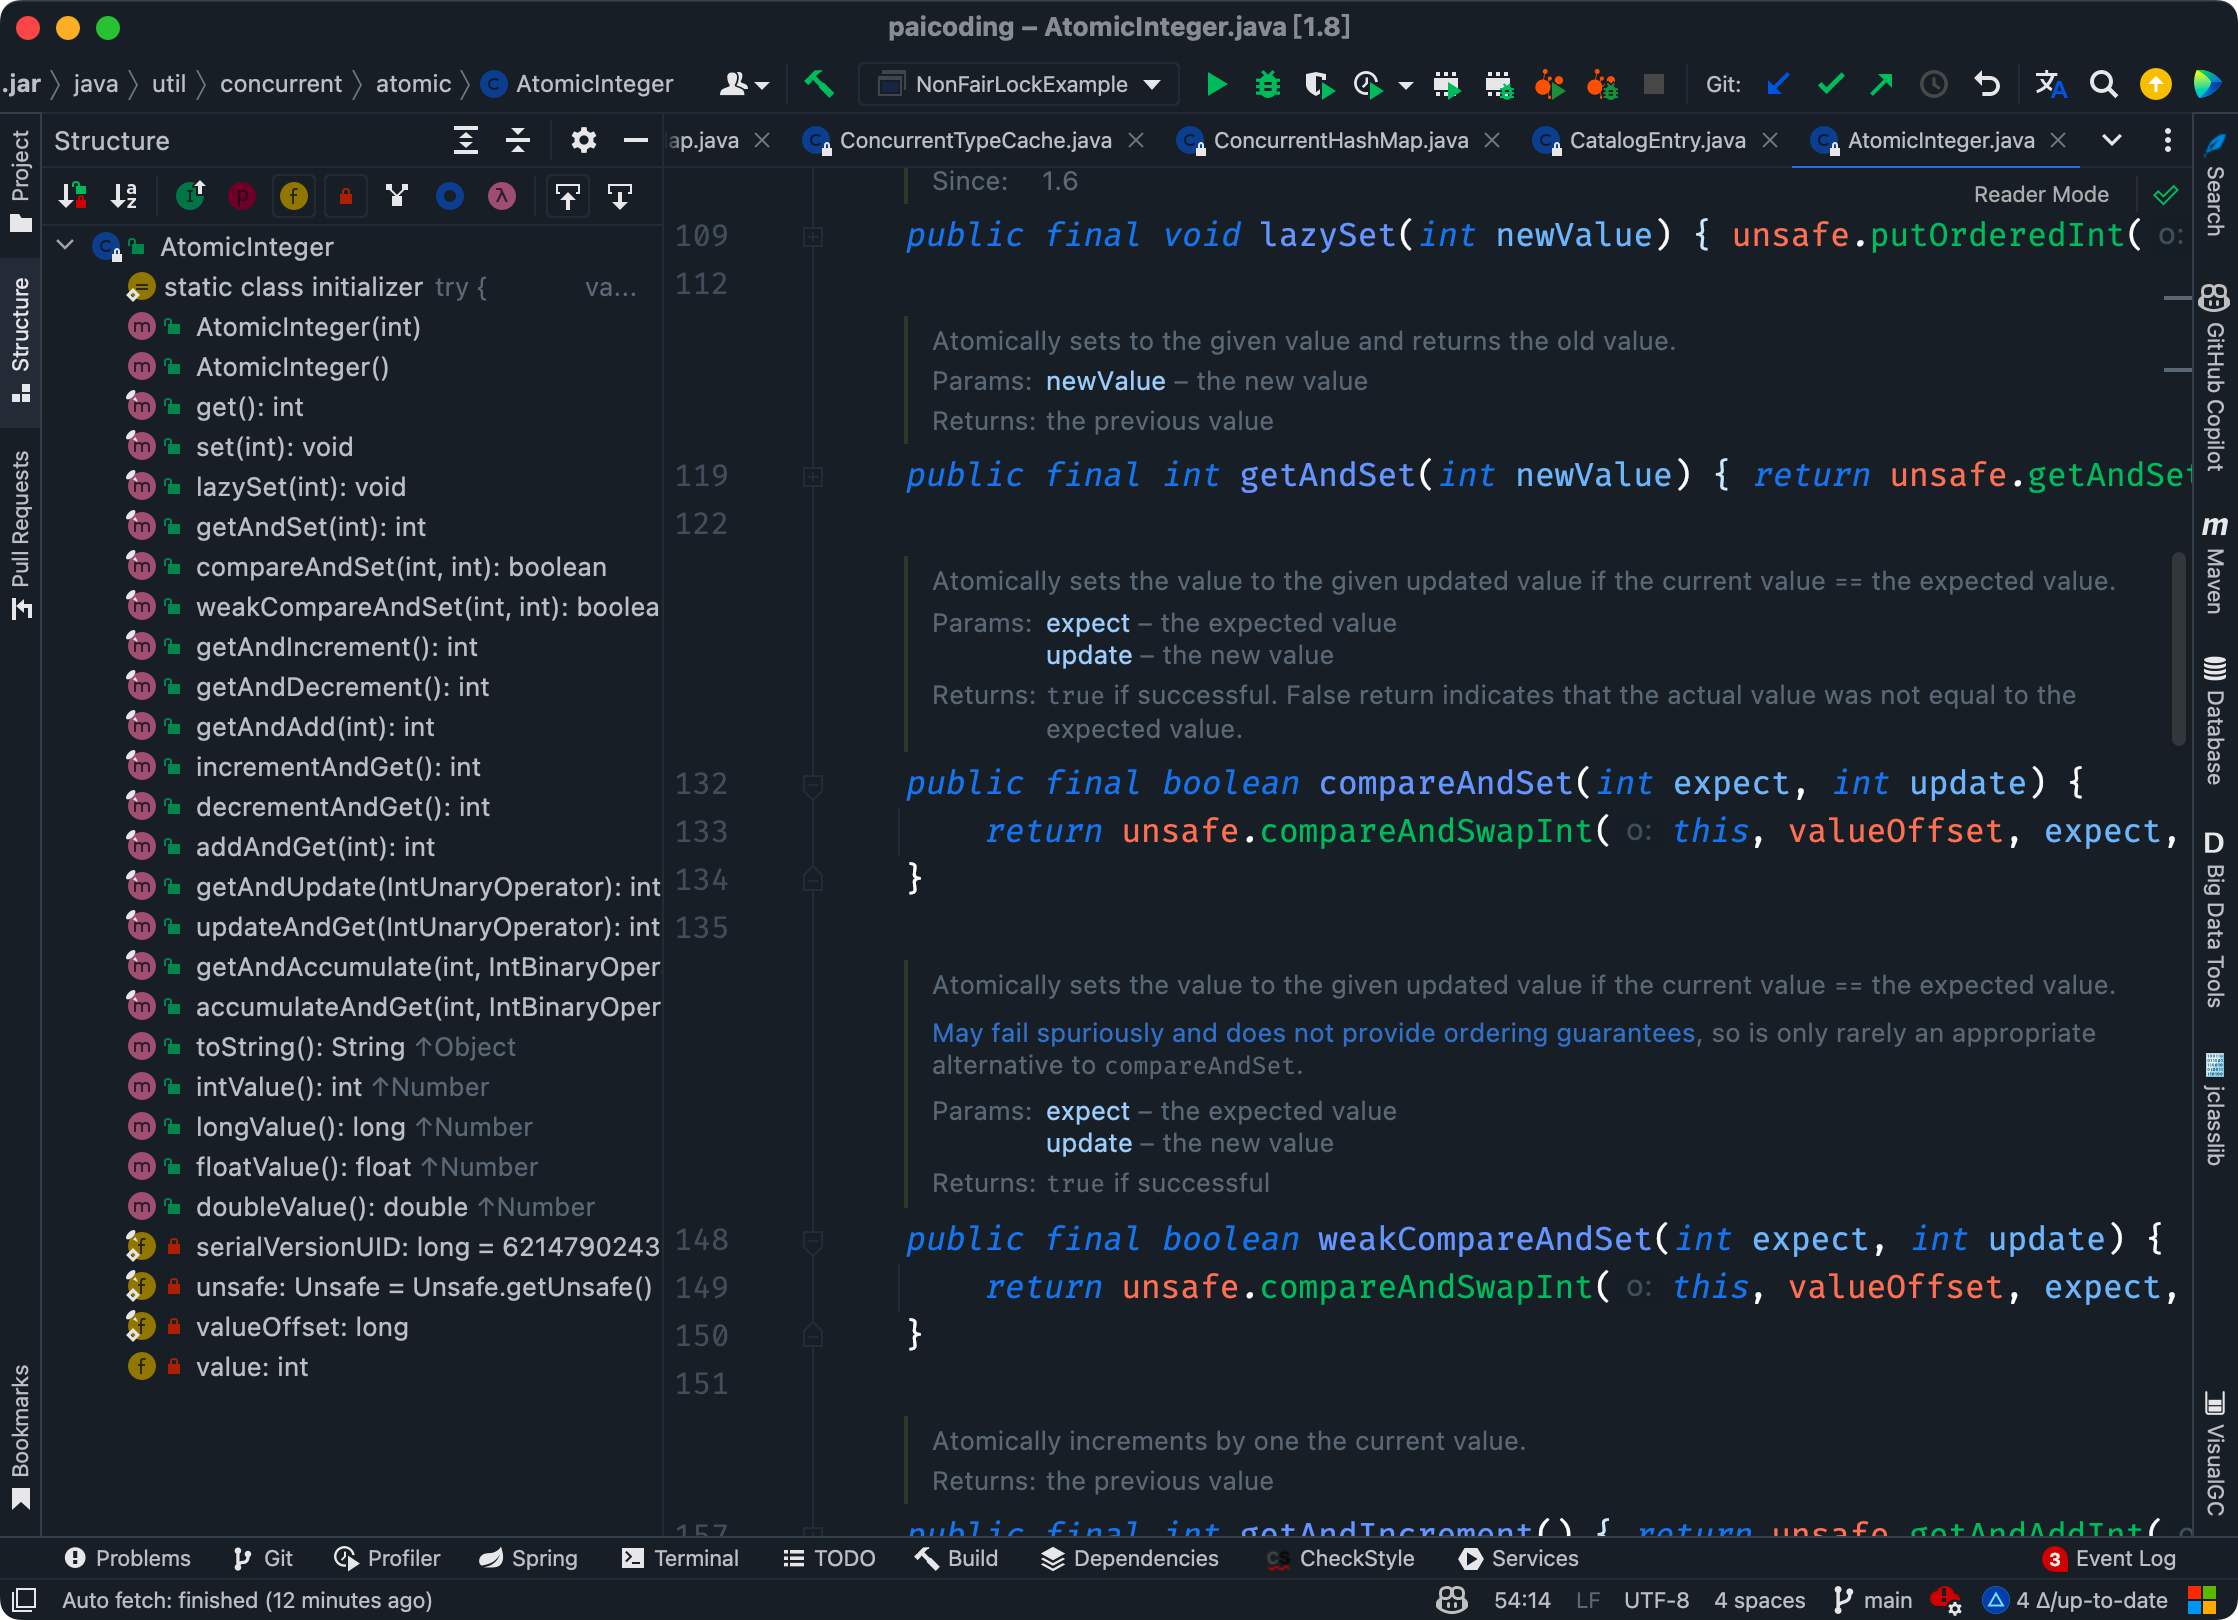
AtomicInteger 类的 compareAndSet 就是一个 CAS 方法:
AtomicInteger atomicInteger = new AtomicInteger(0);
int expect = 0;
int update = 1;
atomicInteger.compareAndSet(expect, update);它调用的是 Unsafe 的 compareAndSwapInt。
怎么保证 CAS 的原子性?
CPU 会发出一个 LOCK 指令进行总线锁定,阻止其他处理器对内存地址进行操作,直到当前指令执行完成。
lock cmpxchg [esi], eax ; 比较 esi 地址中的值与 eax,如果相等则替换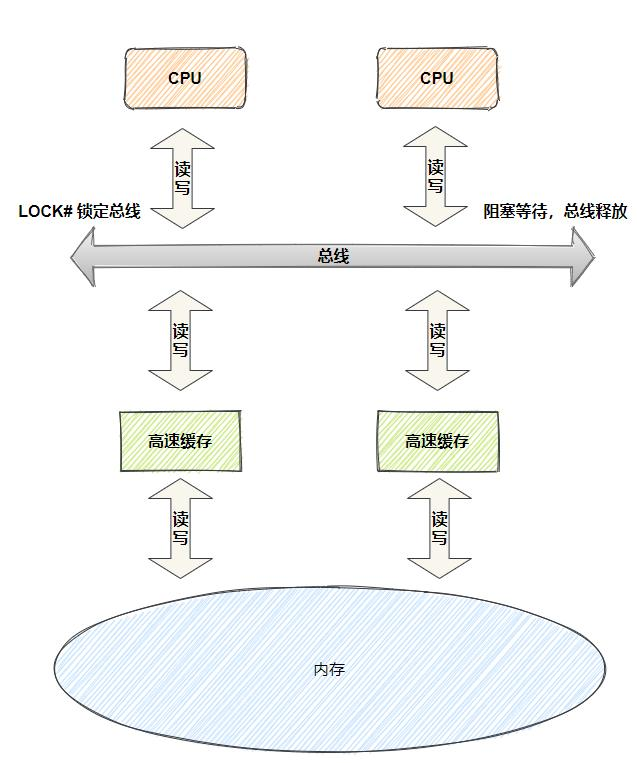
35.CAS 有什么问题?
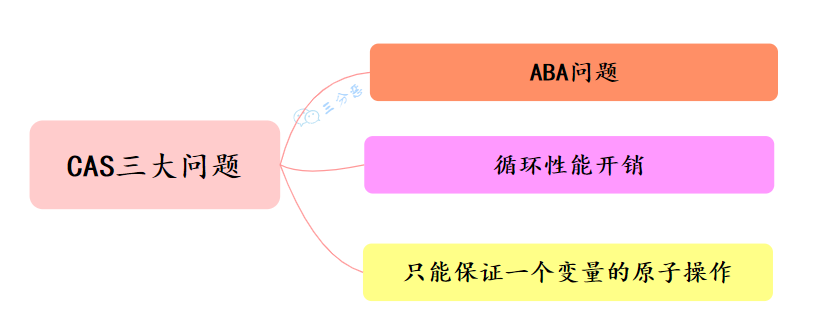
CAS 存在三个经典问题,ABA 问题、自旋开销大、只能操作一个变量等。
什么是 ABA 问题?
ABA 问题指的是,一个值原来是 A,后来被改为 B,再后来又被改回 A,这时 CAS 会误认为这个值没有发生变化。
线程 1:CAS(A → B),修改变量 A → B
线程 2:CAS(B → A),变量又变回 A
线程 3:CAS(A → C),CAS 成功,但实际数据已被修改过!可以使用版本号/时间戳的方式来解决 ABA 问题。
比如说,每次变量更新时,不仅更新变量的值,还更新一个版本号。CAS 操作时,不仅比较变量的值,还比较版本号。
class OptimisticLockExample {
    private int version;
    private int value;

    public synchronized boolean updateValue(int newValue, int currentVersion) {
        if (this.version == currentVersion) {
            this.value = newValue;
            this.version++;
            return true;
        }
        return false;
    }
}Java 的 AtomicStampedReference 就增加了版本号,它会同时检查引用值和 stamp 是否都相等。
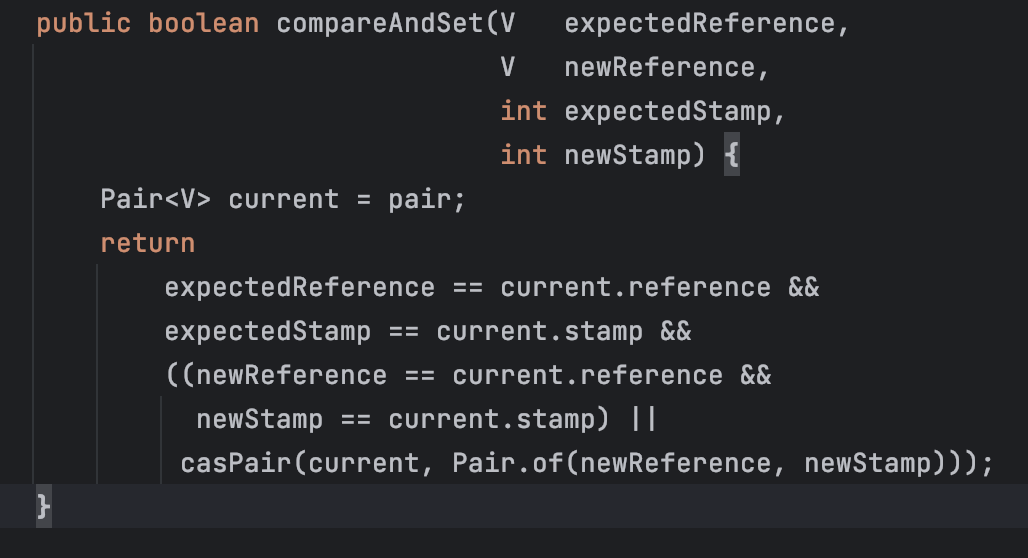
使用示例:
class ABAFix {
    private static AtomicStampedReference<String> ref = new AtomicStampedReference<>("100", 1);

    public static void main(String[] args) {
        new Thread(() -> {
            int stamp = ref.getStamp();
            ref.compareAndSet("100", "200", stamp, stamp + 1);
            ref.compareAndSet("200", "100", ref.getStamp(), ref.getStamp() + 1);
        }).start();

        new Thread(() -> {
            try { Thread.sleep(100); } catch (InterruptedException e) {}
            int stamp = ref.getStamp();
            System.out.println("CAS 结果:" + ref.compareAndSet("100", "300", stamp, stamp + 1));
        }).start();
    }
}自旋开销大怎么解决?
CAS 失败时会不断自旋重试,如果一直不成功,会给 CPU 带来非常大的执行开销。
可以加一个自旋次数的限制,超过一定次数,就切换到 synchronized 挂起线程。
int MAX_RETRIES = 10;
int retries = 0;
while (!atomicInt.compareAndSet(expect, update)) {
    retries++;
    if (retries > MAX_RETRIES) {
        synchronized (this) { // 超过次数,使用 synchronized 处理
            if (atomicInt.get() == expect) {
                atomicInt.set(update);
            }
        }
        break;
    }
}涉及到多个变量同时更新怎么办?
可以将多个变量封装为一个对象,使用 AtomicReference 进行 CAS 更新。
class Account {
    static class Balance {
        final int money;
        final int points;

        Balance(int money, int points) {
            this.money = money;
            this.points = points;
        }
    }

    private AtomicReference<Balance> balance = new AtomicReference<>(new Balance(100, 10));

    public void update(int newMoney, int newPoints) {
        Balance oldBalance, newBalance;
        do {
            oldBalance = balance.get();
            newBalance = new Balance(newMoney, newPoints);
        } while (!balance.compareAndSet(oldBalance, newBalance));
    }
}memo:2025 年 2 月 13 日修改至此,VIP 群里已经有球友在催下一个主题了,说实话最近事情有点多,认真修改起来又会比较花时间,所以只能希望大家多理解了。
36.Java 有哪些保证原子性的方法?
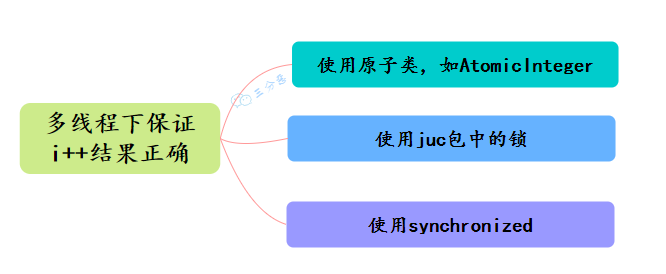
比如说以 Atomic 开头的原子类,synchronized 关键字,ReentrantLock 锁等。
37.原子操作类了解多少?
原子操作类是基于 CAS + volatile 实现的,底层依赖于 Unsafe 类,最常用的有 AtomicInteger、AtomicLong、AtomicReference 等。
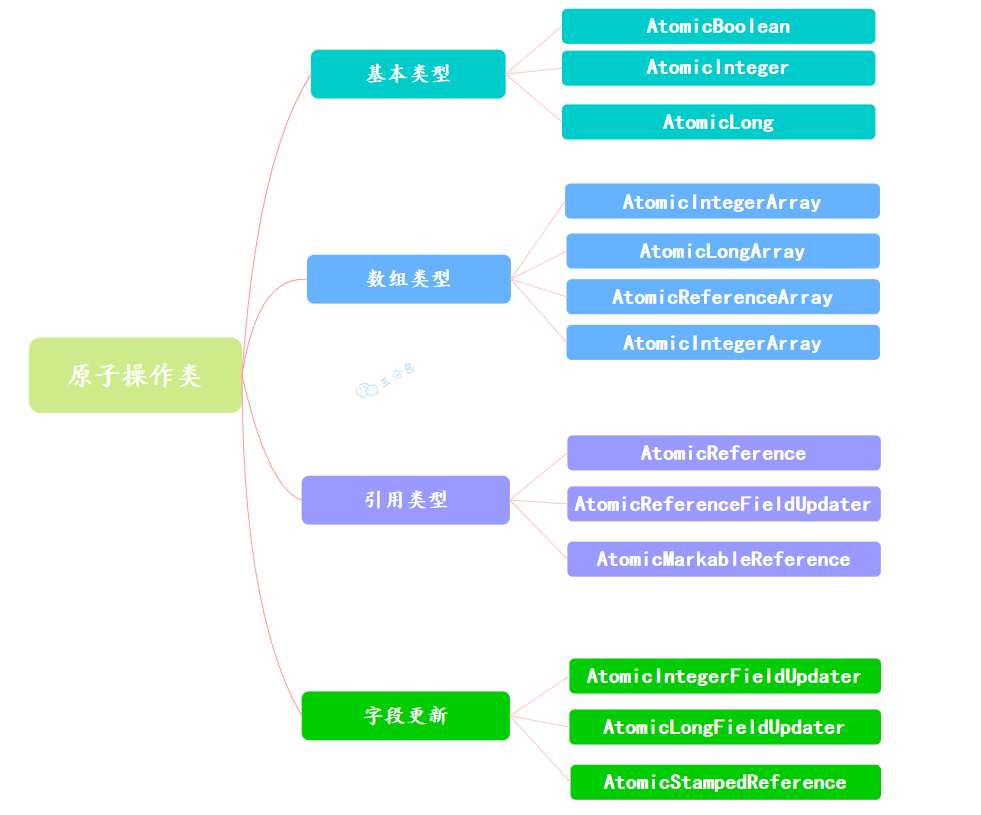
像 AtomicIntegerArray 这种以 Array 结尾的,还可以原子更新数组里的元素。
class AtomicArrayExample {
    public static void main(String[] args) {
        AtomicIntegerArray atomicArray = new AtomicIntegerArray(new int[]{1, 2, 3});

        atomicArray.incrementAndGet(1); // 对索引 1 进行自增
        System.out.println(atomicArray.get(1)); // 输出 3
    }
}像 AtomicStampedReference 还可以通过版本号的方式解决 CAS 中的 ABA 问题。
class AtomicStampedReferenceExample {
    public static void main(String[] args) {
        AtomicStampedReference<Integer> ref = new AtomicStampedReference<>(100, 1);

        int stamp = ref.getStamp(); // 获取版本号
        ref.compareAndSet(100, 200, stamp, stamp + 1); // A → B
        ref.compareAndSet(200, 100, ref.getStamp(), ref.getStamp() + 1); // B → A
    }
}38.AtomicInteger 的源码读过吗?
有读过。
AtomicInteger 是基于 volatile 和 CAS 实现的,底层依赖于 Unsafe 类。核心方法包括 getAndIncrement、compareAndSet 等。
public final int getAndIncrement() {
    return unsafe.getAndAddInt(this, valueOffset, 1);
}39.线程死锁了解吗?
死锁发生在多个线程相互等待对方释放锁时。比如说线程 1 持有锁 R1,等待锁 R2;线程 2 持有锁 R2,等待锁 R1。
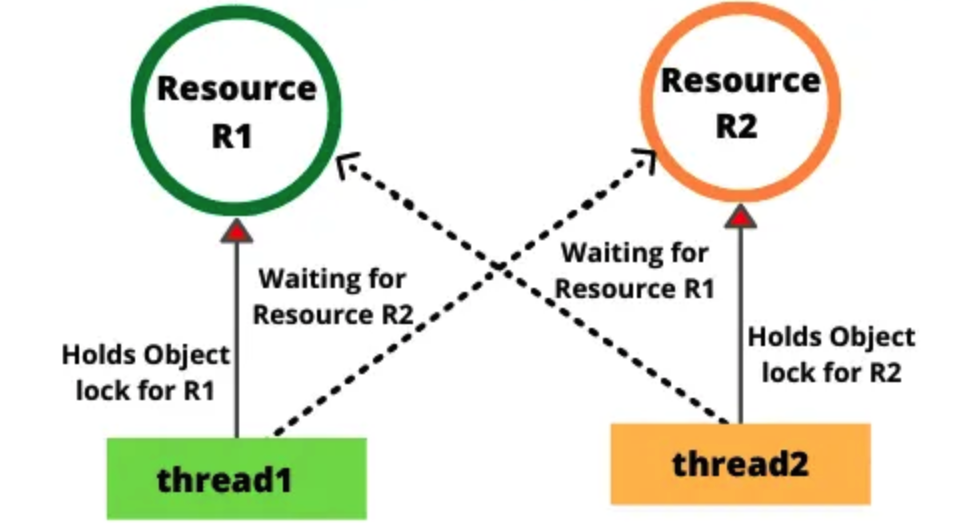
死锁发生的四个条件了解吗?
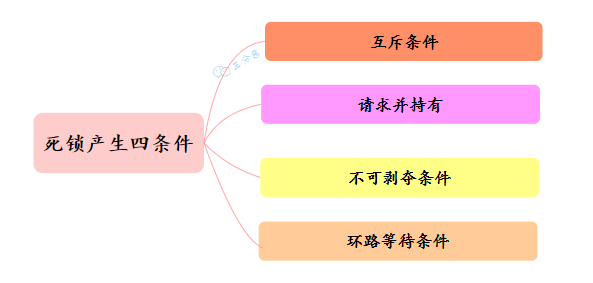
第一条件是互斥:资源不能被多个线程共享,一次只能由一个线程使用。如果一个线程已经占用了一个资源,其他请求该资源的线程必须等待,直到资源被释放。
第二个条件是持有并等待:一个线程已经持有一个资源,并且在等待获取其他线程持有的资源。
第三个条件是不可抢占:资源不能被强制从线程中夺走,必须等线程自己释放。
第四个条件是循环等待:存在一种线程等待链,线程 A 等待线程 B 持有的资源,线程 B 等待线程 C 持有的资源,直到线程 N 又等待线程 A 持有的资源。
该如何避免死锁呢?
第一,所有线程都按照固定的顺序来申请资源。例如,先申请 R1 再申请 R2。
第二,如果线程发现无法获取某个资源,可以先释放已经持有的资源,重新尝试申请。
40.死锁问题怎么排查呢?
首先从系统级别上排查,比如说在 Linux 生产环境中,可以先使用 top ps 等命令查看进程状态,看看是否有进程占用了过多的资源。
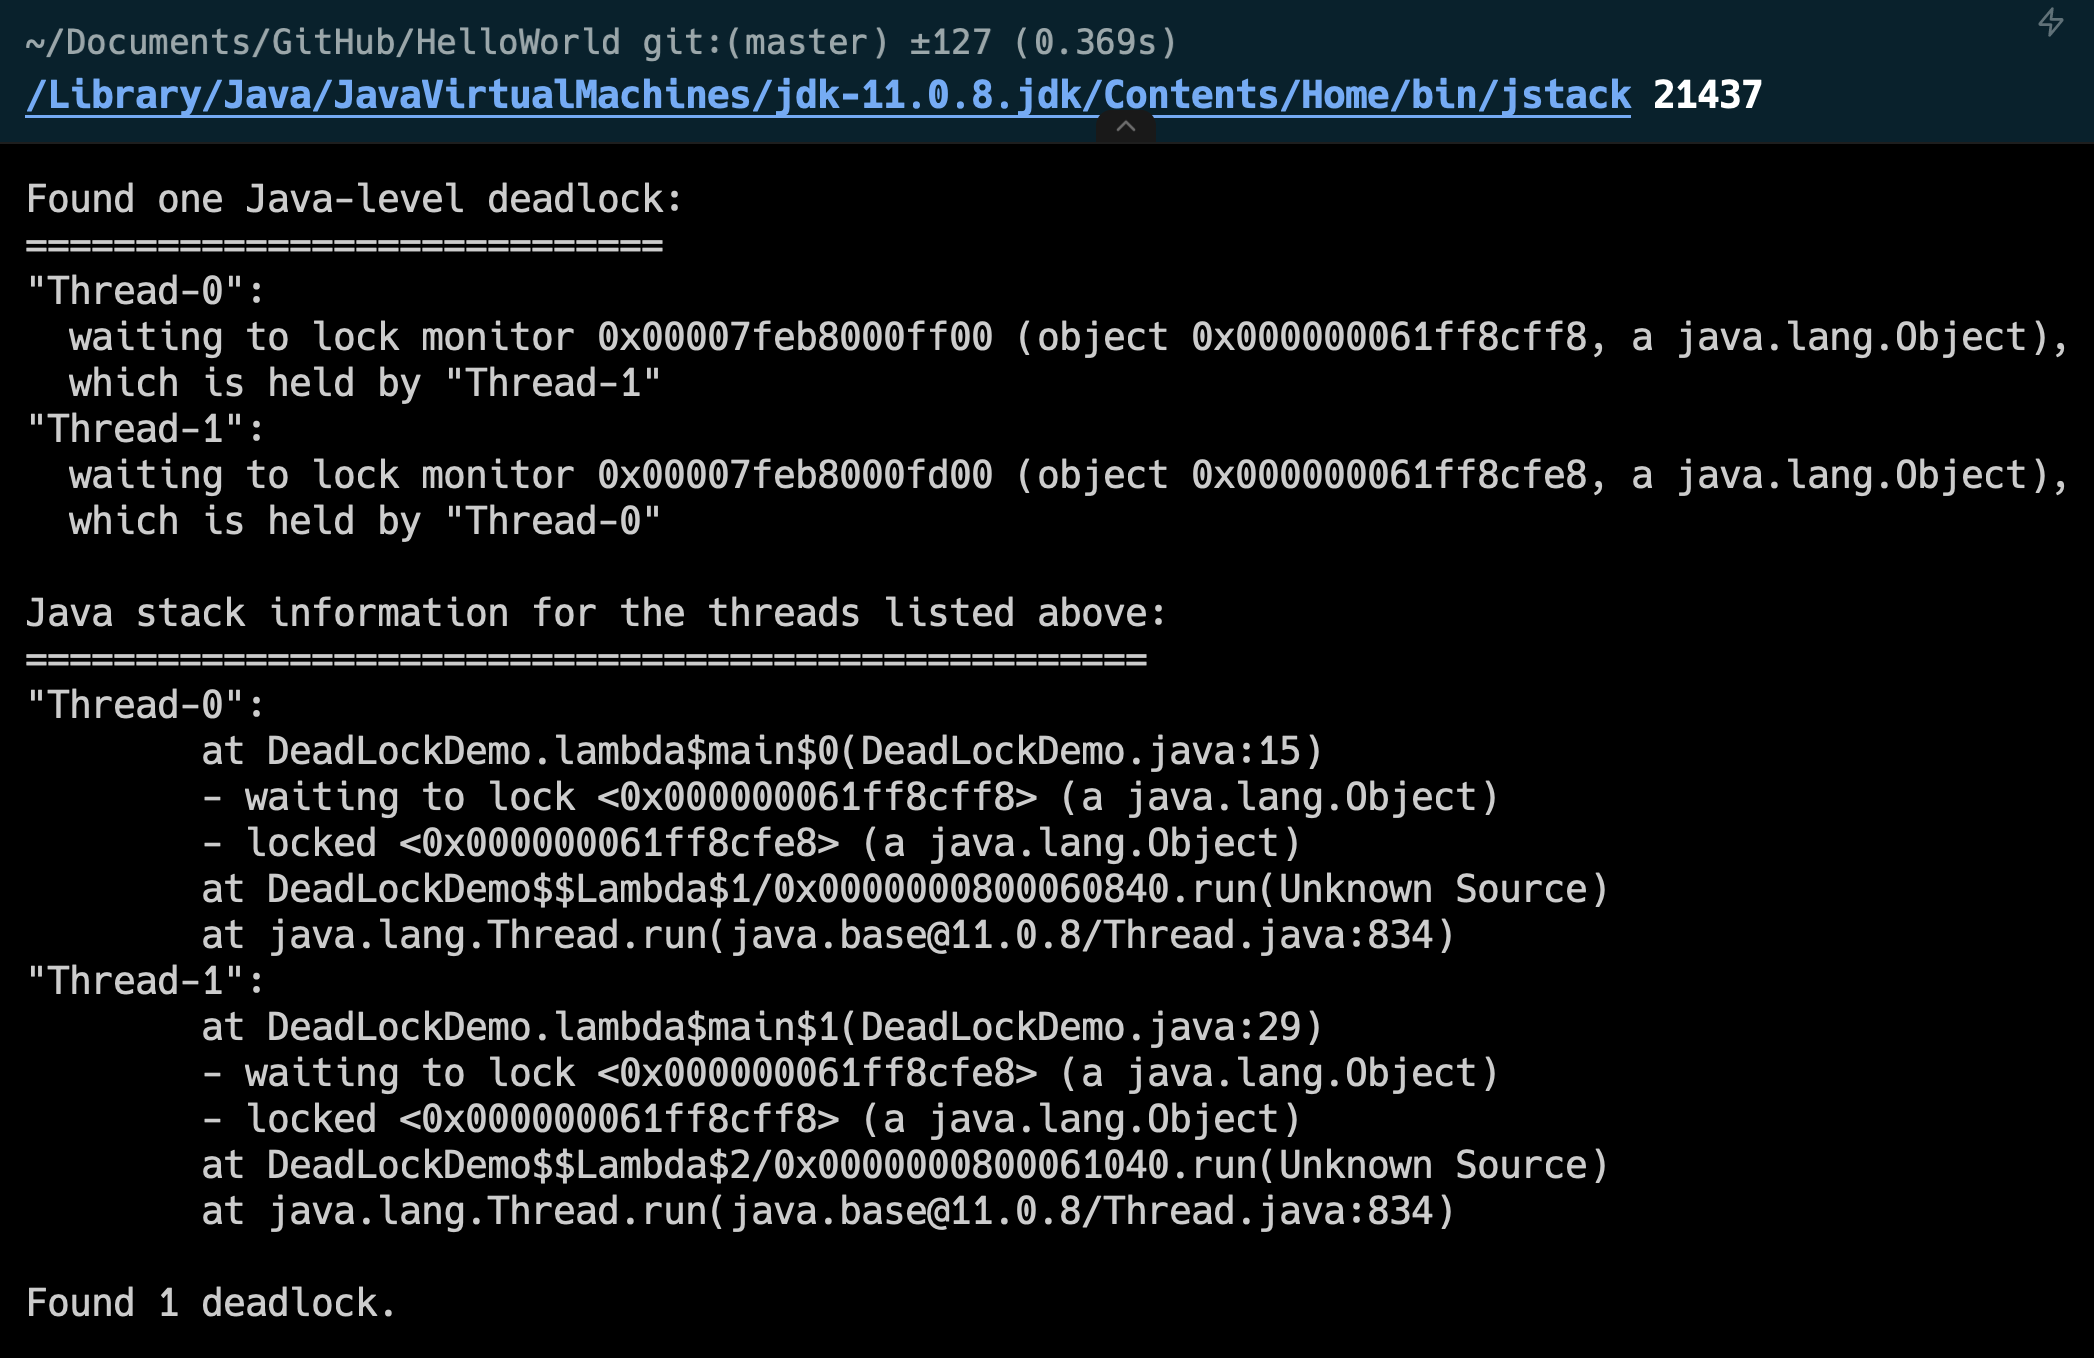
接着,使用 JDK 自带的一些性能监控工具进行排查,比如说 使用 jps -l 查看当前进程,然后使用 jstack 进程号 查看当前进程的线程堆栈信息,看看是否有线程在等待锁资源。
也可以使用一些可视化的性能监控工具,比如说 JConsole、VisualVM 等,查看线程的运行状态、锁的竞争情况等。
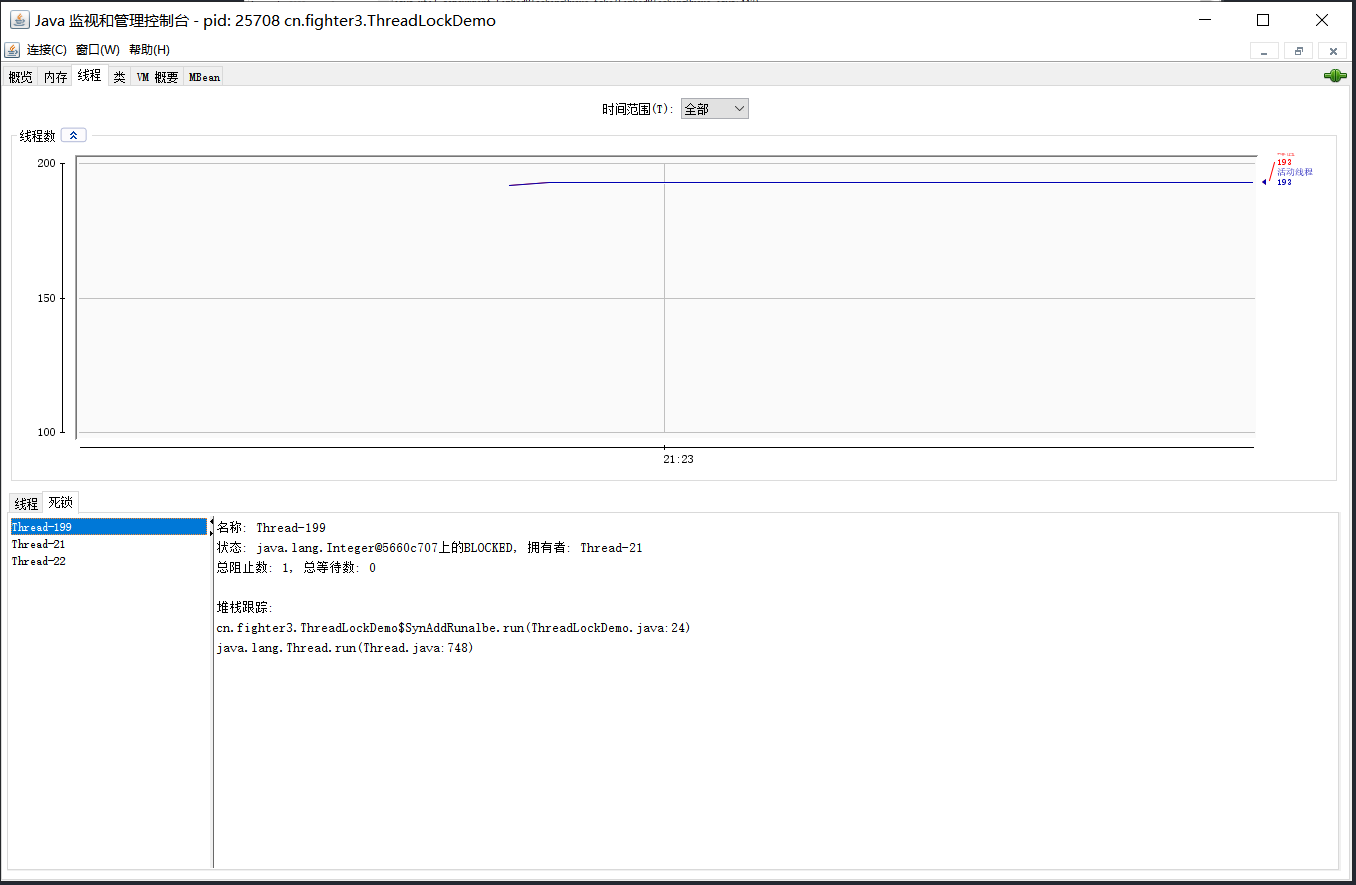
我们来通过实际代码说明一下:
class DeadLockDemo {
    private static final Object lock1 = new Object();
    private static final Object lock2 = new Object();

    public static void main(String[] args) {
        new Thread(() -> {
            synchronized (lock1) {
                System.out.println("线程1获取到了锁1");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (lock2) {
                    System.out.println("线程1获取到了锁2");
                }
            }
        }).start();

        new Thread(() -> {
            synchronized (lock2) {
                System.out.println("线程2获取到了锁2");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (lock1) {
                    System.out.println("线程2获取到了锁1");
                }
            }
        }).start();
    }
}创建两个线程,每个线程都试图按照不同的顺序获取两个锁(lock1 和 lock2)。
锁的获取顺序不一致很容易导致死锁。运行这段代码,会发现两个线程都无法继续执行,进入了死锁状态。
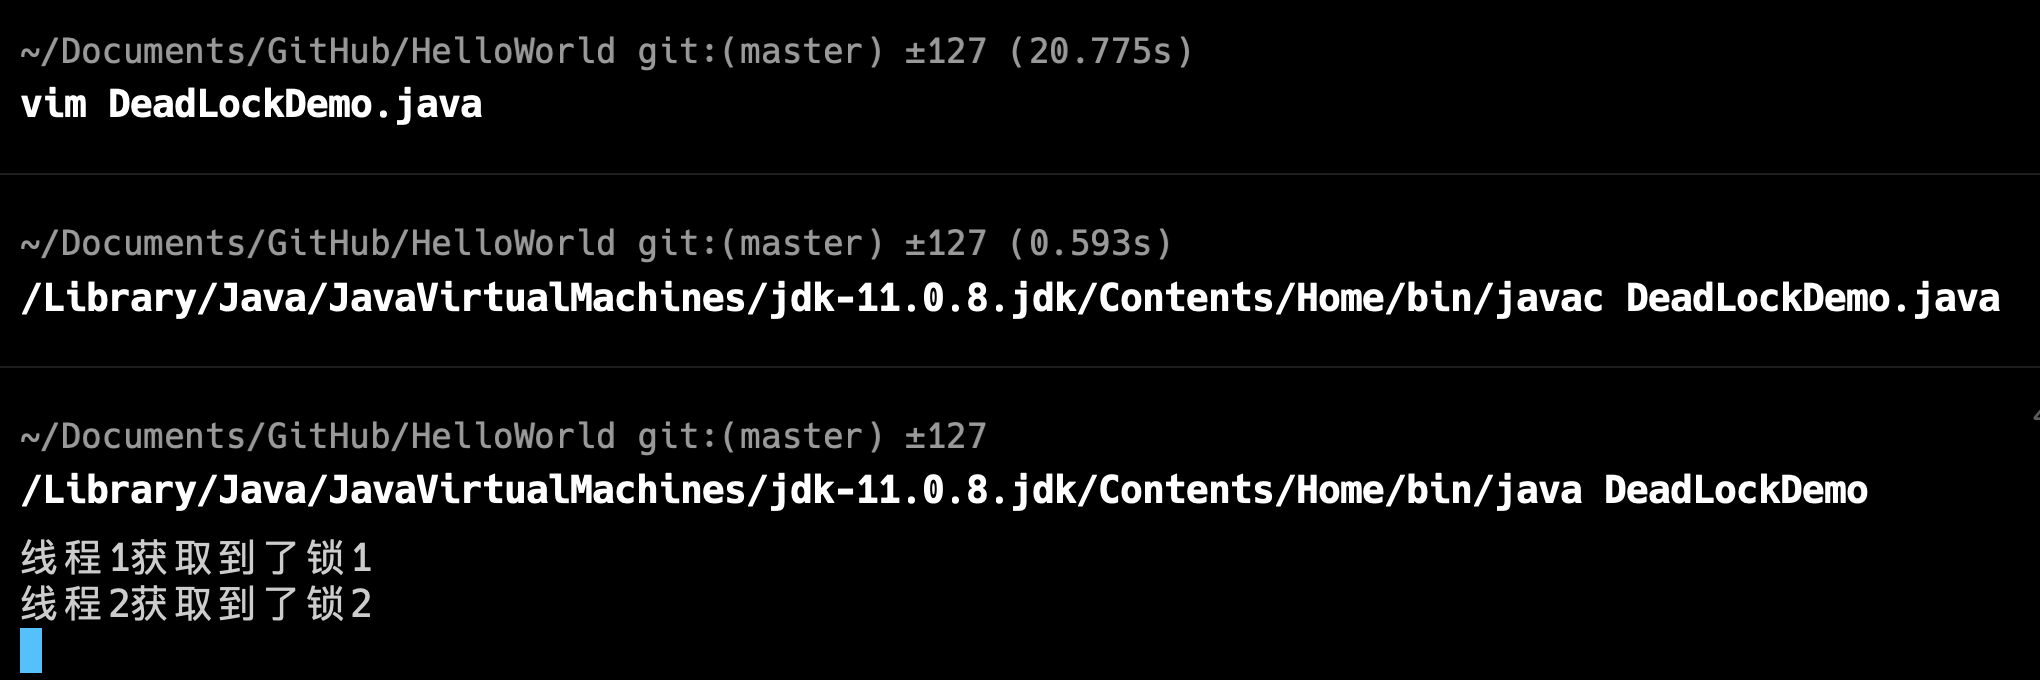
运行 jstack pid 命令,可以看到死锁的线程信息。
编码时,尽量使用 tryLock() 代替 lock(),tryLock() 可以设置超时时间,避免线程一直等待。
同时,尽量避免一个线程同时获取多个锁,如果需要多个锁,可以按照固定的顺序获取。
推荐阅读:
memo:2025 年 02 月 14 日修改至此。
41.聊聊线程同步和互斥?(补充)
2024 年 03 月 12 日 新增,推荐阅读:牛客:可能是全网最全的线程同步方式总结了
同步,意味着线程之间要密切合作,按照一定的顺序来执行任务。比如说,线程 A 先执行,线程 B 再执行。
互斥,意味着线程之间要抢占资源,同一时间只能有一个线程访问共享资源。比如说,线程 A 在访问共享资源时,线程 B 不能访问。
同步关注的是线程之间的协作,互斥关注的是线程之间的竞争。
如何实现同步和互斥?
可以使用 synchronized 关键字或者 Lock 接口的实现类,如 ReentrantLock 来给资源加锁。
锁在操作系统层面的意思是 Mutex,某个线程进入临界区后,也就是获取到锁后,其他线程不能再进入临界区,要阻塞等待持有锁的线程离开临界区。
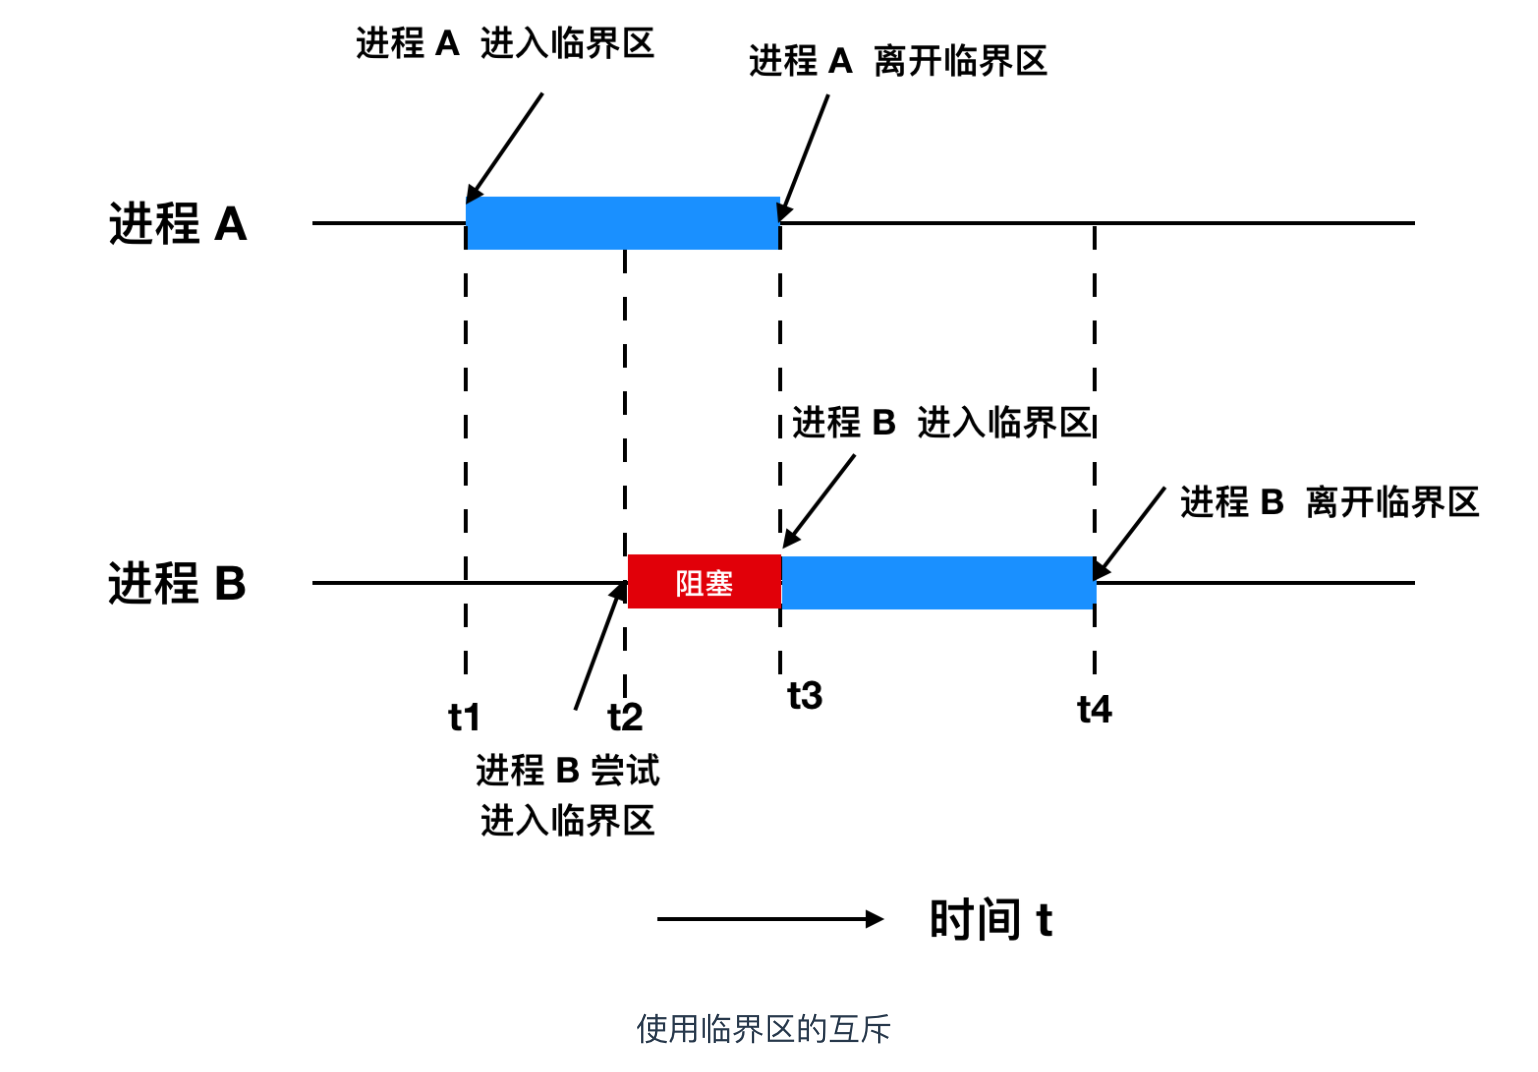
锁要解决哪些问题?
第一,谁可以拿到锁,可以是类对象,可以是当前的 this 对象,也可以是任何其他新建的对象。
synchronized (this) {
    // 临界区
}第二,抢占锁的规则,能不能抢占多次,自己能不能反复抢。
第三,抢不到怎么办,自旋?阻塞?或者超时放弃?
第四,锁被释放了还在等待锁的线程怎么办?是通知所有线程一起抢或者只告诉一个线程抢?
说说自旋锁?
自旋锁是指当线程尝试获取锁时,如果锁已经被占用,线程不会立即阻塞,而是通过自旋,也就是循环等待的方式不断尝试获取锁。
线程1        线程2
   |            |
   | 获取锁成功   | 尝试获取锁
   |------------>|(锁已被占用,自旋等待)
   | 释放锁      |
   |<------------| 获取锁成功
| |适用于锁持有时间短的场景,ReentrantLock 的 tryLock 方法就用到了自旋锁。
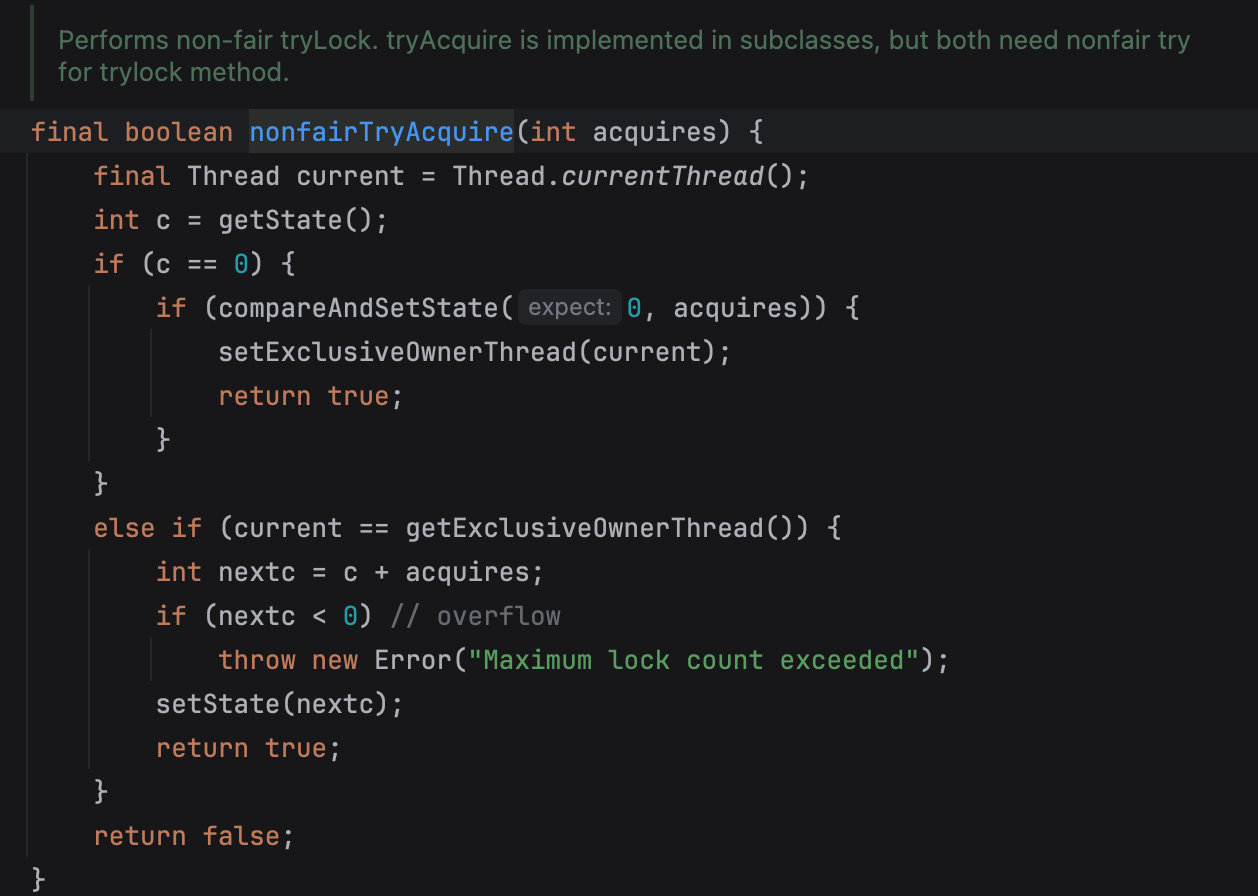
自旋锁的优点是可以避免线程切换带来的开销,缺点是如果锁被占用时间过长,会导致线程空转,浪费 CPU 资源。
class SpinLock {
    private AtomicBoolean lock = new AtomicBoolean(false);

    public void lock() {
        while (!lock.compareAndSet(false, true)) {
            // 自旋等待,不断尝试获取锁
        }
    }

    public void unlock() {
        lock.set(false);
    }

    public static void main(String[] args) {
        SpinLock spinLock = new SpinLock();

        Runnable task = () -> {
            spinLock.lock();
            try {
                System.out.println(Thread.currentThread().getName() + " 获取到锁");
            } finally {
                spinLock.unlock();
            }
        };

        Thread t1 = new Thread(task);
        Thread t2 = new Thread(task);

        t1.start();
        t2.start();
    }
}默认情况下,自旋锁会一直等待,直到获取到锁为止。在实际开发中,需要设置自旋次数或者超时时间。如果超过阈值,线程可以放弃锁或者进入阻塞状态。
互斥和同步在时间上有要求吗?
有。
互斥的核心是保证同一时刻只有一个线程能访问共享资源。
同步强调的是线程之间的执行顺序,特别是在多个线程需要依赖于彼此的执行结果时。
例如,在 CountDownLatch 中,主线程会等待多个子线程的任务完成。
class SyncExample {
    public static void main(String[] args) throws InterruptedException {
        CountDownLatch latch = new CountDownLatch(3);

        // 创建3个子线程
        for (int i = 0; i < 3; i++) {
            new Thread(() -> {
                try {
                    Thread.sleep(1000); // 模拟任务
                    System.out.println("打完王者了.");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } finally {
                    latch.countDown(); // 每个线程任务完成后计数器减1
                }
            }).start();
        }

        System.out.println("等打完三把王者就去睡觉...");
        latch.await(); // 主线程等待子线程完成
        System.out.println("好,王者玩完了,可以睡了");
    }
}所有子线程完成后,主线程才会继续执行。
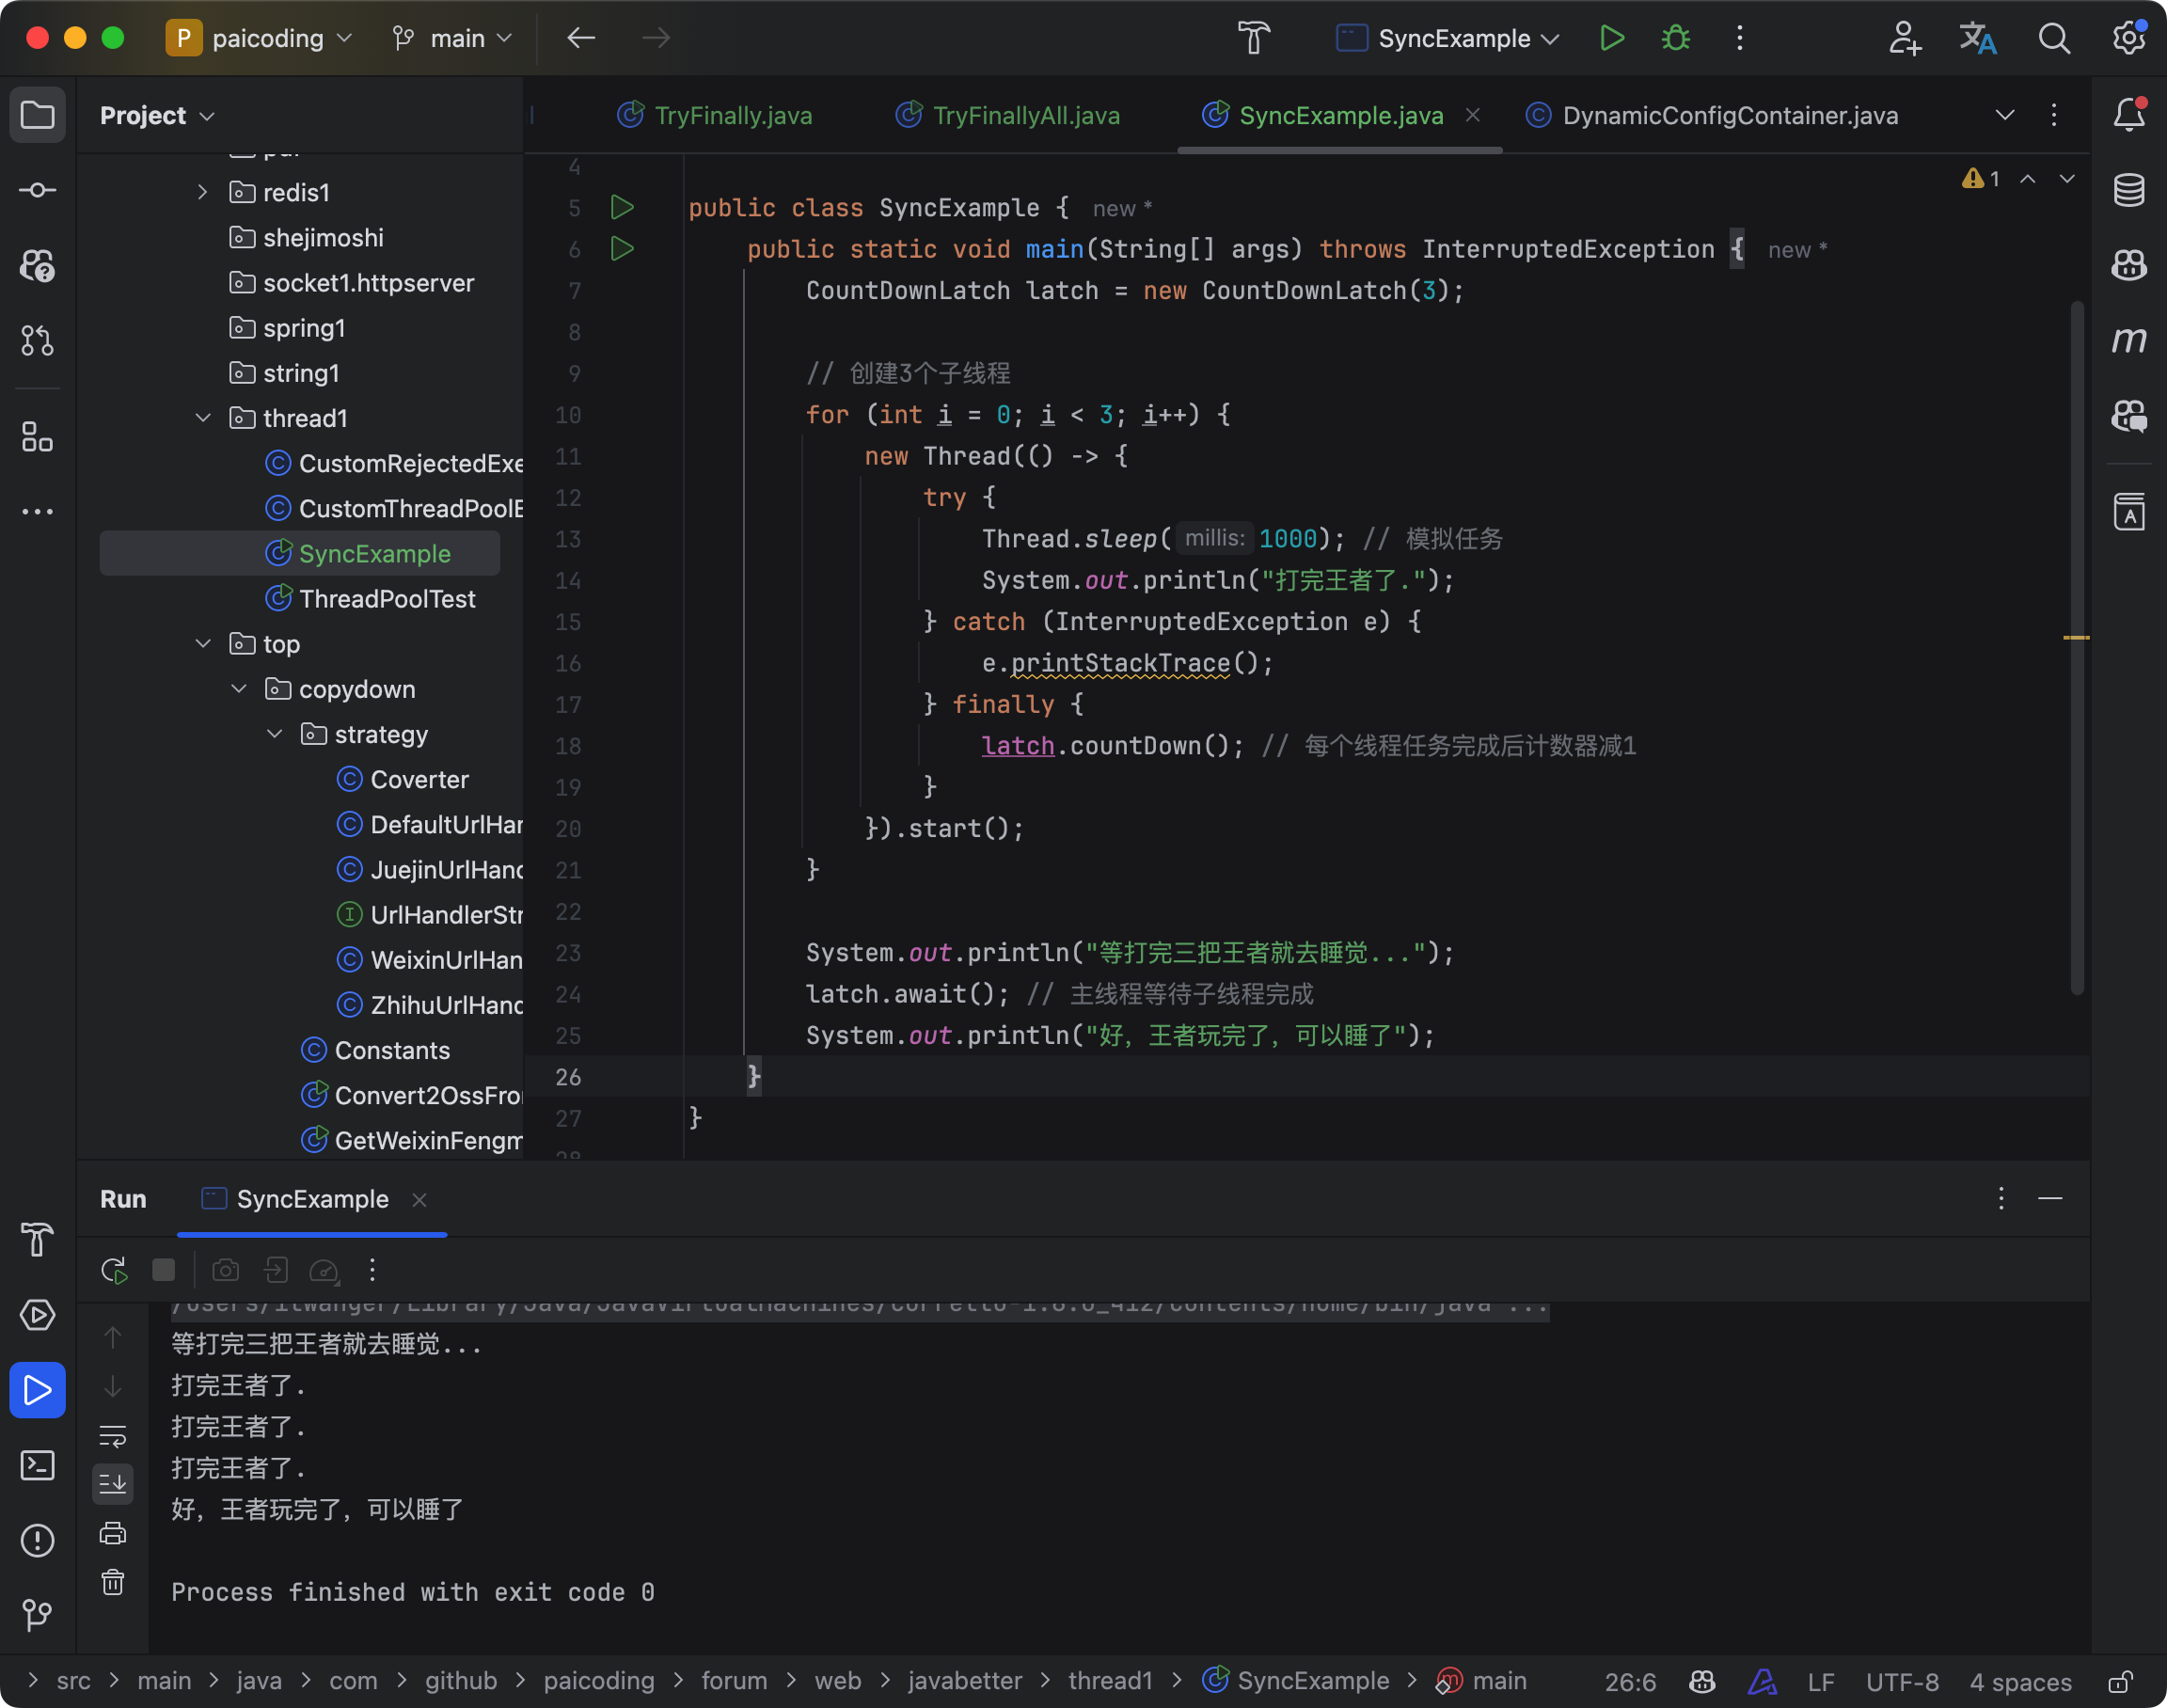
42.聊聊悲观锁和乐观锁?(补充)
2024 年 05 月 01 日增补
好的。
悲观锁认为每次访问共享资源时都会发生冲突,所在在操作前一定要先加锁,防止其他线程修改数据。
乐观锁认为冲突不会总是发生,所以在操作前不加锁,而是在更新数据时检查是否有其他线程修改了数据。如果发现数据被修改了,就会重试。
乐观锁发现有线程过来修改数据,怎么办?
可以重新读取数据,然后再尝试更新,直到成功为止或达到最大重试次数。
读取数据 -> 尝试更新 -> 成功(返回成功)
               |
-> 失败 -> 重试 -> 达到最大次数 -> 返回失败写个代码演示一下:
class CasRetryExample {
    private static AtomicInteger counter = new AtomicInteger(0);
    private static final int MAX_RETRIES = 5;

    public static void main(String[] args) {
        boolean success = false;
        int retries = 0;

        while (retries < MAX_RETRIES) {
            int currentValue = counter.get();
            boolean updated = counter.compareAndSet(currentValue, currentValue + 1);

            if (updated) {
                System.out.println("更新成功,当前值: " + counter.get());
                success = true;
                break;
            } else {
                retries++;
                System.out.println("更新失败,进行第 " + retries + " 次重试");
            }
        }

        if (!success) {
            System.out.println("达到最大重试次数,操作失败");
        }
    }
}memo:2025 年 02 月 15 日修改至此。
并发工具类
43.CountDownLatch 了解吗?
推荐阅读:Semaphore、Exchanger、CountDownLatch、CyclicBarrier、Phaser,一网打尽
CountDownLatch 是 JUC 中的一个同步工具类,用于协调多个线程之间的同步,确保主线程在多个子线程完成任务后继续执行。
它的核心思想是通过一个倒计时计数器来控制多个线程的执行顺序。
class CountDownLatchExample {
    public static void main(String[] args) throws InterruptedException {
        int threadCount = 3;
        CountDownLatch latch = new CountDownLatch(threadCount);

        for (int i = 0; i < threadCount; i++) {
            new Thread(() -> {
                try {
                    Thread.sleep((long) (Math.random() * 1000)); // 模拟任务执行
                    System.out.println(Thread.currentThread().getName() + " 执行完毕");
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } finally {
                    latch.countDown(); // 线程完成后,计数器 -1
                }
            }).start();
        }

        latch.await(); // 主线程等待
        System.out.println("所有子线程执行完毕,主线程继续执行");
    }
}在使用的时候,我们需要先初始化一个 CountDownLatch 对象,指定一个计数器的初始值,表示需要等待的线程数量。
然后在每个子线程执行完任务后,调用 countDown() 方法,计数器减 1。
接着主线程调用 await() 方法进入阻塞状态,直到计数器为 0,也就是所有子线程都执行完任务后,主线程才会继续执行。
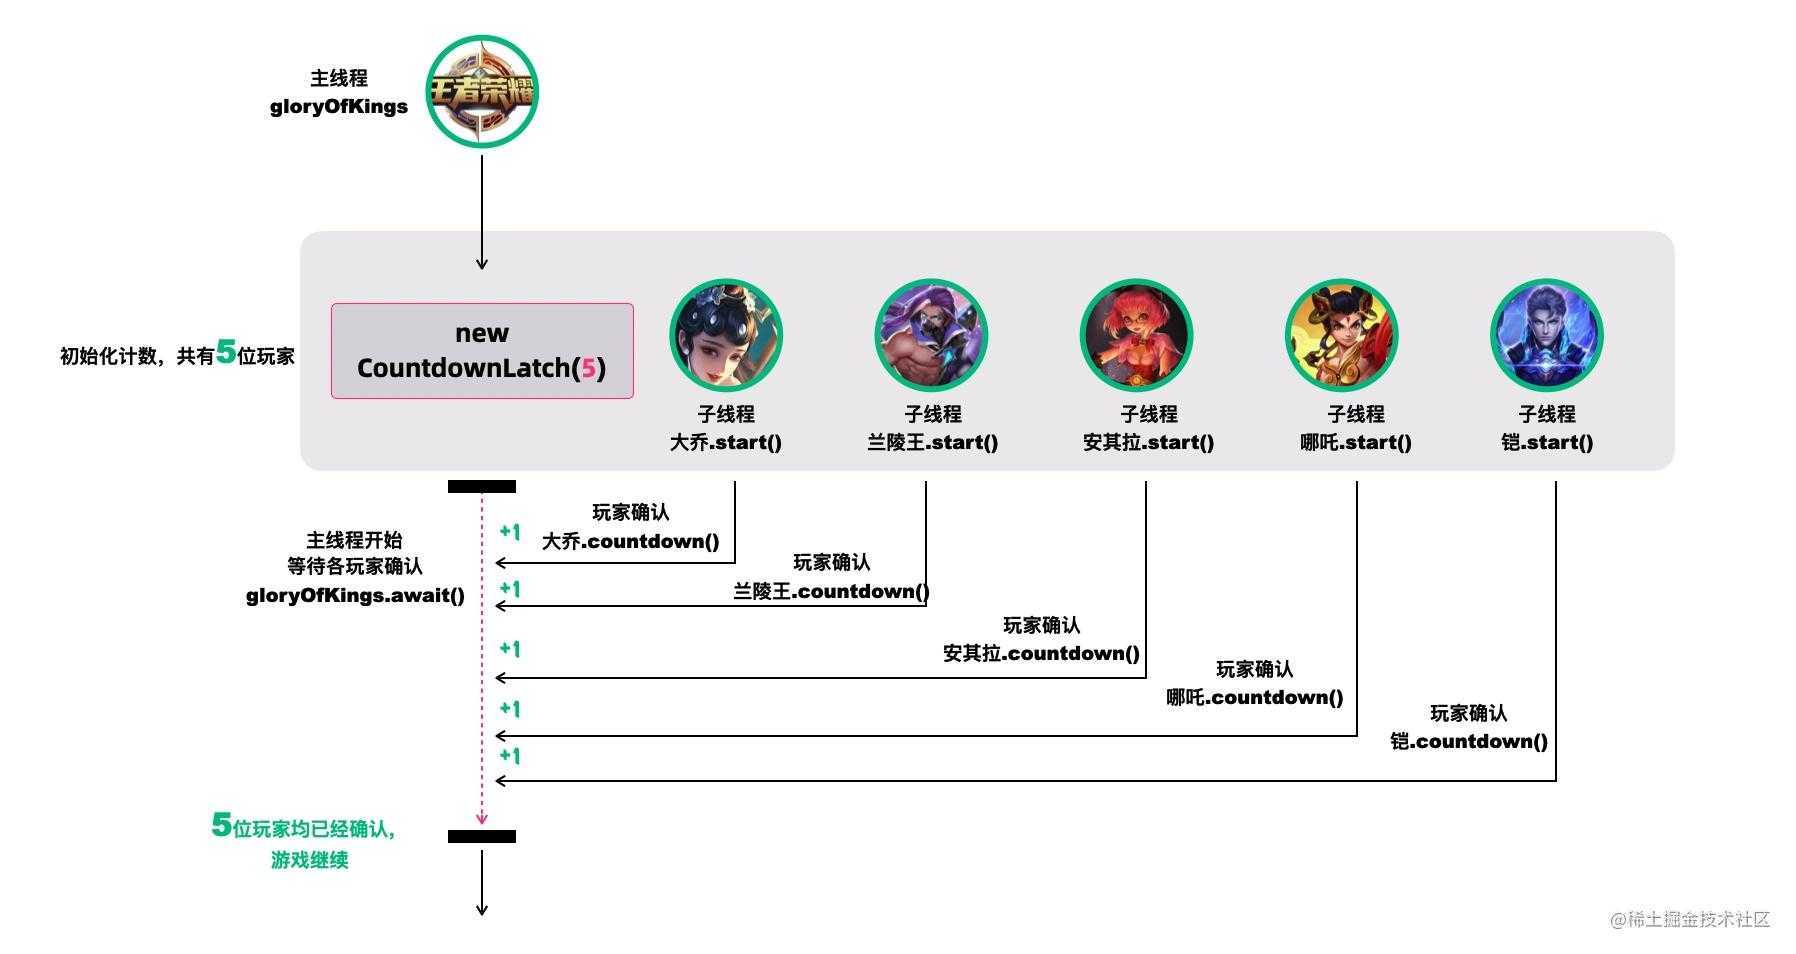
以王者荣耀为例,我们来创建五个线程,分别代表大乔、兰陵王、安其拉、哪吒和铠。每个玩家都调用 countDown() 方法,表示已就位。主线程调用 await() 方法,等待所有玩家就位。
public static void main(String[] args) throws InterruptedException {
    CountDownLatch countDownLatch = new CountDownLatch(5);

    Thread daqiao = new Thread(() -> {
        System.out.println("大乔已就位!");
        countDownLatch.countDown();
    });
    Thread lanlingwang = new Thread(() -> {
        System.out.println("兰陵王已就位!");
        countDownLatch.countDown();
    });
    Thread anqila = new Thread(() -> {
        System.out.println("安其拉已就位!");
        countDownLatch.countDown();
    });
    Thread nezha = new Thread(() -> {
        System.out.println("哪吒已就位!");
        countDownLatch.countDown();
    });
    Thread kai = new Thread(() -> {
        System.out.println("铠已就位!");
        countDownLatch.countDown();
    });

    daqiao.start();
    lanlingwang.start();
    anqila.start();
    nezha.start();
    kai.start();

    countDownLatch.await();
    System.out.println("全员就位,开始游戏!");
}五个玩家在倒计时结束后,一起出击。
private static void waitToFight(CountDownLatch countDownLatch, String name) {
    try {
        countDownLatch.await(); // 在此等待信号再继续
        System.out.println(name + " 收到,发起进攻!");
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        System.out.println(name + " 被中断");
    }
}

public static void main(String[] args) {
    CountDownLatch countDownLatch = new CountDownLatch(1);

    Thread daqiao = new Thread(() -> waitToFight(countDownLatch, "大乔"), "Thread-大乔");
    Thread lanlingwang = new Thread(() -> waitToFight(countDownLatch, "兰陵王"), "Thread-兰陵王");
    Thread anqila = new Thread(() -> waitToFight(countDownLatch, "安琪拉"), "Thread-安琪拉");
    Thread nezha = new Thread(() -> waitToFight(countDownLatch, "哪吒"), "Thread-哪吒");
    Thread kai = new Thread(() -> waitToFight(countDownLatch, "凯"), "Thread-凯");

    daqiao.start();
    lanlingwang.start();
    anqila.start();
    nezha.start();
    kai.start();

    try {
        Thread.sleep(5000); // 模拟准备时间
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        System.out.println("主线程被中断");
    }

    System.out.println("敌军还有 5 秒到达战场,全军出击!");
    countDownLatch.countDown(); // 发出信号
}场景题:假如要查 10 万多条数据,用线程池分成 20 个线程去执行,怎么做到等所有的线程都查找完之后,即最后一条结果查找结束了,才输出结果?
很简单,可以使用 CountDownLatch 来实现。CountDownLatch 非常适合这个场景。
第一步,创建 CountDownLatch 对象,初始值设定为 20,表示 20 个线程需要完成任务。
第二步,创建线程池,每个线程执行查询操作,查询完毕后调用 countDown() 方法,计数器减 1。
第三步,主线程调用 await() 方法,等待所有线程执行完毕。
class DataQueryExample {

    public static void main(String[] args) throws InterruptedException {
        // 模拟10万条数据
        int totalRecords = 100000;
        int threadCount = 20;
        int batchSize = totalRecords / threadCount; // 每个线程处理的数据量

        // 创建线程池
        ExecutorService executor = Executors.newFixedThreadPool(threadCount);
        CountDownLatch latch = new CountDownLatch(threadCount);

        // 模拟查询结果
        ConcurrentLinkedQueue<String> results = new ConcurrentLinkedQueue<>();

        for (int i = 0; i < threadCount; i++) {
            int start = i * batchSize;
            int end = (i == threadCount - 1) ? totalRecords : (start + batchSize);

            executor.execute(() -> {
                try {
                    // 模拟查询操作
                    for (int j = start; j < end; j++) {
                        results.add("Data-" + j);
                    }
                    System.out.println(Thread.currentThread().getName() + " 处理数据 " + start + " - " + end);
                } finally {
                    latch.countDown(); // 线程任务完成,计数器减1
                }
            });
        }

        // 等待所有线程完成
        latch.await();
        executor.shutdown();

        // 输出结果
        System.out.println("所有线程执行完毕,查询结果总数:" + results.size());
    }
}44.CyclicBarrier 了解吗?
了解。
CyclicBarrier 的字面意思是可循环使用的屏障,用于多个线程相互等待,直到所有线程都到达屏障后再同时执行。

在使用的时候,我们需要先初始化一个 CyclicBarrier 对象,指定一个屏障值 N,表示需要等待的线程数量。
然后每个线程执行 await() 方法,表示自己已经到达屏障,等待其他线程,此时屏障值会减 1。
当所有线程都到达屏障后,也就是屏障值为 0 时,所有线程会继续执行。
class CyclicBarrierExample {
    private static final int THREAD_COUNT = 3;
    private static final CyclicBarrier barrier = new CyclicBarrier(THREAD_COUNT);

    public static void main(String[] args) {
        for (int i = 0; i < THREAD_COUNT; i++) {
            new Thread(() -> {
                try {
                    System.out.println(Thread.currentThread().getName() + " 到达屏障");
                    barrier.await(); // 线程阻塞,直到所有线程都到达
                    System.out.println(Thread.currentThread().getName() + " 继续执行");
                } catch (InterruptedException | BrokenBarrierException e) {
                    e.printStackTrace();
                }
            }).start();
        }
    }
}45.CyclicBarrier 和 CountDownLatch 有什么区别?
CyclicBarrier 让所有线程相互等待,全部到达后再继续;CountDownLatch 让主线程等待所有子线程执行完再继续。
| 对比项 | CyclicBarrier | CountDownLatch |
|---|---|---|
| 主要用途 | 让所有线程相互等待,全部到达后再继续 | 让主线程等待所有子线程执行完 |
| 可重用性 | ✅ 可重复使用,每次屏障打开后自动重置 | ❌ 不可重复使用,计数器归零后不能恢复 |
| 是否可执行回调 | ✅ 可以,所有线程到达屏障后可执行 barrierAction | ❌ 不能 |
| 线程等待情况 | 所有线程互相等待,一个线程未到达,其他线程都会阻塞 | 主线程等待所有子线程完成,子线程执行完后可继续运行 |
| 适用场景 | 线程相互依赖,需要同步执行 | 主线程等待子线程完成 |
| 示例场景 | 计算任务拆分,所有线程都到达后才能继续 | 主线程等多个任务初始化完成 |
46.Semaphore 了解吗?
Semaphore——信号量,用于控制同时访问某个资源的线程数量,类似限流器,确保最多只有指定数量的线程能够访问某个资源,超过的必须等待。
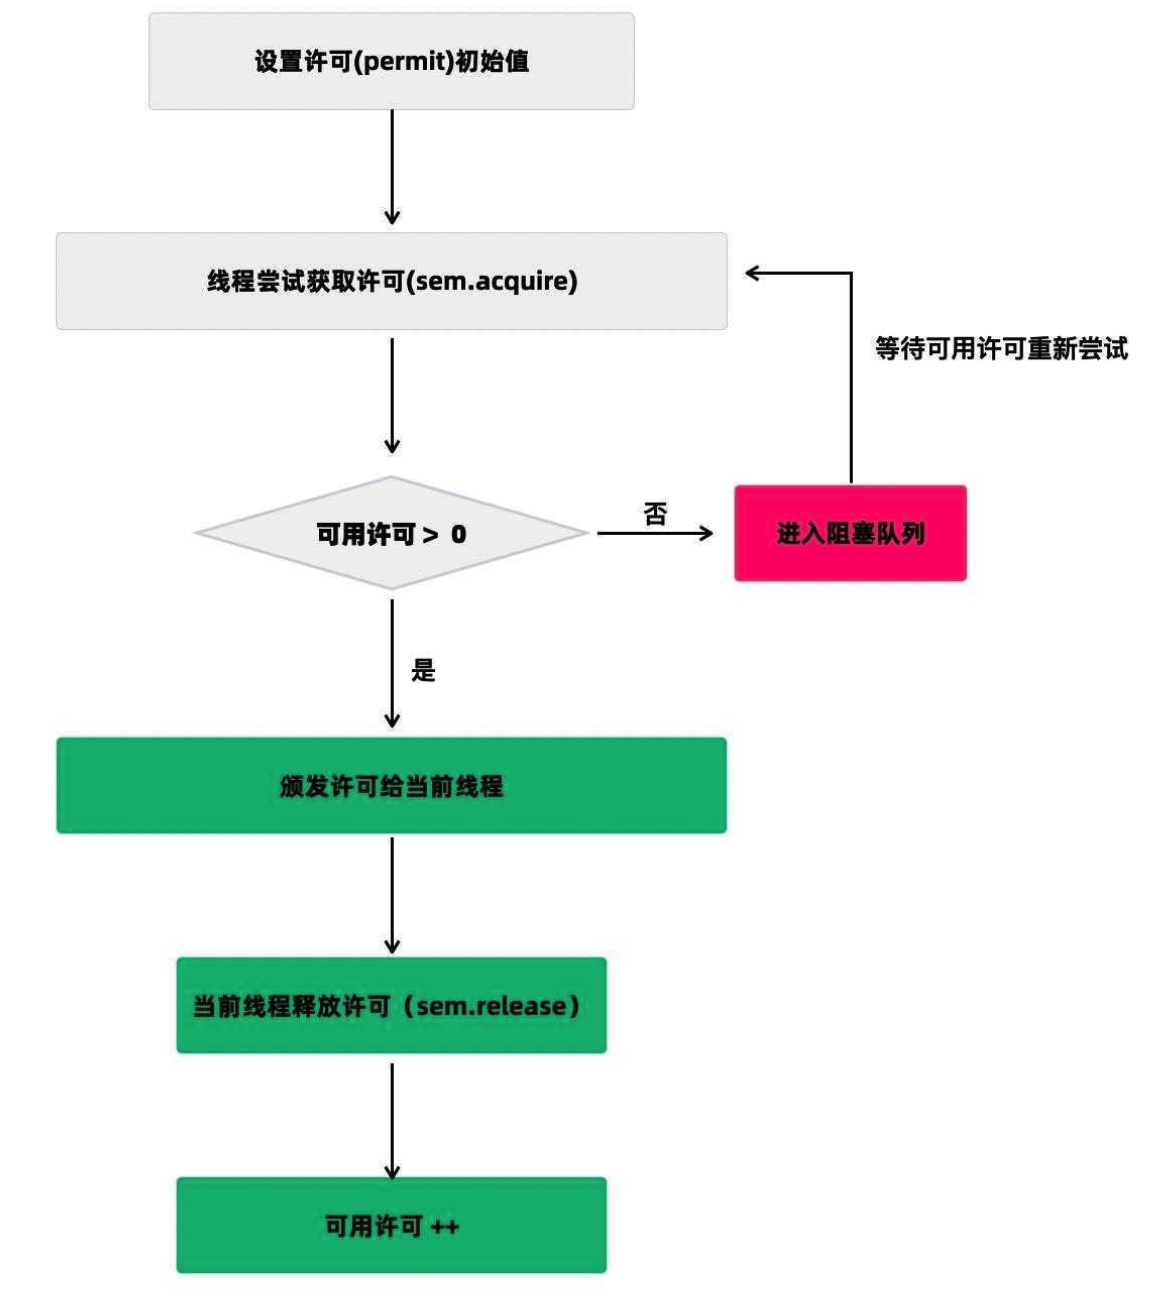
拿停车场来举例。
停车场的车位是有限的,如果有空位,显示牌需要显示剩余的车位,车辆就可以驶入;否则就会显示数字 0,新来的车辆就得排队等待。
如果有车离开,显示牌重新显示闲置的车位数量,等待的车辆按序驶入停车场。
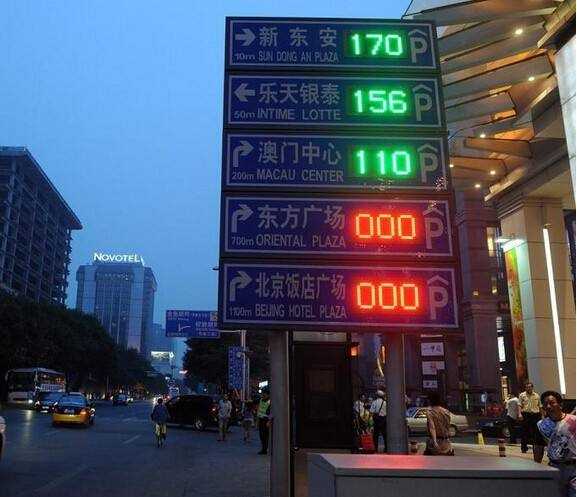
在使用 Semaphore 时,首先需要初始化一个 Semaphore 对象,指定许可证数量,表示最多允许多少个线程同时访问资源。
然后在每个线程访问资源前,调用 acquire() 方法获取许可证,如果没有可用许可证,则阻塞等待。
需要注意的是,访问完资源后,要调用 release() 方法释放许可证。
class SemaphoreExample {
    private static final int THREAD_COUNT = 5;
    private static final Semaphore semaphore = new Semaphore(2); // 最多允许 2 个线程访问

    public static void main(String[] args) {
        for (int i = 0; i < THREAD_COUNT; i++) {
            new Thread(() -> {
                try {
                    semaphore.acquire(); // 获取许可(如果没有可用许可,则阻塞)
                    System.out.println(Thread.currentThread().getName() + " 访问资源...");
                    Thread.sleep(2000); // 模拟任务执行
                } catch (InterruptedException e) {
                    e.printStackTrace();
                } finally {
                    semaphore.release(); // 释放许可
                }
            }).start();
        }
    }
}Semaphore 可以用于流量控制,比如数据库连接池、网络连接池等。
假如有这样一个需求,要读取几万个文件的数据,因为都是 IO 密集型任务,我们可以启动几十个线程并发地读取。
但是在读到内存后,需要存储到数据库,而数据库连接数是有限的,比如说只有 10 个,那我们就必须控制线程的数量,保证同时只有 10 个线程在使用数据库连接。
这个时候,就可以使用 Semaphore 来做流量控制:
class SemaphoreTest {
    private static final int THREAD_COUNT = 30;
    private static ExecutorService threadPool = Executors.newFixedThreadPool(THREAD_COUNT);
    private static Semaphore s = new Semaphore(10);

    public static void main(String[] args) {
        for (int i = 0; i < THREAD_COUNT; i++) {
            threadPool.execute(new Runnable() {
                @Override
                public void run() {
                    try {
                        s.acquire();
                        System.out.println("save data");
                        s.release();
                    } catch (InterruptedException e) {
                    }
                }
            });
        }
        threadPool.shutdown();
    }
}47.Exchanger 了解吗?
Exchanger——交换者,用于在两个线程之间进行数据交换。
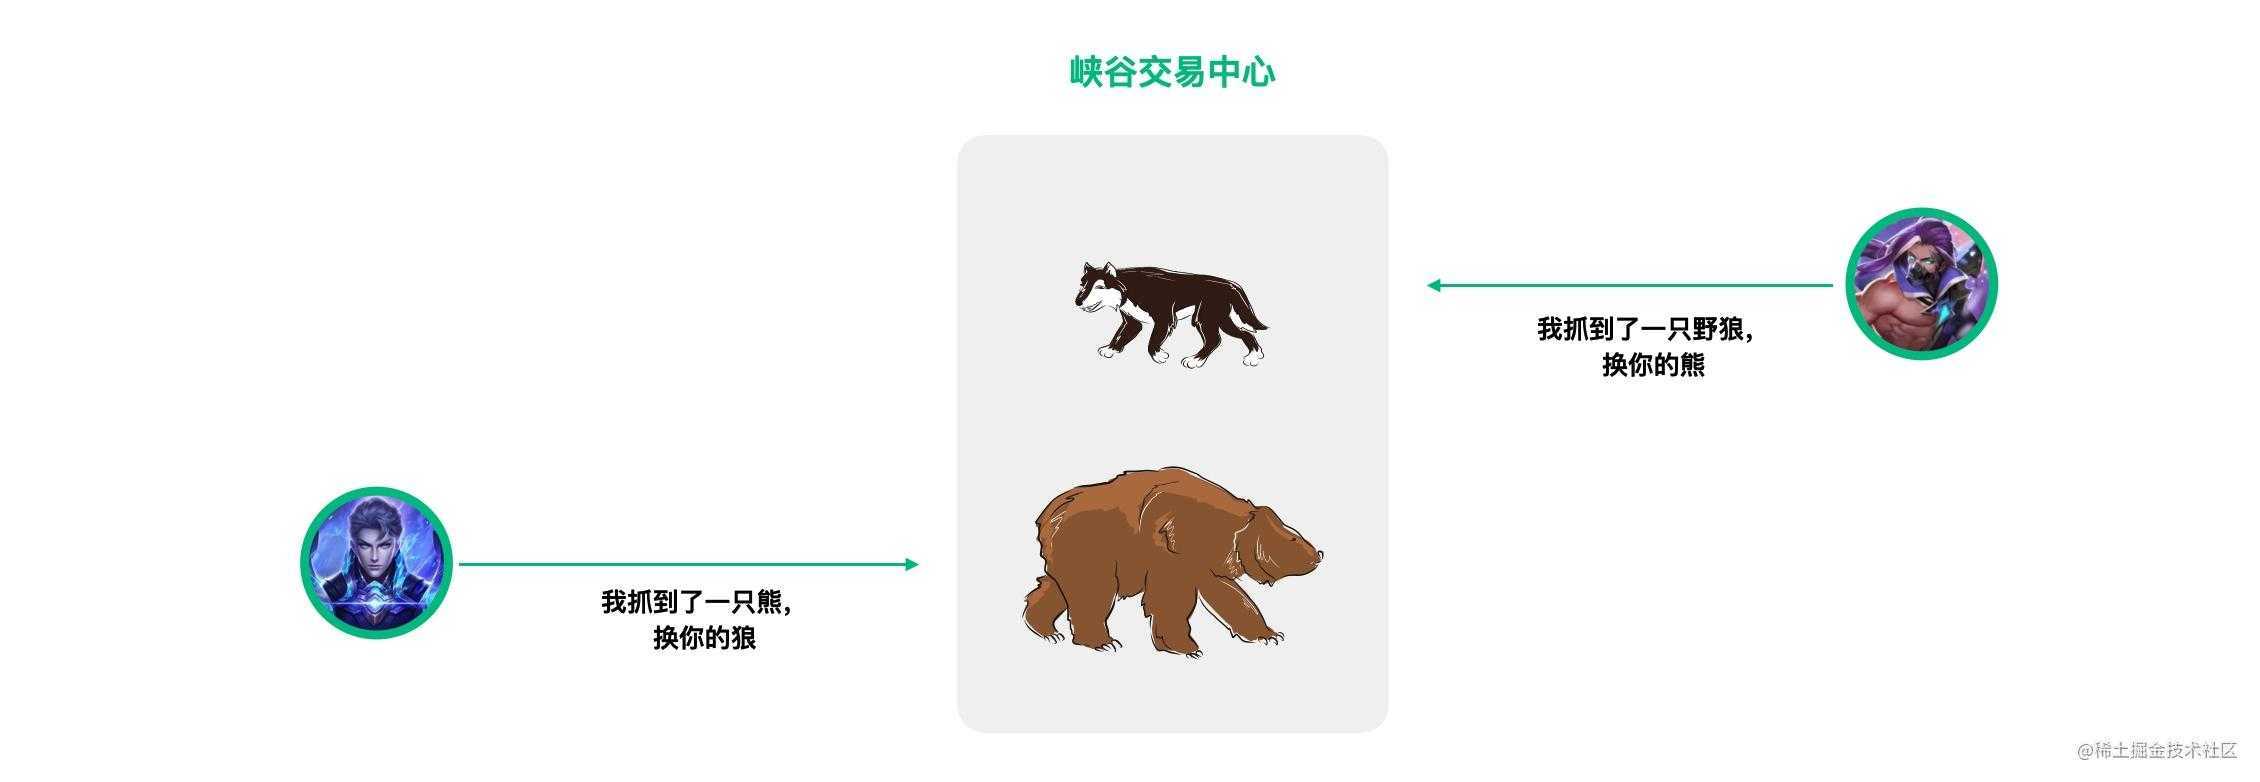
支持双向数据交换,比如说线程 A 调用 exchange(dataA),线程 B 调用 exchange(dataB),它们会在同步点交换数据,即 A 得到 B 的数据,B 得到 A 的数据。
如果一个线程先调用 exchange(),它会阻塞等待,直到另一个线程也调用 exchange()。
使用 Exchanger 的时候,需要先创建一个 Exchanger 对象,然后在两个线程中调用 exchange() 方法,就可以进行数据交换了。
class ExchangerExample {
    private static final Exchanger<String> exchanger = new Exchanger<>();

    public static void main(String[] args) {
        new Thread(() -> {
            try {
                String threadAData = "数据 A";
                System.out.println("线程 A 交换前的数据:" + threadAData);
                String received = exchanger.exchange(threadAData);
                System.out.println("线程 A 收到的数据:" + received);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }).start();

        new Thread(() -> {
            try {
                String threadBData = "数据 B";
                System.out.println("线程 B 交换前的数据:" + threadBData);
                String received = exchanger.exchange(threadBData);
                System.out.println("线程 B 收到的数据:" + received);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }).start();
    }
}Exchanger 可以用于遗传算法,也可以用于校对工作,比如我们将纸制银行流水通过人工的方式录入到电子银行时,为了避免错误,可以录入两遍,然后通过 Exchanger 来校对两次录入的结果。
class ExchangerTest {
    private static final Exchanger<String> exgr = new Exchanger<String>();
    private static ExecutorService threadPool = Executors.newFixedThreadPool(2);

    public static void main(String[] args) {
        threadPool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    String A = "银行流水A"; // A录入银行流水数据
                    exgr.exchange(A);
                } catch (InterruptedException e) {
                }
            }
        });
        threadPool.execute(new Runnable() {
            @Override
            public void run() {
                try {
                    String B = "银行流水B"; // B录入银行流水数据
                    String A = exgr.exchange("B");
                    System.out.println("A和B数据是否一致:" + A.equals(B) + ",A录入的是:"
                            + A + ",B录入是:" + B);
                } catch (InterruptedException e) {
                }
            }
        });
        threadPool.shutdown();
    }
}memo:2025 年 02 月 18 日修改至此。
🌟48.能说一下 ConcurrentHashMap 的实现吗?(补充)
2024 年 03 月 25 日增补,从集合框架篇移到这里。
好的。ConcurrentHashMap 是 HashMap 的线程安全版本。
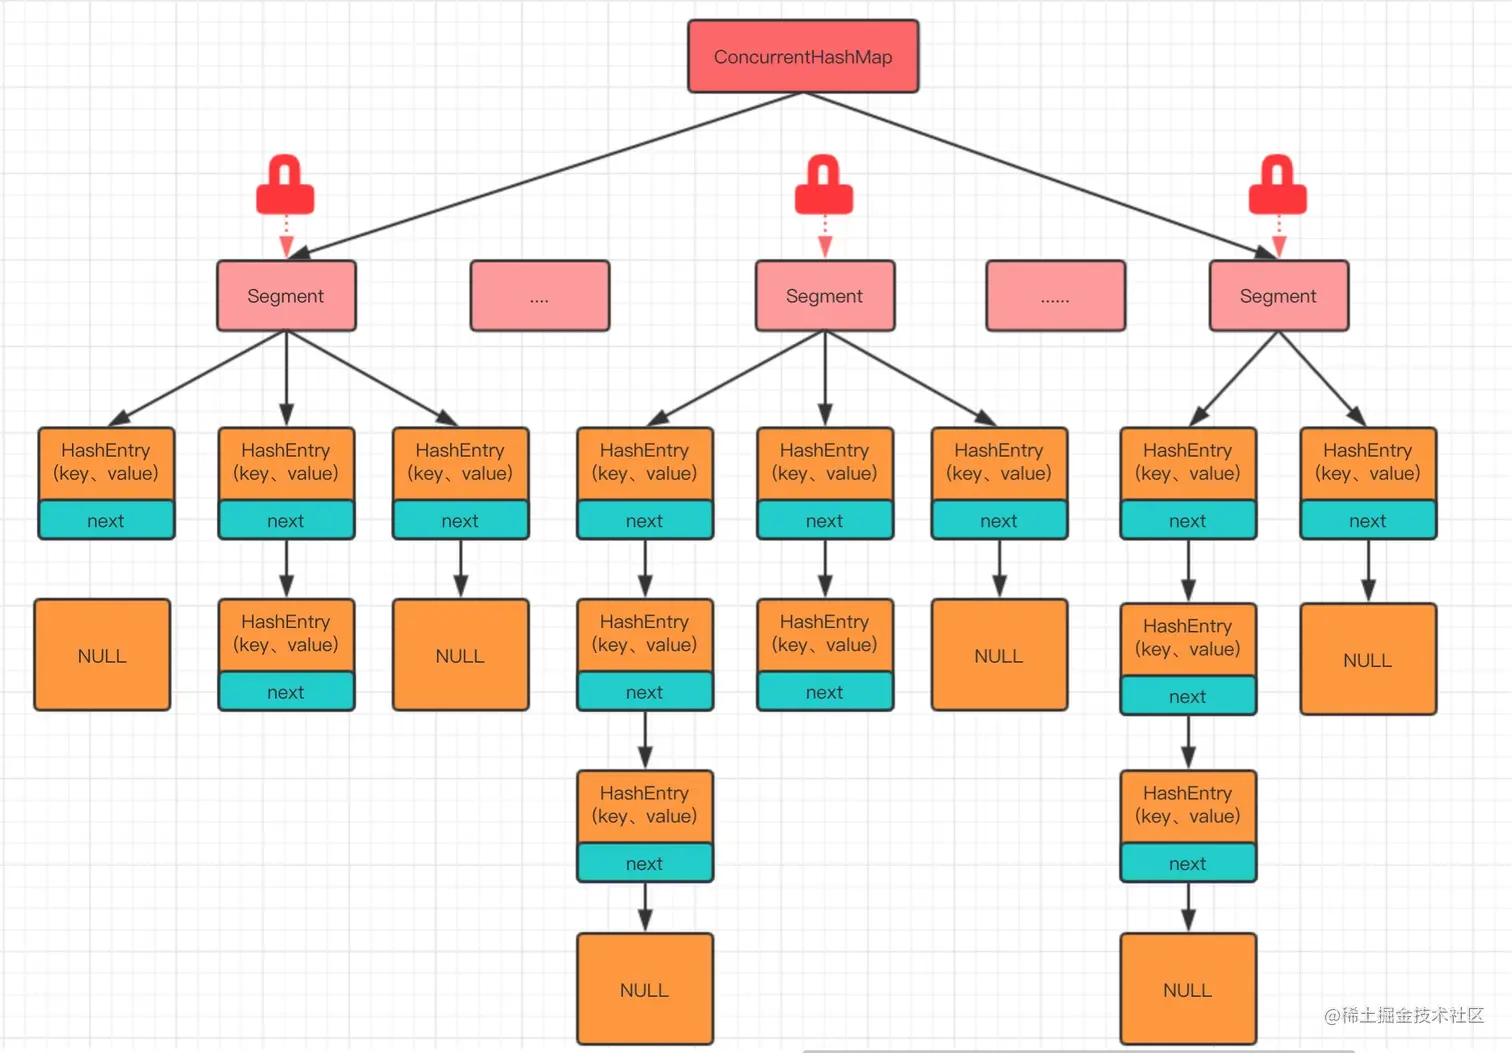
JDK 7 采用的是分段锁,整个 Map 会被分为若干段,每个段都可以独立加锁。不同的线程可以同时操作不同的段,从而实现并发。
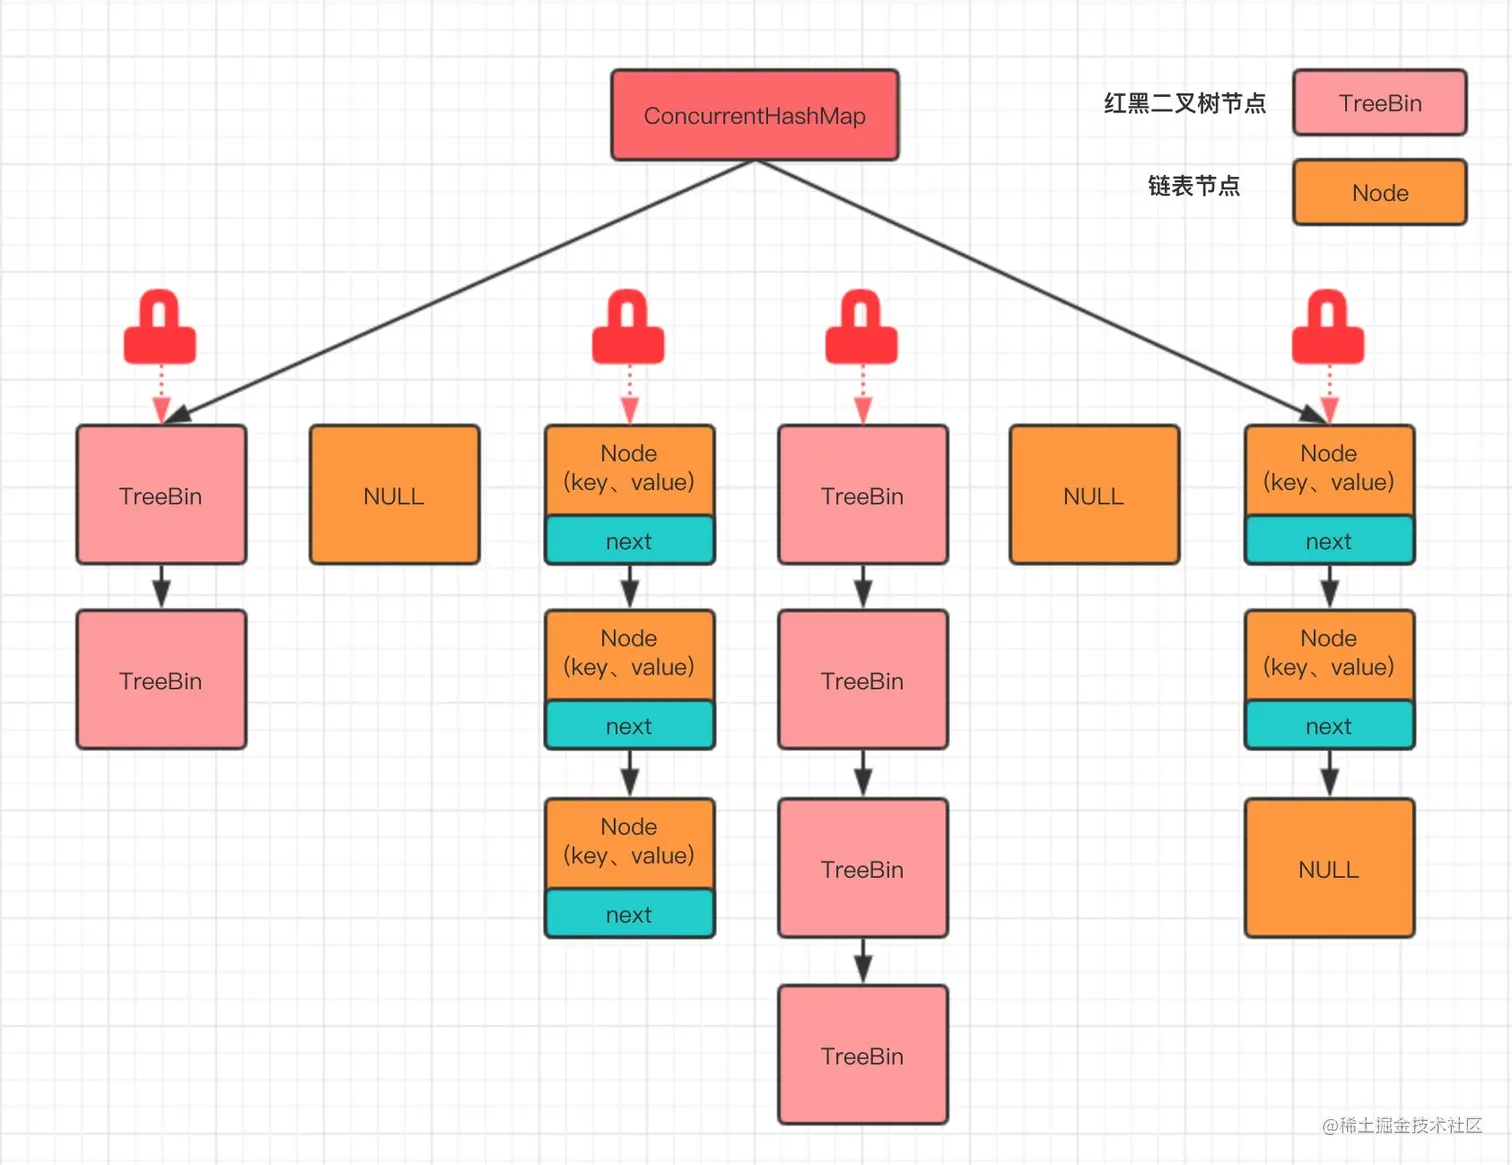
JDK 8 使用了一种更加细粒度的锁——桶锁,再配合 CAS + synchronized 代码块控制并发写入,以最大程度减少锁的竞争。
对于读操作,ConcurrentHashMap 使用了 volatile 变量来保证内存可见性。
对于写操作,ConcurrentHashMap 优先使用 CAS 尝试插入,如果成功就直接返回;否则使用 synchronized 代码块进行加锁处理。
说一下 JDK 7 中 ConcurrentHashMap 的实现原理?
好的。
JDK 7 的 ConcurrentHashMap 采用的是分段锁,整个 Map 会被分为若干段,每个段都可以独立加锁,每个段类似一个 Hashtable。
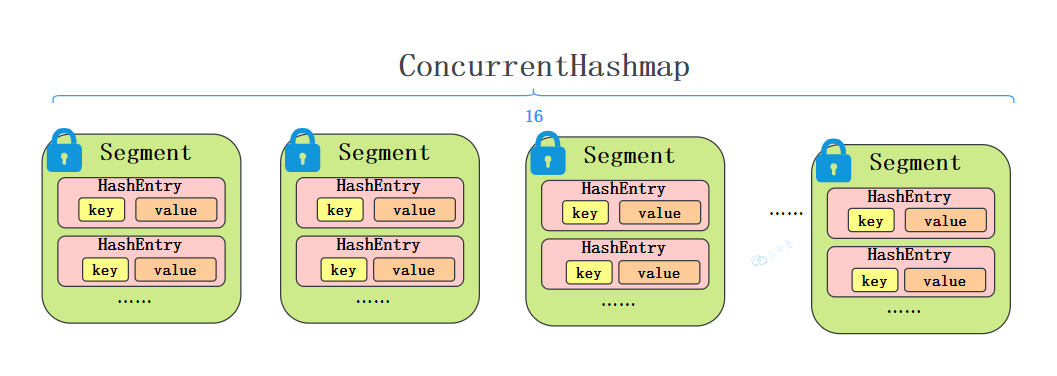
每个段维护一个键值对数组 HashEntry<K, V>[] table,HashEntry 是一个单项链表。
static final class HashEntry<K,V> {
    final int hash;
    final K key;
    volatile V value;
    final HashEntry<K,V> next;
}段继承了 ReentrantLock,所以每个段都是一个可重入锁,不同的线程可以同时操作不同的段,从而实现并发。
static final class Segment<K,V> extends ReentrantLock {
    transient volatile HashEntry<K,V>[] table;
    transient int count;
}说一下 JDK 7 中 ConcurrentHashMap 的 put 流程?
put 流程和 HashMap 非常类似,只不过是先定位到具体的段,再通过 ReentrantLock 去操作而已。一共可以分为 4 个步骤:
第一步,计算 key 的 hash,定位到段,段如果是空就先初始化;
第二步,使用 ReentrantLock 进行加锁,如果加锁失败就自旋,自旋超过次数就阻塞,保证一定能获取到锁;
第三步,遍历段中的键值对 HashEntry,key 相同直接替换,key 不存在就插入。
第四步,释放锁。
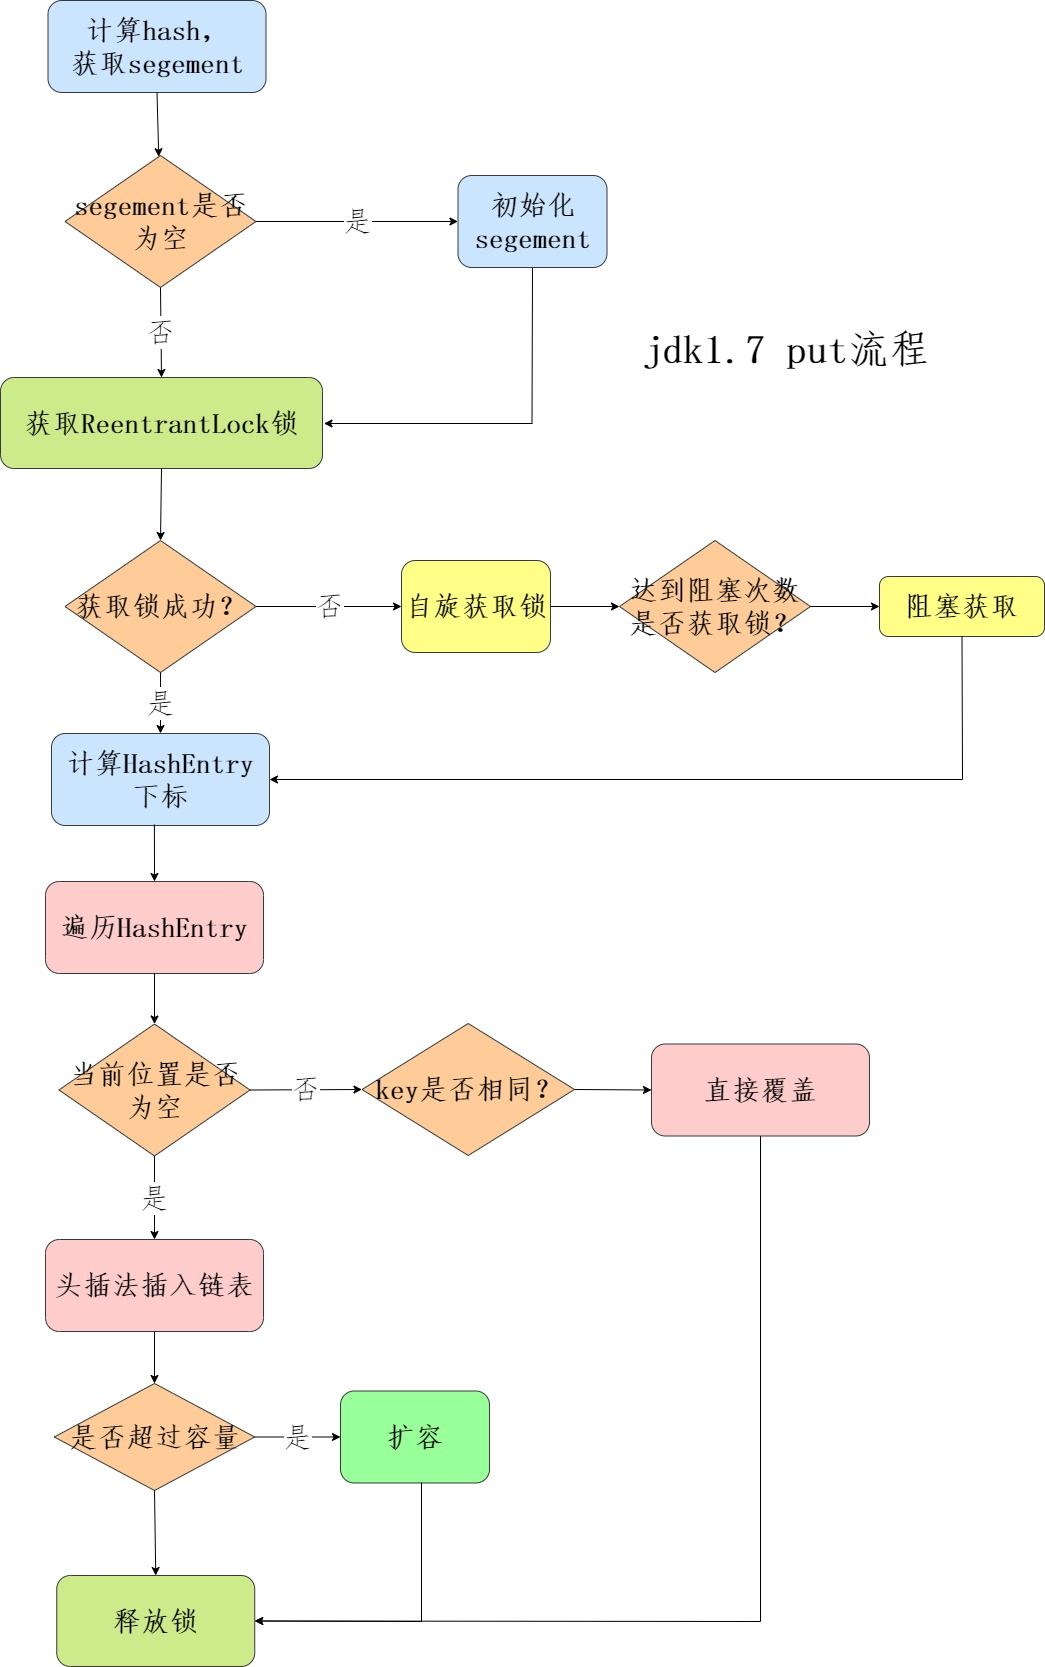
说一下 JDK 7 中 ConcurrentHashMap 的 get 流程?
get 就更简单了,先计算 key 的 hash 找到段,再遍历段中的键值对,找到就直接返回 value。
get 不用加锁,因为是 value 是 volatile 的,所以线程读取 value 时不会出现可见性问题。
说一下 JDK 8 中 ConcurrentHashMap 的实现原理?
好的。
JDK 8 中的 ConcurrentHashMap 取消了分段锁,采用 CAS + synchronized 来实现更细粒度的桶锁,并且使用红黑树来优化链表以提高哈希冲突时的查询效率,性能比 JDK 7 有了很大的提升。
说一下 JDK 8 中 ConcurrentHashMap 的 put 流程?

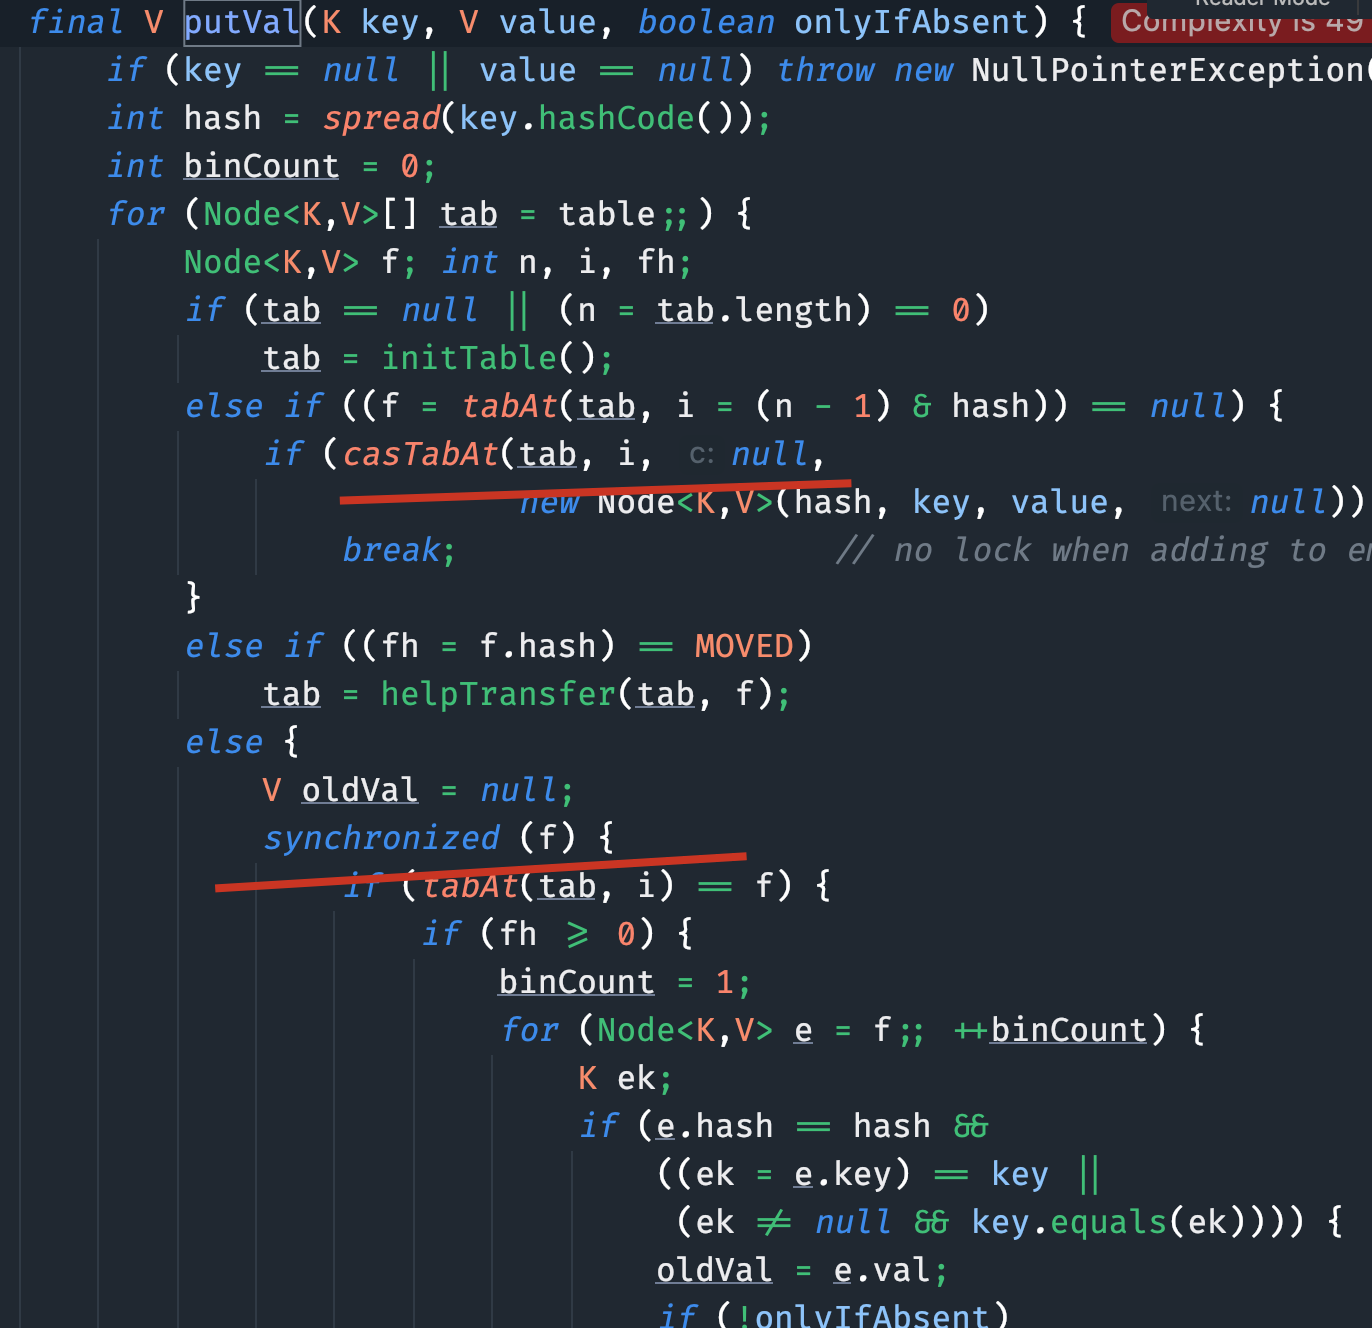
第一步,计算 key 的 hash,以确定桶在数组中的位置。如果数组为空,采用 CAS 的方式初始化,以确保只有一个线程在初始化数组。
// 计算 hash
int hash = spread(key.hashCode());

// 初始化数组
if (tab == null || (n = tab.length) == 0)
    tab = initTable();

// 计算桶的位置
int i = (n - 1) & hash;第二步,如果桶为空,直接 CAS 插入节点。如果 CAS 操作失败,会退化为 synchronized 代码块来插入节点。
// CAS 插入节点
if (tabAt(tab, i) == null) {
    if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null)))
        break;
}

// 否则,使用 synchronized 代码块插入节点
else {
    synchronized (f) {  // **只锁当前桶**
        if (tabAt(tab, i) == f) { // 确保未被其他线程修改
            if (f.hash >= 0) { // 链表处理
                for (Node<K,V> e = f;;) {
                    K ek;
                    if (e.hash == hash && ((ek = e.key) == key || (key != null && key.equals(ek)))) {
                        e.val = value;
                        break;
                    }
                    e = e.next;
                }
            } else if (f instanceof TreeBin) { // **红黑树处理**
                ((TreeBin<K,V>) f).putTreeVal(hash, key, value);
            }
        }
    }
}插入的过程中会判断桶的哈希是否小于 0(f.hash >= 0),小于 0 说明是红黑树,大于等于 0 说明是链表。
这里补充一点:在 ConcurrentHashMap 的实现中,红黑树节点 TreeBin 的 hash 值固定为 -2。
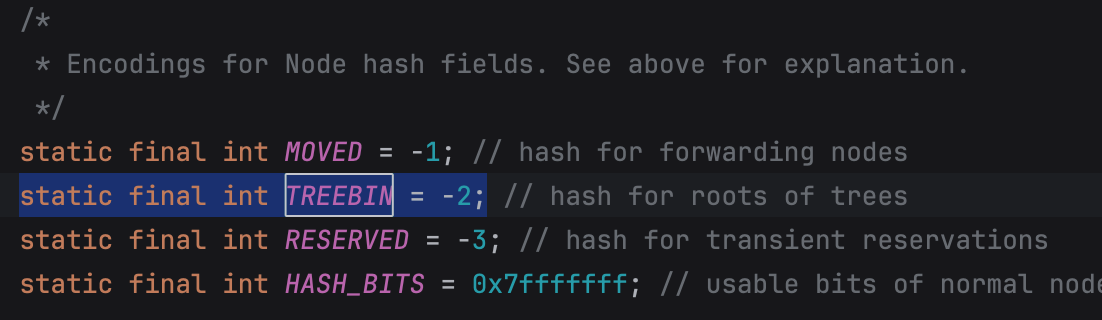
第三步,如果链表长度超过 8,转换为红黑树。
if (binCount >= TREEIFY_THRESHOLD)
treeifyBin(tab, i);第四步,在插入新节点后,会调用 addCount() 方法检查是否需要扩容。
addCount(1L, binCount);说一下 JDK 8 中 ConcurrentHashMap 的 get 流程?
get 也是通过 key 的 hash 进行定位,如果该位置节点的哈希匹配且键相等,则直接返回值。

如果节点的哈希为负数,说明是个特殊节点,比如说如树节点或者正在迁移的节点,就调用find方法查找。
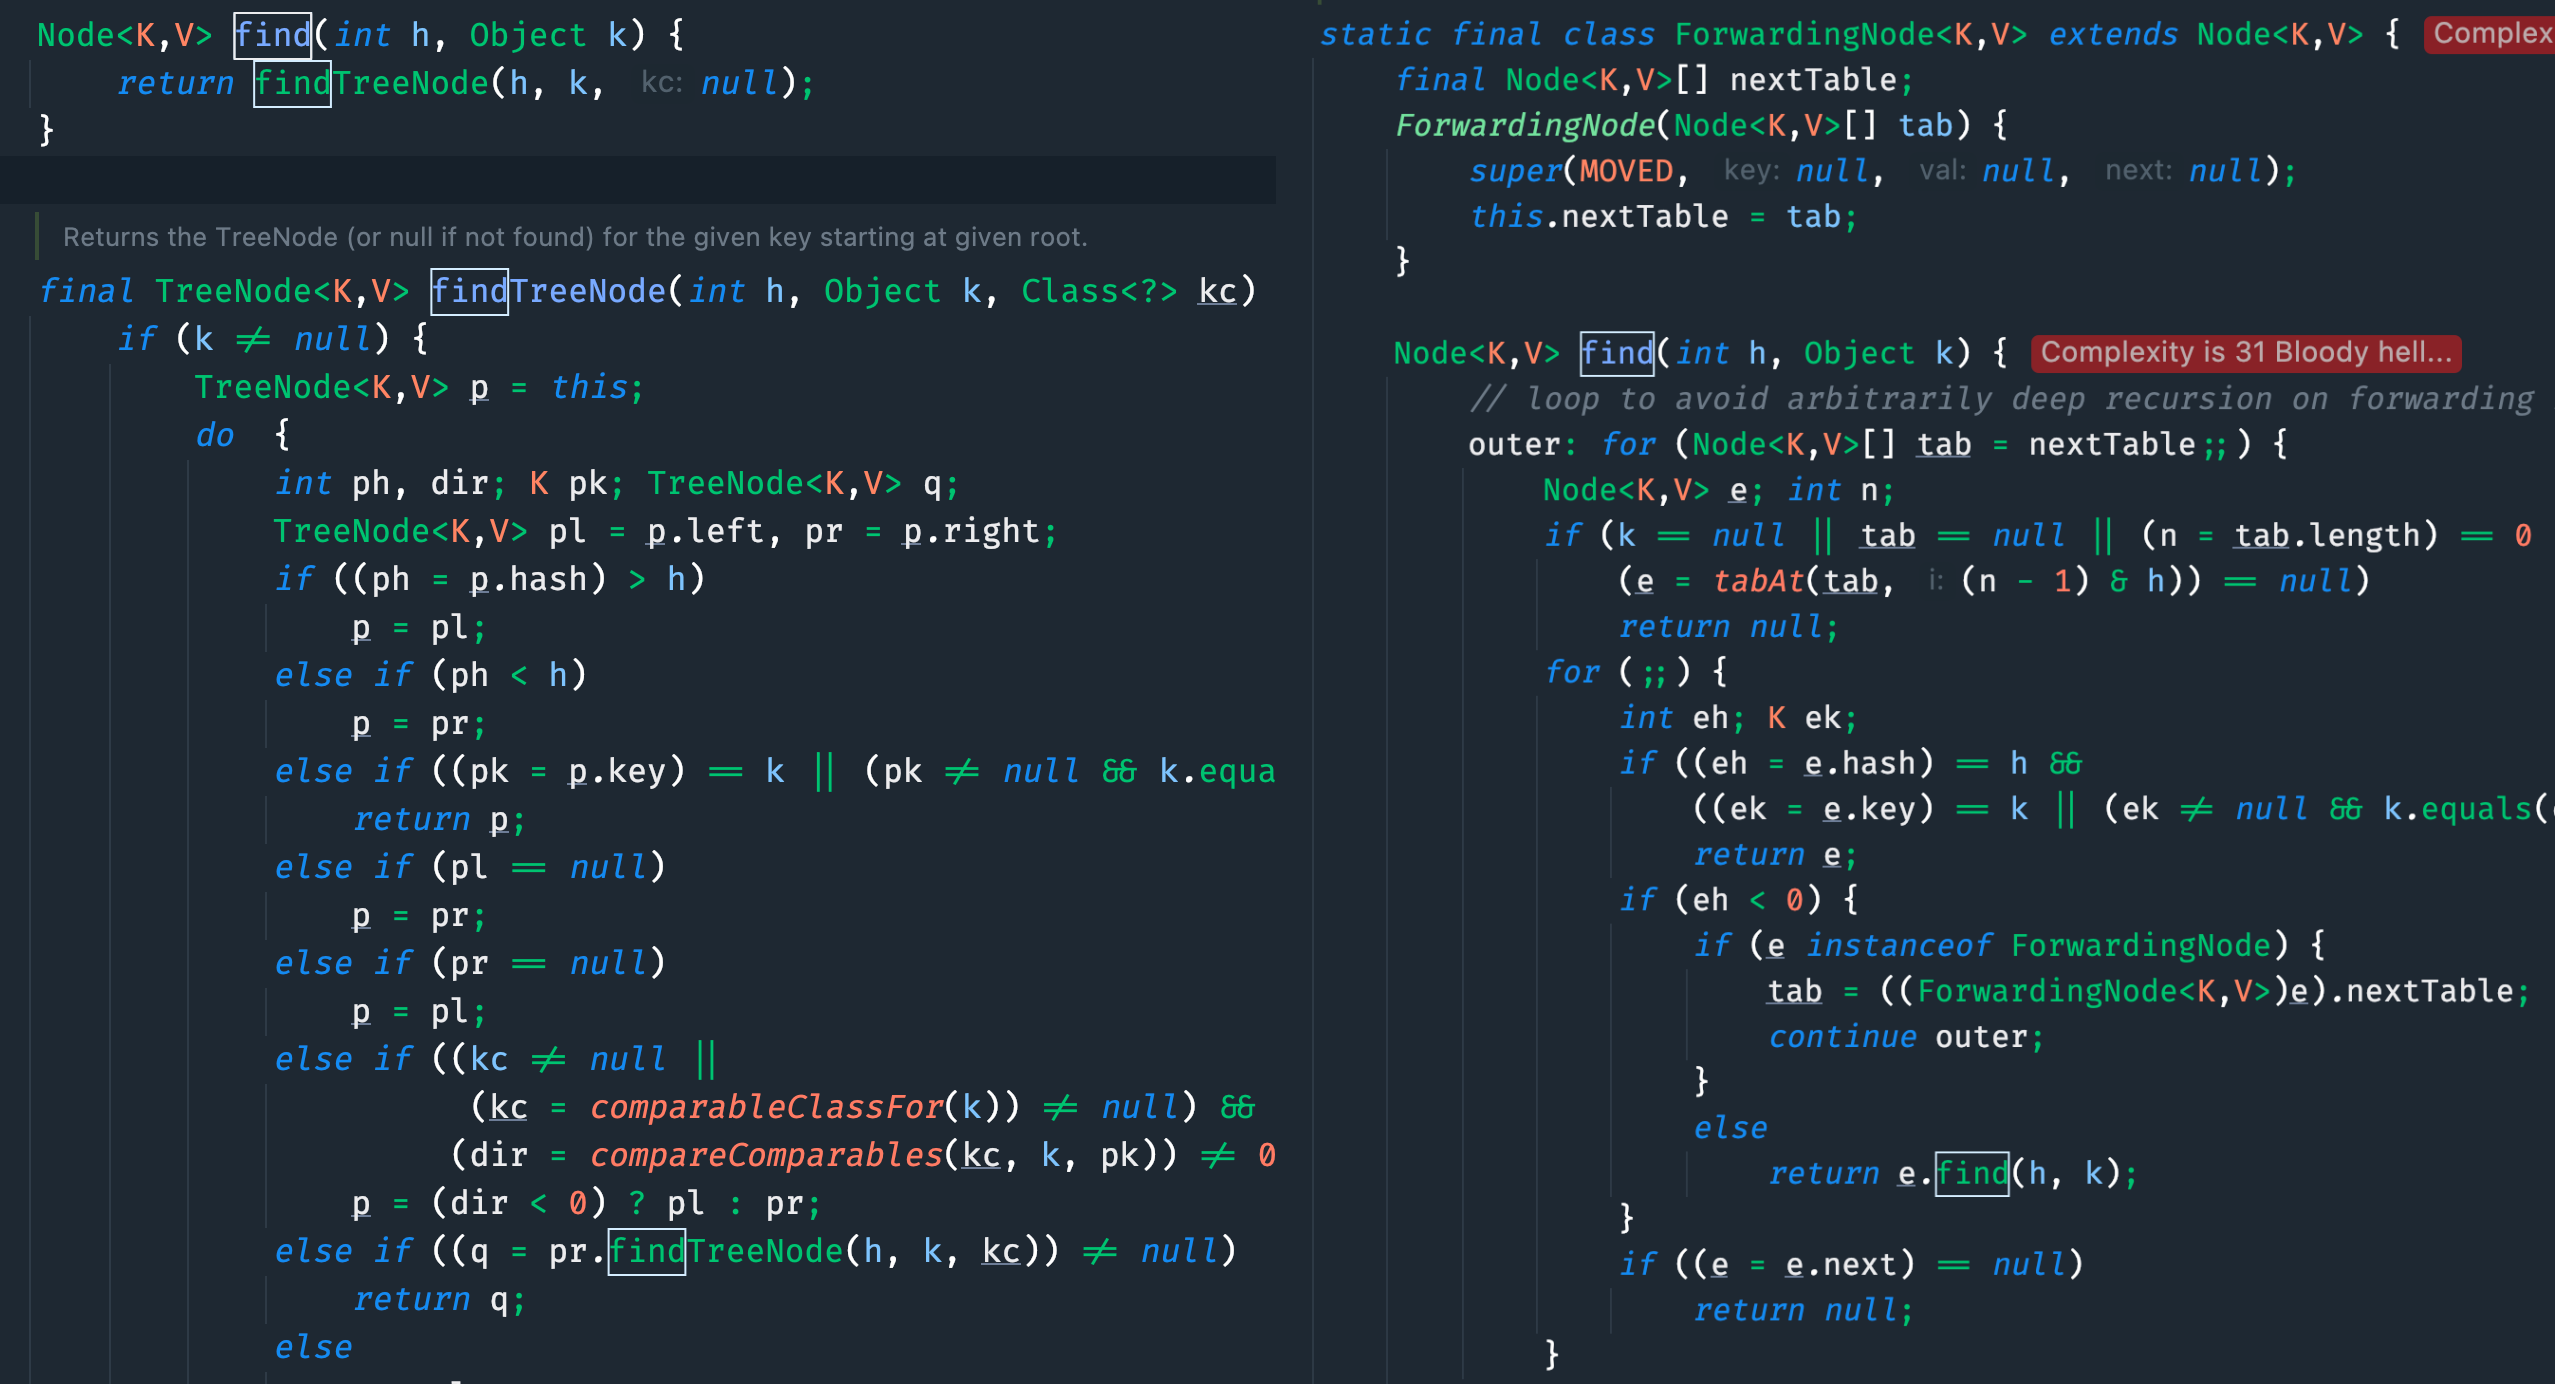
否则遍历链表查找匹配的键。如果都没找到,返回 null。
说一下 HashMap 和 ConcurrentHashMap 的区别?
HashMap 是非线程安全的,多线程环境下应该使用 ConcurrentHashMap。
你项目中怎么使用 ConcurrentHashMap 的?
在技术派实战项目中,很多地方都用到了 ConcurrentHashMap,比如说在异步工具类 AsyncUtil 中,就使用了 ConcurrentHashMap 来存储任务的名称和它们的运行时间,以便观察和分析任务的执行情况。

说一下 ConcurrentHashMap 对 HashMap 的改进?
首先是 hash 的计算方法上,ConcurrentHashMap 的 spread 方法接收一个已经计算好的 hashCode,然后将这个哈希码的高 16 位与自身进行异或运算。
static final int spread(int h) {
    return (h ^ (h >>> 16)) & HASH_BITS;
}比 HashMap 的 hash 计算多了一个 & HASH_BITS 的操作。这里的 HASH_BITS 是一个常数,值为 0x7fffffff,它确保结果是一个非负整数。
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}另外,ConcurrentHashMap 对节点 Node 做了进一步的封装,比如说用 Forwarding Node 来表示正在进行扩容的节点。
static final class ForwardingNode<K,V> extends Node<K,V> {
    final Node<K,V>[] nextTable;
    ForwardingNode(Node<K,V>[] tab) {
        super(MOVED, null, null, null);
        this.nextTable = tab;
    }
}最后就是 put 方法,通过 CAS + synchronized 代码块来进行并发写入。
为什么 ConcurrentHashMap 在 JDK 1.7 中要用 ReentrantLock,而在 JDK 1.8 要用 synchronized
JDK 1.7 中的 ConcurrentHashMap 使用了分段锁机制,每个 Segment 都继承了 ReentrantLock,这样可以保证每个 Segment 都可以独立地加锁。
而在 JDK 1.8 中,ConcurrentHashMap 取消了 Segment 分段锁,采用了更加精细化的锁——桶锁,以及 CAS 无锁算法,每个桶都可以独立地加锁,只有在 CAS 失败时才会使用 synchronized 代码块加锁,这样可以减少锁的竞争,提高并发性能。
memo:2025 年 2 月 20 日修改至此,今天要修改大量简历,所以面渣逆袭的进度只能耽误一下了。
49.ConcurrentHashMap 怎么保证可见性?(补充)
2024 年 03 月 25 日增补
ConcurrentHashMap 中的 Node 节点中,value 和 next 都是 volatile 的,这样就可以保证对 value 或 next 的更新会被其他线程立即看到。
static class Node<K,V> implements Map.Entry<K,V> {
    final int hash;
    final K key;
    volatile V value;
    volatile Node<K,V> next;
}50.为什么 ConcurrentHashMap 比 Hashtable 效率高(补充)
2024 年 03 月 26 日增补,从集合框架移动到并发编程这里
Hashtable 在任何时刻只允许一个线程访问整个 Map,是通过对整个 Map 加锁来实现线程安全的。比如 get 和 put 方法,是直接在方法上加的 synchronized 关键字。
public synchronized V put(K key, V value) {
    if (value == null) throw new NullPointerException();
    int hash = key.hashCode();
    int index = (hash & 0x7FFFFFFF) % table.length;
    ...
    return oldValue;
}而 ConcurrentHashMap 在 JDK 8 中是采用 CAS + synchronized 实现的,仅在必要时加锁。
比如说 put 的时候优先使用 CAS 尝试插入,如果失败再使用 synchronized 代码块加锁。
get 的时候是完全无锁的,因为 value 是 volatile 变量 修饰的,保证了内存可见性。
public V get(Object key) {
    int hash = spread(key.hashCode());
    Node<K,V>[] tab = table;
    int index = (tab.length - 1) & hash;
    Node<K,V> e = tabAt(tab, index);

    if (e != null) {
        do {
            if (e.hash == hash && (e.key == key || (key != null && key.equals(e.key)))) {
                return e.value;  // 读取 volatile 变量,保证可见性
            }
        } while ((e = e.next) != null);
    }
    return null;
}51.能说一下 CopyOnWriteArrayList 的实现原理吗?(补充)
2024 年 04 月 23 日增补,推荐阅读:吊打 Java 并发面试官之 CopyOnWriteArrayList
CopyOnWriteArrayList 是 ArrayList 的线程安全版本,适用于读多写少的场景。它的核心思想是写操作时创建一个新数组,修改后再替换原数组,这样就能够确保读操作无锁,从而提高并发性能。
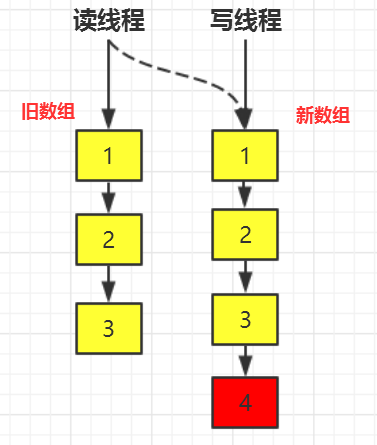
内部使用 volatile 变量来修饰数组 array,以读操作的内存可见性。
private transient volatile Object[] array;写操作的时候使用 ReentrantLock 来保证线程安全。
public boolean add(E e) {
    final ReentrantLock lock = this.lock;
    // 加锁
    lock.lock();
    try {
        Object[] elements = getArray();
        int len = elements.length;
        // 创建一个新数组
        Object[] newElements = Arrays.copyOf(elements, len + 1);
        newElements[len] = e;
        // 替换原数组
        setArray(newElements);
        return true;
    } finally {
        // 释放锁
        lock.unlock();
    }
}缺点就是写操作的时候会复制一个新数组,如果数组很大,写操作的性能会受到影响。
52. 能说一下 BlockingQueue 吗?(补充)
2024 年 08 月 18 日增补,从集合框架移动到并发编程这里
BlockingQueue 是 JUC 包下的一个线程安全队列,支持阻塞式的“生产者-消费者”模型。
当队列容器已满,生产者线程会被阻塞,直到消费者线程取走元素后为止;当队列容器为空时,消费者线程会被阻塞,直至队列非空时为止。
BlockingQueue 的实现类有很多,比如说 ArrayBlockingQueue、PriorityBlockingQueue 等。
| 实现类 | 数据结构 | 是否有界 | 特点 |
|---|---|---|---|
| ArrayBlockingQueue | 数组 | ✅ 有界 | 基于数组,固定容量,FIFO |
| LinkedBlockingQueue | 链表 | ✅ 可有界(默认 Integer.MAX_VALUE) | 基于链表,吞吐量比 ArrayBlockingQueue 高 |
| PriorityBlockingQueue | 堆(优先队列) | ❌ 无界 | 元素按优先级排序(非 FIFO) |
| DelayQueue | 优先队列(基于 Delayed 接口) | ❌ 无界 | 元素到期后才能被取出 |
| SynchronousQueue | 无缓冲 | ✅ 容量为 0 | 必须一对一交换数据,适用于高吞吐的任务提交 |
| LinkedTransferQueue | 链表 | ❌ 无界 | 支持 tryTransfer(),数据立即交给消费者 |
阻塞队列是如何实现的?
阻塞队列使用 ReentrantLock + Condition 来确保并发安全。
以 ArrayBlockingQueue 为例,它内部维护了一个数组,使用两个指针分别指向队头和队尾。
put 的时候先用 ReentrantLock 加锁,然后判断队列是否已满,如果已满就阻塞等待,否则插入元素。
final ReentrantLock lock;
private final Condition notEmpty;
private final Condition notFull;

public void put(E e) throws InterruptedException {
    final ReentrantLock lock = this.lock;
    lock.lockInterruptibly(); // 🔹 加锁,确保线程安全
    try {
        while (count == items.length) { // 🔹 队列满,阻塞
            notFull.await();
        }
        enqueue(e); // 🔹 插入元素
    } finally {
        lock.unlock(); // 🔹 释放锁
    }
}memo:2025 年 02 月 21 日修改至此。今天的主要工作仍然是修改简历,最近刚好赶上暑期实习的高峰期。
线程池
🌟53.什么是线程池?
线程池是用来管理和复用线程的工具,它可以减少线程的创建和销毁开销。
在 Java 中,ThreadPoolExecutor 是线程池的核心实现,它通过核心线程数、最大线程数、任务队列和拒绝策略来控制线程的创建和执行。
举个例子:就像你开了一家餐厅,线程池就相当于固定数量的服务员,顾客(任务)来了就安排空闲的服务员(线程)处理,避免了频繁招人和解雇的成本。
54.你在项目中有用到线程池吗?
推荐阅读:线程池在美团业务中的应用
有,用到过很多次。
比如说在技术派实战项目当中, 我们就封装了一个异步工具类 AsyncUtil,内置了可配置的线程池,基于 ThreadPoolExecutor,适用于 IO 密集型任务。
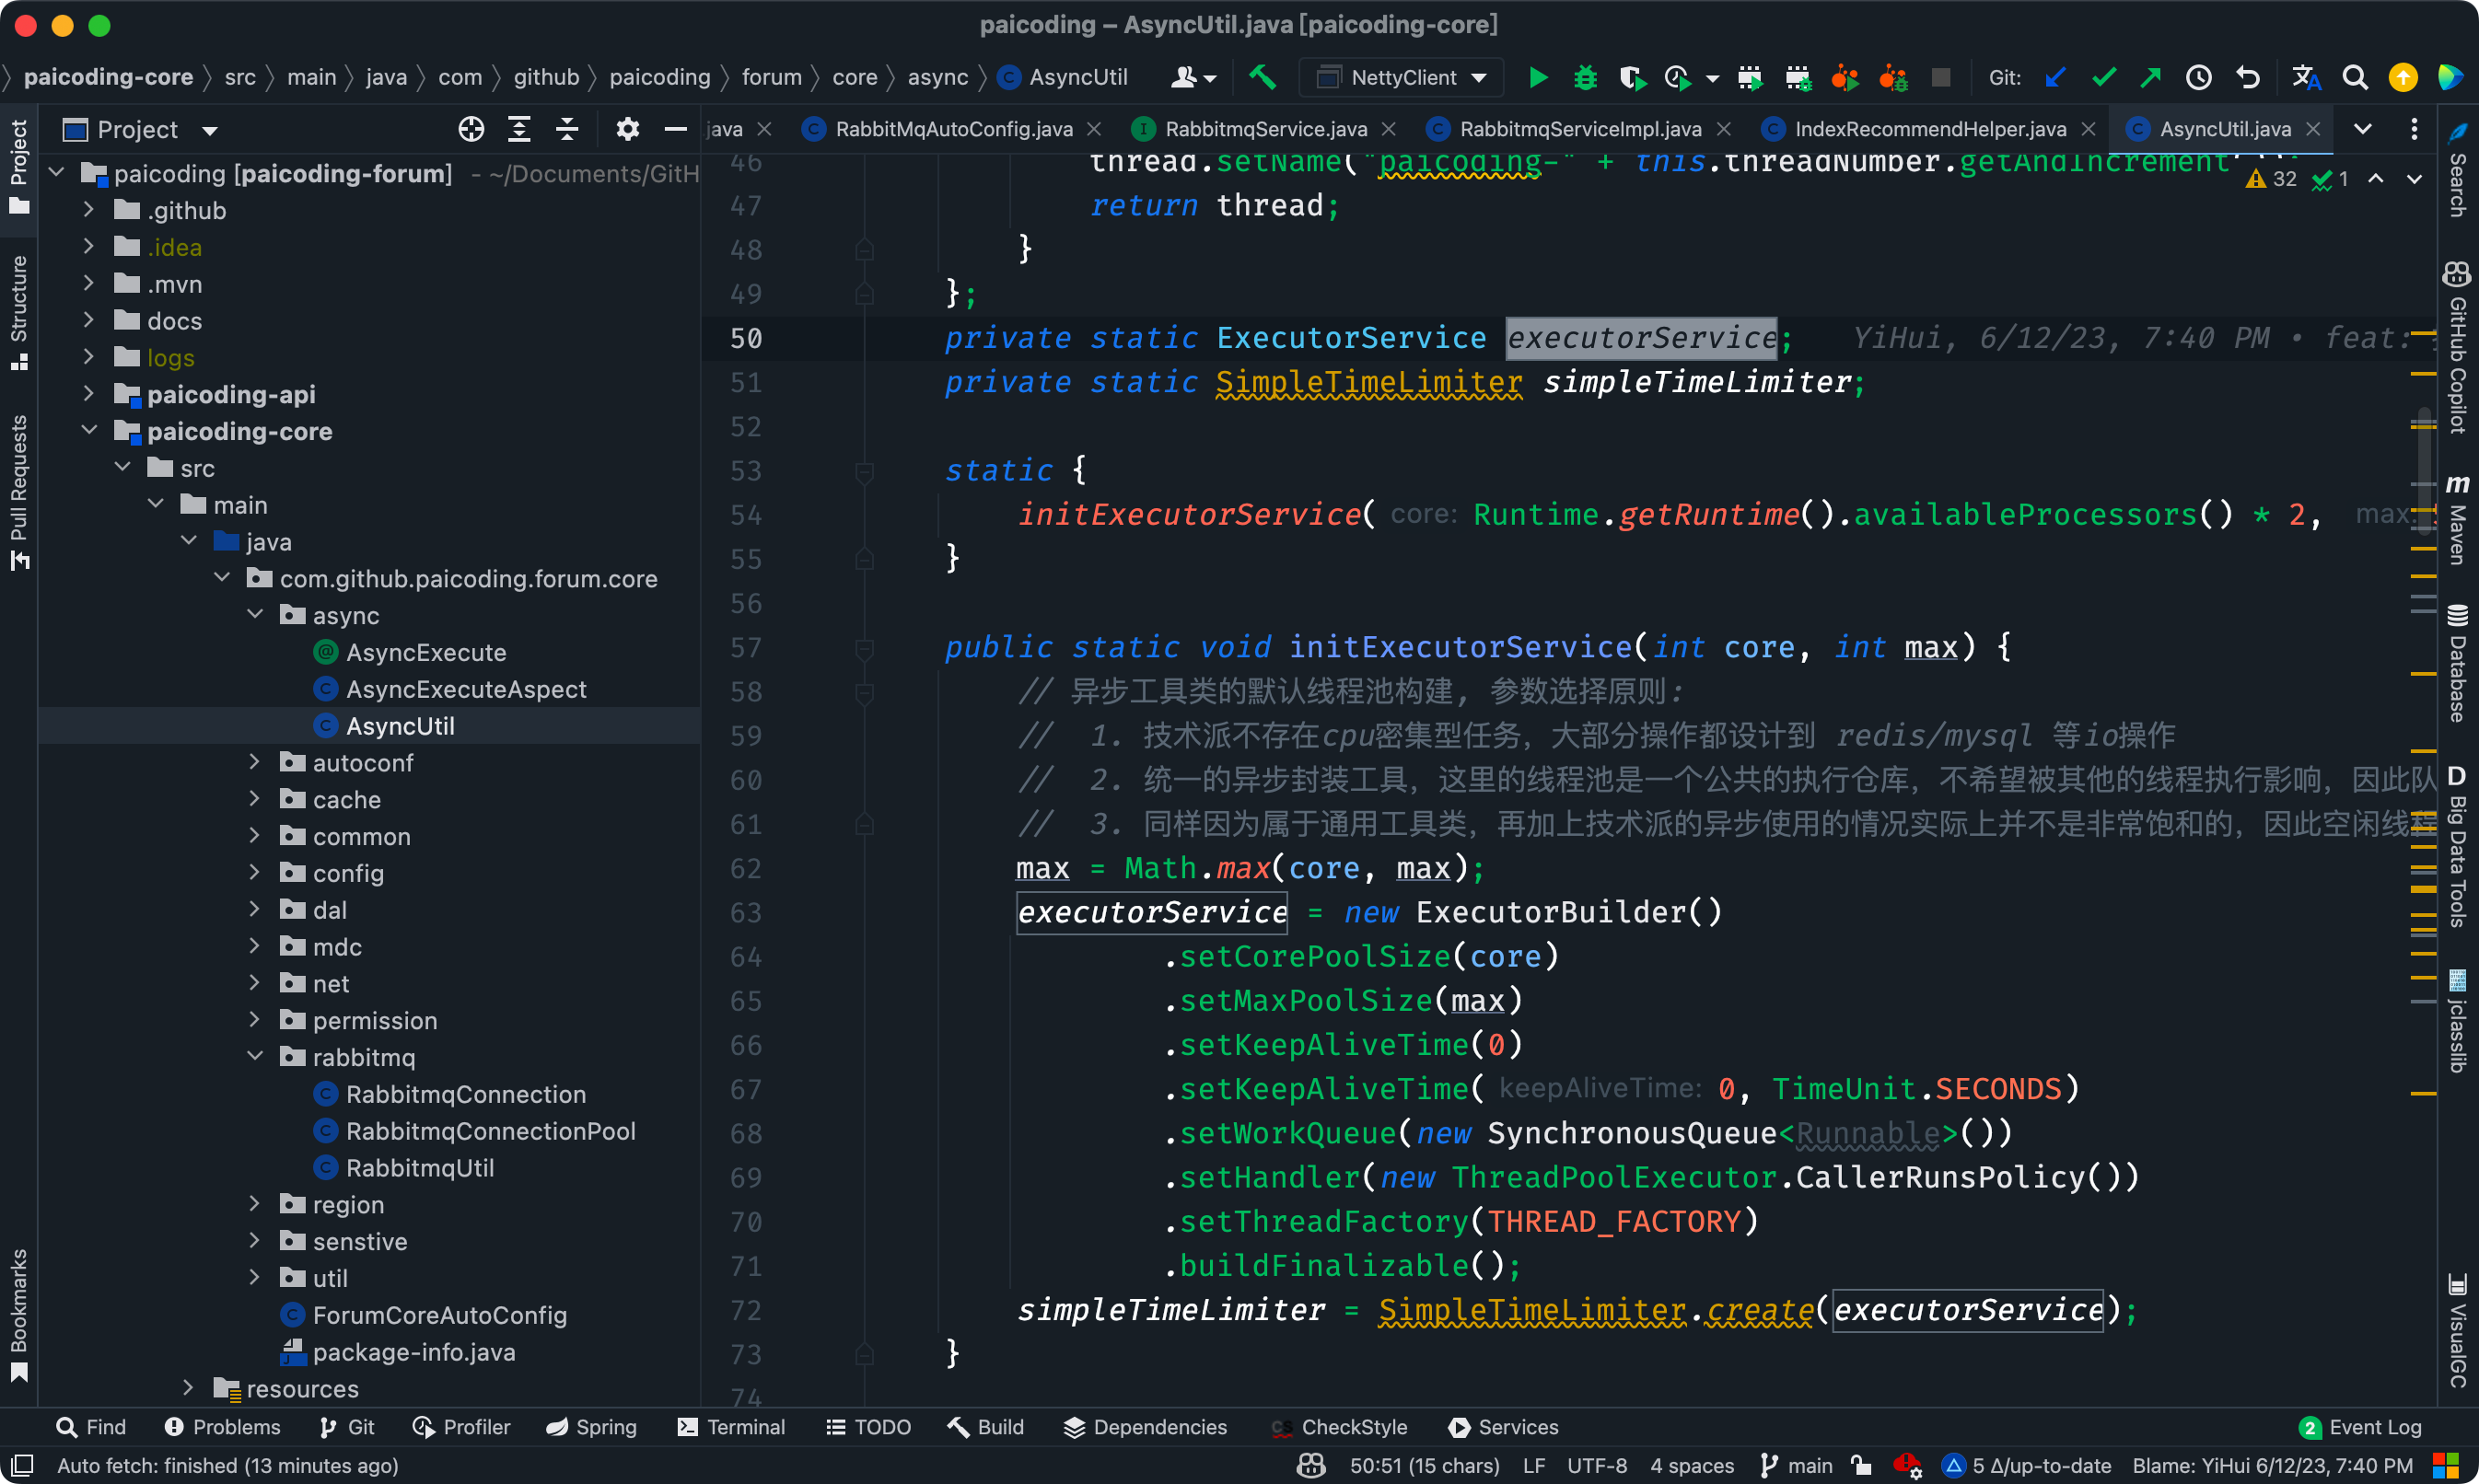
其中 corePoolSize 为 CPU 核心数的两倍,因为技术派中的大多数任务都是 IO 密集型的,maxPoolSize 设置为 50,是一个比较理想的值,尤其是在本地环境中;阻塞队列为 SynchronousQueue,意味着任务被创建后可以直接提交给等待的线程处理。
55.说一下线程池的工作流程?
可以简单总结为:
任务提交 → 核心线程执行 → 任务队列缓存 → 非核心线程执行 → 拒绝策略处理。
第一步,线程池通过 submit() 提交任务。
ExecutorService threadPool = Executors.newFixedThreadPool(5);
threadPool.submit(() -> {
    System.out.println(Thread.currentThread().getName() + "\t" + "办理业务");
});第二步,线程池会先创建核心线程来执行任务。
if (workerCountOf(c) < corePoolSize) {
    if (addWorker(command, true)) {
        return;
    }
}第三步,如果核心线程都在忙,任务会被放入任务队列中。
workQueue.offer(task);第四步,如果任务队列已满,且当前线程数量小于最大线程数,线程池会创建新的线程来处理任务。
if (!addWorker(command, false))第五步,如果线程池中的线程数量已经达到最大线程数,且任务队列已满,线程池会执行拒绝策略。
handler.rejectedExecution(command, this);另外一版回答。
第一步,创建线程池。
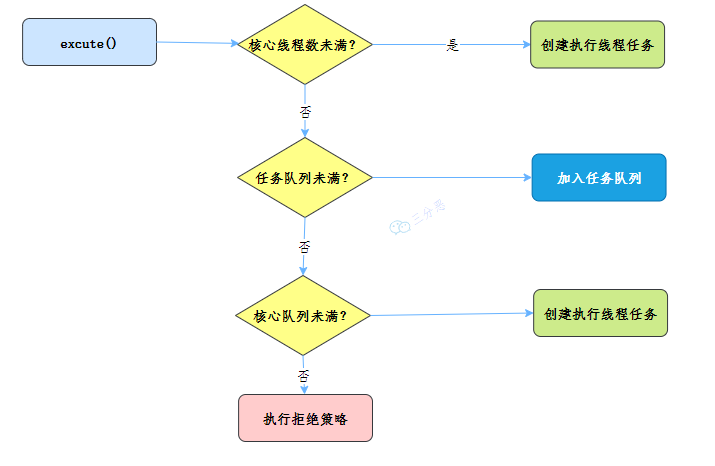
第二步,调用线程池的 execute()方法,准备执行任务。
- 如果正在运行的线程数量小于 corePoolSize,那么线程池会创建一个新的线程来执行这个任务;
- 如果正在运行的线程数量大于或等于 corePoolSize,那么线程池会将这个任务放入等待队列;
- 如果等待队列满了,而且正在运行的线程数量小于 maximumPoolSize,那么线程池会创建新的线程来执行这个任务;
- 如果等待队列满了,而且正在运行的线程数量大于或等于 maximumPoolSize,那么线程池会执行拒绝策略。
第三步,线程执行完毕后,线程并不会立即销毁,而是继续保持在池中等待下一个任务。
第四步,当线程空闲时间超出指定时间,且当前线程数量大于核心线程数时,线程会被回收。
能用一个生活中的例子说明下吗?
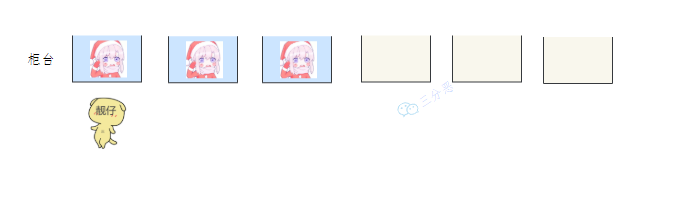
可以。有个名叫“你一定暴富”的银行,该银行有 6 个窗口,现在开放了 3 个窗口,坐着 3 个小姐姐在办理业务。
靓仔小二去办理业务,会遇到什么情况呢?
第一情况,小二发现有个空闲的小姐姐,正在翘首以盼,于是小二就快马加鞭跑过去办理了。
第二种情况,小姐姐们都在忙,接待员小美招呼小二去排队区区取号排队,让小二稍安勿躁。
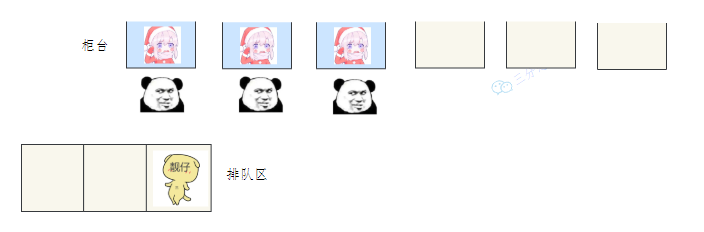
第三种情况,不仅小姐姐们都在忙,排队区也满了,小二着急用钱,于是脾气就上来了,和接待员小美对线了起来,要求开放另外 3 个空闲的窗口。
小美迫于小二的压力,开放了另外 3 个窗口,排队区的人立马就冲了过去。
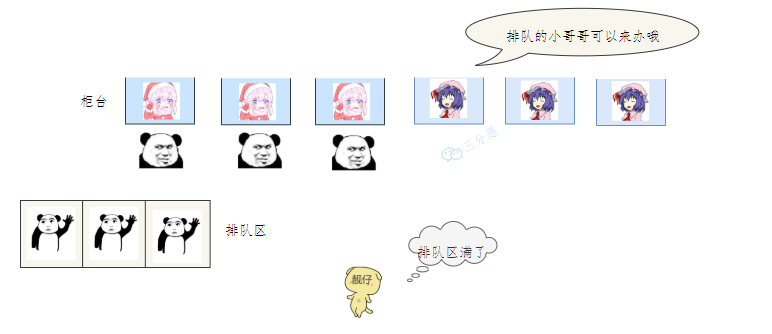
第四种情况,6 个窗口的小姐姐都在忙,排队区也满了。。。
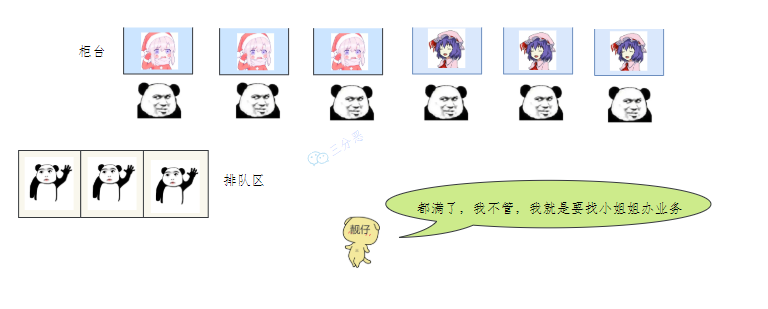
接待员小美给了小二 4 个选项:
- 对不起,我们暴富银行系统瘫痪了。
- 没看忙着呢,谁叫你来办的你找谁去!
- 靓仔,看你比较急,去队里偷偷加个塞。
- 不好意思,今天没办法,你改天再来吧。
这个流程和线程池不能说一模一样,简直就是一模一样:
- corePoolSize 对应营业窗口数 3
- maximumPoolSize 对应最大窗口数 6
- workQueue 对应排队区
- handler 对应接待员小美
class ThreadPoolDemo {
    public static void main(String[] args) {
        // 创建一个线程池
        ExecutorService threadPool = new ThreadPoolExecutor(
                3, // 核心线程数
                6, // 最大线程数
                0, // 线程空闲时间
                TimeUnit.SECONDS, // 时间单位
                new LinkedBlockingQueue<>(10), // 等待队列
                Executors.defaultThreadFactory(), // 线程工厂
                new ThreadPoolExecutor.AbortPolicy() // 拒绝策略
        );
        // 模拟 10 个顾客来银行办理业务
        try {
            for (int i = 1; i <= 10; i++) {
                final int tempInt = i;
                threadPool.execute(() -> {
                    System.out.println(Thread.currentThread().getName() + "\t" + "办理业务" + tempInt);
                });
            }
        } catch (Exception e) {
            e.printStackTrace();
        } finally {
            threadPool.shutdown();
        }
    }
}🌟56.线程池的主要参数有哪些?
线程池有 7 个参数,需要重点关注的有核心线程数、最大线程数、等待队列、拒绝策略。
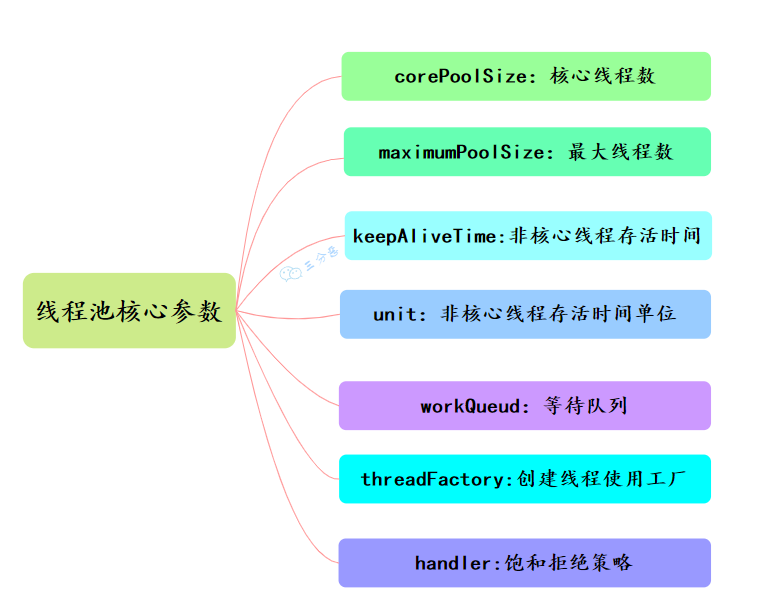
①、corePoolSize:核心线程数,长期存活,执行任务的主力。
②、maximumPoolSize:线程池允许的最大线程数。
③、workQueue:任务队列,存储等待执行的任务。
④、handler:拒绝策略,任务超载时的处理方式。也就是线程数达到 maximumPoolSiz,任务队列也满了的时候,就会触发拒绝策略。
⑤、threadFactory:线程工厂,用于创建线程,可自定义线程名。
⑥、keepAliveTime:非核心线程的存活时间,空闲时间超过该值就销毁。
⑦、unit:keepAliveTime 参数的时间单位:
- TimeUnit.DAYS; 天
- TimeUnit.HOURS; 小时
- TimeUnit.MINUTES; 分钟
- TimeUnit.SECONDS; 秒
- TimeUnit.MILLISECONDS; 毫秒
- TimeUnit.MICROSECONDS; 微秒
- TimeUnit.NANOSECONDS; 纳秒
能简单说一下参数之间的关系吗?
一句话:任务优先使用核心线程执行,满了进入等待队列,队列满了启用非核心线程备用,线程池达到最大线程数量后触发拒绝策略,非核心线程的空闲时间超过存活时间就被回收。
核心线程数不够会怎么进行处理?
当提交的任务数超过了 corePoolSize,但是小于 maximumPoolSize 时,线程池会创建新的线程来处理任务。
当提交的任务数超过了 maximumPoolSize 时,线程池会根据拒绝策略来处理任务。
举个例子说一下这些参数的变化?
假设一个场景,线程池的配置如下:
corePoolSize = 5
maximumPoolSize = 10
keepAliveTime = 60秒
workQueue = LinkedBlockingQueue(容量为100)
handler = ThreadPoolExecutor.AbortPolicy()场景一:当系统启动后,有 10 个任务提交到线程池。
- 前 5 个任务会立即执行,因为核心线程数足够容纳它们。
- 随后的 5 个任务会被放入等待队列。
场景二:如果此时再有 100 个任务提交到线程池。
- 工作队列已满,线程池会创建额外的线程来执行这些任务,直到线程总数达到 10。
- 如果任务继续增加,超过了工作队列+最大线程数的限制,新来的任务会被 AbortPolicy 拒绝,抛出 RejectedExecutionException 异常。
场景三:如果任务突然减少:
核心线程会一直运行,而超出核心线程数的线程,会在 60 秒后回收。
🌟57.线程池的拒绝策略有哪些?
有四种:
- AbortPolicy:默认的拒绝策略,会抛 RejectedExecutionException 异常。
- CallerRunsPolicy:让提交任务的线程自己来执行这个任务,也就是调用 execute 方法的线程。
- DiscardOldestPolicy:等待队列会丢弃队列中最老的一个任务,也就是队列中等待最久的任务,然后尝试重新提交被拒绝的任务。
- DiscardPolicy:丢弃被拒绝的任务,不做任何处理也不抛出异常。
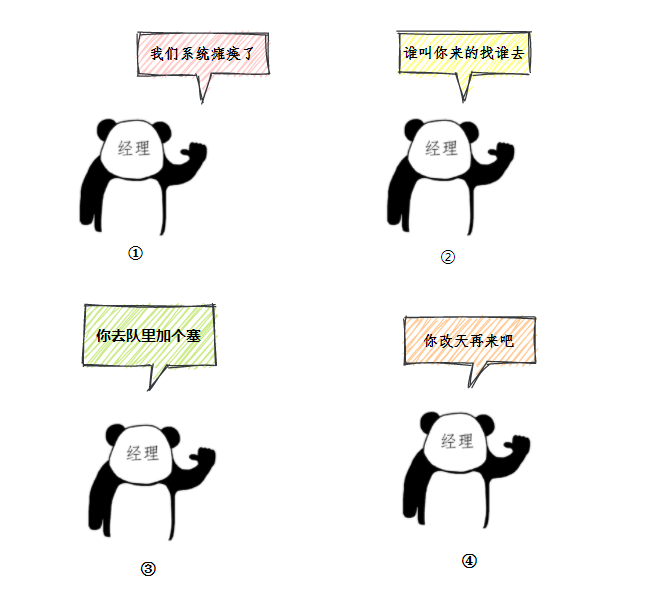
分别对应着小二去银行办理业务被经理“薄纱”的四个场景:“我们系统瘫痪了”、“谁叫你来办的你找谁去”、“看你比较急,去队里加个塞”、“今天没办法,不行你看改一天”。
当线程池无法接受新的任务时,也就是线程数达到 maximumPoolSize,任务队列也满了的时候,就会触发拒绝策略。
如果默认策略不能满足需求,可以通过实现 RejectedExecutionHandler 接口来定义自己的淘汰策略。例如:记录被拒绝任务的日志。
class CustomRejectedHandler {
    public static void main(String[] args) {
        // 自定义拒绝策略
        RejectedExecutionHandler rejectedHandler = (r, executor) -> {
            System.out.println("Task " + r.toString() + " rejected. Queue size: "
                               + executor.getQueue().size());
        };

        // 自定义线程池
        ThreadPoolExecutor executor = new ThreadPoolExecutor(
            2,                      // 核心线程数
            4,                      // 最大线程数
            10,                     // 空闲线程存活时间
            TimeUnit.SECONDS,
            new ArrayBlockingQueue<>(2),  // 阻塞队列容量
            Executors.defaultThreadFactory(),
            rejectedHandler          // 自定义拒绝策略
        );

        for (int i = 0; i < 10; i++) {
            final int taskNumber = i;
            executor.execute(() -> {
                System.out.println("Executing task " + taskNumber);
                try {
                    Thread.sleep(1000); // 模拟任务耗时
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            });
        }

        executor.shutdown();
    }
}58.线程池有哪几种阻塞队列?
常用的有五种,有界队列 ArrayBlockingQueue;无界队列 LinkedBlockingQueue;优先级队列 PriorityBlockingQueue;延迟队列 DelayQueue;同步队列 SynchronousQueue。

①、ArrayBlockingQueue:一个有界的先进先出的阻塞队列,底层是一个数组,适合固定大小的线程池。
ArrayBlockingQueue<Integer> blockingQueue = new ArrayBlockingQueue<Integer>(10, true);②、LinkedBlockingQueue:底层是链表,如果不指定大小,默认大小是 Integer.MAX_VALUE,几乎相当于一个无界队列。
技术派实战项目中,就使用了 LinkedBlockingQueue 来配置 RabbitMQ 的消息队列。
③、PriorityBlockingQueue:一个支持优先级排序的无界阻塞队列。任务按照其自然顺序或 Comparator 来排序。
适用于需要按照给定优先级处理任务的场景,比如优先处理紧急任务。
④、DelayQueue:类似于 PriorityBlockingQueue,由二叉堆实现的无界优先级阻塞队列。
Executors 中的 newScheduledThreadPool() 就使用了 DelayQueue 来实现延迟执行。
public ScheduledThreadPoolExecutor(int corePoolSize) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
            new DelayedWorkQueue());
}⑤、SynchronousQueue:每个插入操作必须等待另一个线程的移除操作,同样,任何一个移除操作都必须等待另一个线程的插入操作。
Executors.newCachedThreadPool() 就使用了 SynchronousQueue,这个线程池会根据需要创建新线程,如果有空闲线程则会重复使用,线程空闲 60 秒后会被回收。
public static ExecutorService newCachedThreadPool() {
    return new ThreadPoolExecutor(0, Integer.MAX_VALUE,
                                    60L, TimeUnit.SECONDS,
                                    new SynchronousQueue<Runnable>());
}memo:2025 年 2 月 22 日修改至此。
59.线程池提交 execute 和 submit 有什么区别?
execute 方法没有返回值,适用于不关心结果和异常的简单任务。
threadsPool.execute(new Runnable() {
    @Override public void run() {
        System.out.println("execute() 方法提交的任务");
    }
});submit 有返回值,适用于需要获取结果或处理异常的场景。
Future<Object> future = executor.submit(harReturnValuetask);
try { Object s = future.get(); }
catch (InterruptedException e | ExecutionException e) {
    // 处理无法执行任务异常
} finally {
    // 关闭线程池 executor.shutdown();
}60.线程池怎么关闭知道吗?
可以调用线程池的shutdown或shutdownNow方法来关闭线程池。
shutdown 不会立即停止线程池,而是等待所有任务执行完毕后再关闭线程池。
ExecutorService executor = Executors.newFixedThreadPool(3);
executor.execute(() -> System.out.println("Task 1"));
executor.execute(() -> System.out.println("Task 2"));

executor.shutdown(); // 不会立刻关闭,而是等待所有任务执行完毕shutdownNow 会尝试通过一系列动作来停止线程池,包括停止接收外部提交的任务、忽略队列里等待的任务、尝试将正在跑的任务 interrupt 中断。
ExecutorService executor = Executors.newFixedThreadPool(3);
executor.execute(() -> {
    try {
        Thread.sleep(5000); // 模拟长时间运行任务
        System.out.println("Task executed");
    } catch (InterruptedException e) {
        System.out.println("任务被中断");
    }
});

List<Runnable> unexecutedTasks = executor.shutdownNow(); // 立即关闭线程池
System.out.println("未执行的任务数: " + unexecutedTasks.size());需要注意的是,shutdownNow 不会真正终止正在运行的任务,只是给任务线程发送 interrupt 信号,任务是否能真正终止取决于线程是否响应 InterruptedException。
61.线程池的线程数应该怎么配置?
首先,我会分析线程池中执行的任务类型是 CPU 密集型还是 IO 密集型?
①、对于 CPU 密集型任务,我的目标是尽量减少线程上下文切换,以优化 CPU 使用率。一般来说,核心线程数设置为处理器的核心数或核心数加一是较理想的选择。
+1 是为了以备不时之需,如果某线程因等待系统资源而阻塞时,可以有多余的线程顶上去,不至于影响整体性能。
②、对于 IO 密集型任务,由于线程经常处于等待状态,等待 IO 操作完成,所以可以设置更多的线程来提高并发,比如说 CPU 核心数的两倍。
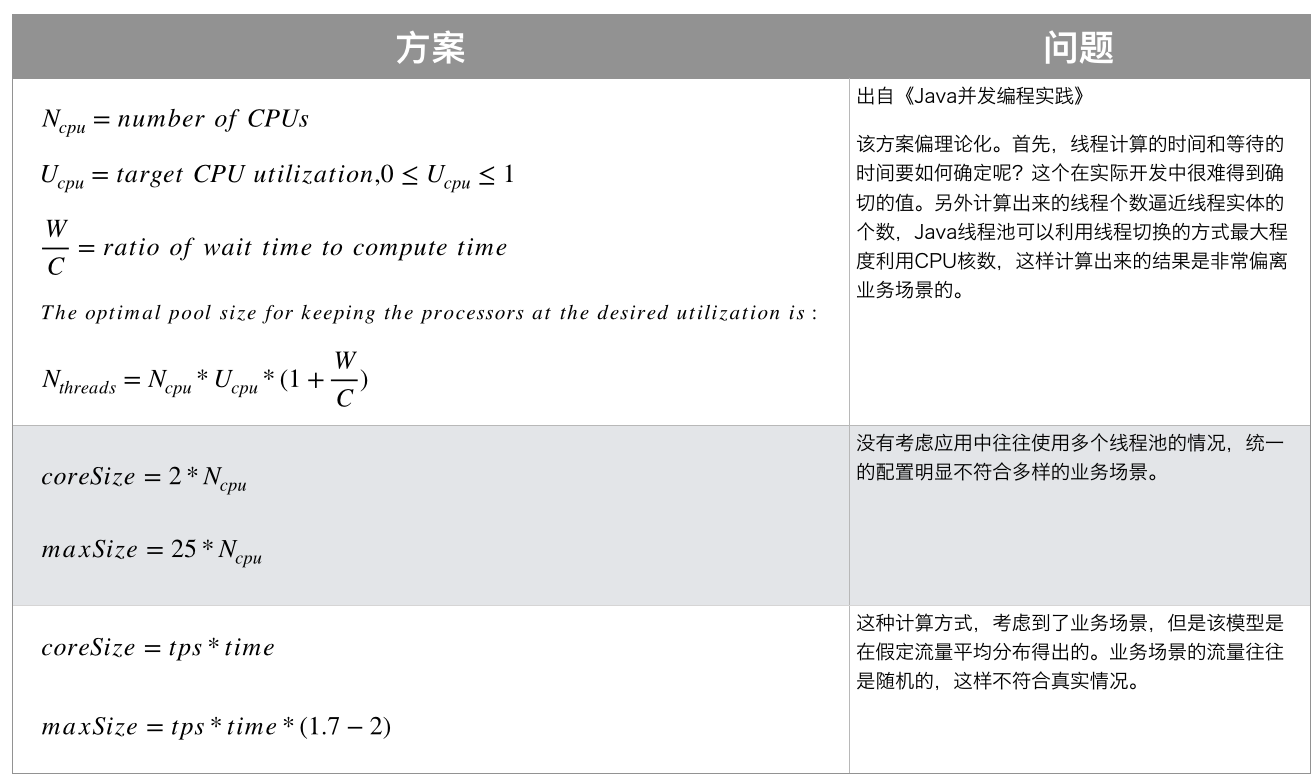
核心数可以通过 Java 的
Runtime.getRuntime().availableProcessors()方法获取。
最后,我会根据业务需求和系统资源来调整线程池的其他参数,比如最大线程数、任务队列容量、非核心线程的空闲存活时间等。
ThreadPoolExecutor executor = new ThreadPoolExecutor(
    cores, // 核心线程数设置为CPU核心数
    cores * 2, // 最大线程数为核心数的两倍
    60L, TimeUnit.SECONDS, // 非核心线程的空闲存活时间
    new LinkedBlockingQueue<>(100) // 任务队列容量
);如何知道你设置的线程数多了还是少了?
可以通过监控和调试来判断线程数是多还是少。
比如说通过 top 命令观察 CPU 的使用率,如果 CPU 使用率较低,可能是线程数过少;如果 CPU 使用率接近 100%,但吞吐量未提升,可能是线程数过多。
然后再通过 VisualVM 或 Arthas 分析线程运行情况,查看线程的状态、等待时间、运行时间等信息。
也可以使用 jstack 命令查看线程堆栈信息,查看线程是否处于阻塞状态。
jstack <Java 进程 ID> | grep -A 20 "BLOCKED" // 查看阻塞线程如果有大量的 BLOCKED 线程,说明线程数可能过多,竞争比较激烈。
62.有哪几种常见的线程池?
主要有四种:
固定大小的线程池 Executors.newFixedThreadPool(int nThreads);,适合用于任务数量确定,且对线程数有明确要求的场景。例如,IO 密集型任务、数据库连接池等。
缓存线程池 Executors.newCachedThreadPool();,适用于短时间内任务量波动较大的场景。例如,短时间内有大量的文件处理任务或网络请求。
定时任务线程池 Executors.newScheduledThreadPool(int corePoolSize);,适用于需要定时执行任务的场景。例如,定时发送邮件、定时备份数据等。
单线程线程池 Executors.newSingleThreadExecutor();,适用于需要按顺序执行任务的场景。例如,日志记录、文件处理等。
memo:2025 年 2 月 23 日修改至此。
63.能说一下四种常见线程池的原理吗?
不管是 FixedThreadPool、CachedThreadPool,还是 SingleThreadExecutor 和 ScheduledThreadPoolExecutor,它们本质上都是 ThreadPoolExecutor 的不同配置。
说说固定大小线程池的原理?
线程池大小是固定的,corePoolSize == maximumPoolSize,默认使用 LinkedBlockingQueue 作为阻塞队列,适用于任务量稳定的场景,如数据库连接池、RPC 处理等。
new ThreadPoolExecutor(4, 4, 0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<>());新任务提交时,如果线程池有空闲线程,直接执行;如果没有,任务进入 LinkedBlockingQueue 等待。缺点是任务队列默认无界,可能导致任务堆积,甚至 OOM。

说说缓存线程池的原理?
线程池大小不固定,corePoolSize = 0,maximumPoolSize = Integer.MAX_VALUE。空闲线程超过 60 秒会被销毁,使用 SynchronousQueue 作为阻塞队列,适用于短时间内有大量任务的场景。
new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS,
new SynchronousQueue<>());提交任务时,如果线程池没有空闲线程,直接新建线程执行任务;如果有,复用线程执行任务。线程空闲 60 秒后销毁,减少资源占用。缺点是线程数没有上限,在高并发情况下可能导致 OOM。
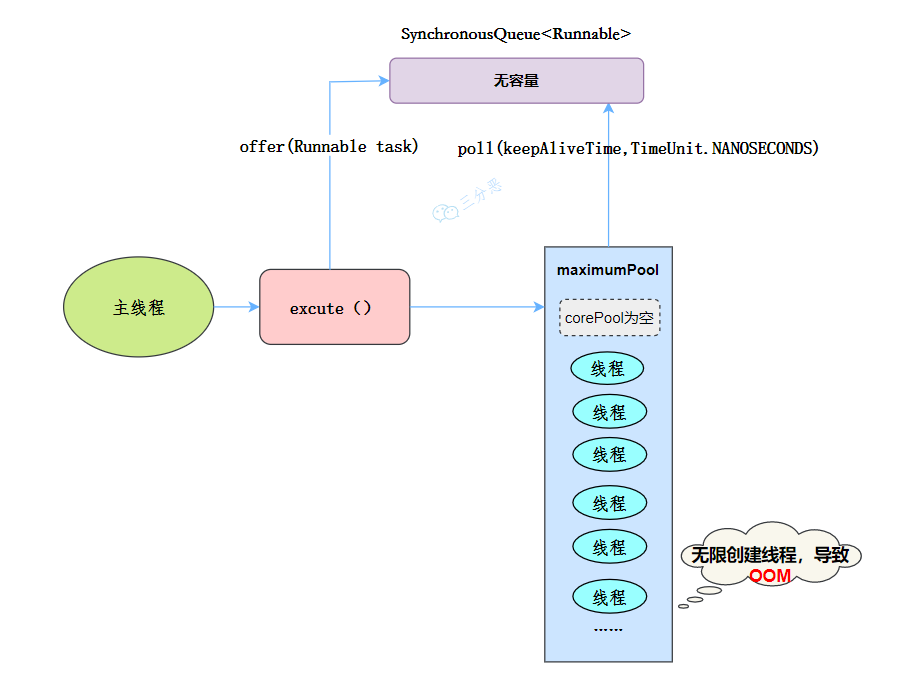
说说单线程线程池的原理?
线程池只有 1 个线程,保证任务按提交顺序执行,使用 LinkedBlockingQueue 作为阻塞队列,适用于需要按顺序执行任务的场景。
new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS,
new LinkedBlockingQueue<>());始终只创建 1 个线程,新任务必须等待前一个任务完成后才能执行,其他任务都被放入 LinkedBlockingQueue 排队执行。缺点是无法并行处理任务。
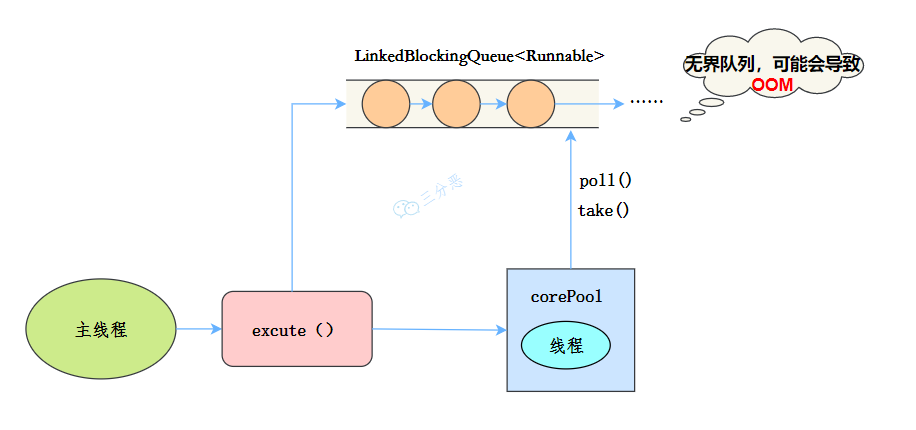
说说定时任务线程池的原理?
定时任务线程池的大小可配置,支持定时 & 周期性任务执行,使用 DelayedWorkQueue 作为阻塞队列,适用于周期性执行任务的场景。
public ScheduledThreadPoolExecutor(int corePoolSize) {
    super(corePoolSize, Integer.MAX_VALUE, 0, NANOSECONDS,
          new DelayedWorkQueue());
}执行定时任务时,schedule() 方法可以将任务延迟一定时间后执行一次;scheduleAtFixedRate() 方法可以将任务延迟一定时间后以固定频率执行;scheduleWithFixedDelay() 方法可以将任务延迟一定时间后以固定延迟执行。

缺点是,如果任务执行时间 > 设定时间间隔,scheduleAtFixedRate 可能会导致任务堆积。
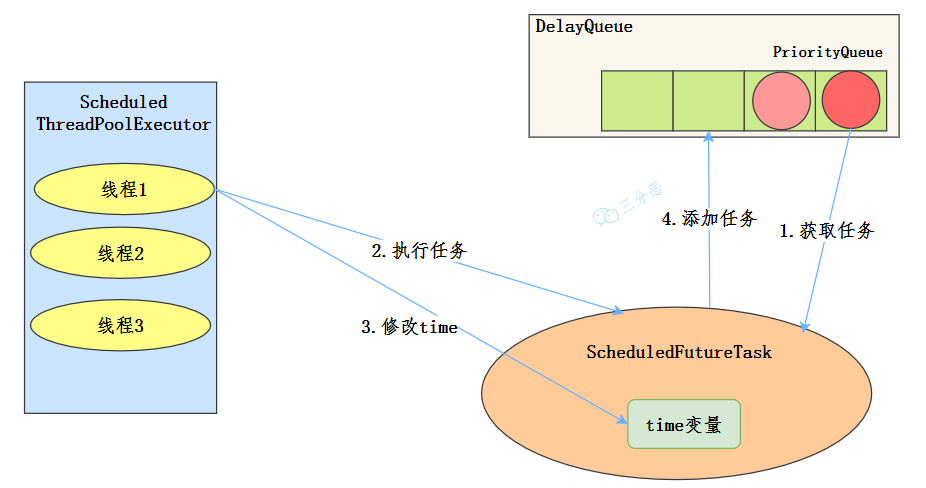
使用无界队列的线程池会出现什么问题?
如果线程获取一个任务后,任务的执行时间比较长,会导致队列的任务越积越多,导致内存使用不断飙升,最终出现 OOM。
64.线程池异常怎么处理知道吗?
常见的处理方式有,使用 try-catch 捕获、使用 Future 获取异常、自定义 ThreadPoolExecutor 重写 afterExecute 方法、使用 UncaughtExceptionHandler 捕获异常。

①、try-catch 是最简单的方法。
executor.execute(() -> {
    try {
        System.out.println("任务开始");
        int result = 1 / 0; // 除零异常
    } catch (Exception e) {
        System.err.println("捕获异常:" + e.getMessage());
    }
});②、使用 Future 获取异常。
Future<Object> future = executor.submit(() -> {
    System.out.println("任务开始");
    int result = 1 / 0; // 除零异常
    return result;
});

try {
    future.get();
} catch (InterruptedException | ExecutionException e) {
    System.err.println("捕获异常:" + e.getMessage());
}③、自定义 ThreadPoolExecutor 重写 afterExecute 方法。
ThreadPoolExecutor executor = new ThreadPoolExecutor(2, 2, 0L, TimeUnit.MILLISECONDS,
    new LinkedBlockingQueue<Runnable>()) {
    @Override
    protected void afterExecute(Runnable r, Throwable t) {
        super.afterExecute(r, t);
        if (t != null) {
            System.err.println("捕获异常:" + t.getMessage());
        }
    }
};

executor.execute(() -> {
    System.out.println("任务开始");
    int result = 1 / 0; // 除零异常
});④、使用 UncaughtExceptionHandler 捕获异常。
ThreadPoolExecutor executor = new ThreadPoolExecutor(2, 2, 0L, TimeUnit.MILLISECONDS,
    new LinkedBlockingQueue<Runnable>());
executor.setRejectedExecutionHandler(new ThreadPoolExecutor.AbortPolicy());
executor.setThreadFactory(new ThreadFactory() {
    @Override
    public Thread newThread(Runnable r) {
        Thread thread = new Thread(r);
        thread.setUncaughtExceptionHandler(new Thread.UncaughtExceptionHandler() {
            @Override
            public void uncaughtException(Thread t, Throwable e) {
                System.err.println("捕获异常:" + e.getMessage());
            }
        });
        return thread;
    }
});

executor.execute(() -> {
    System.out.println("任务开始");
    int result = 1 / 0; // 除零异常
});如果项目使用 execute(),不关心任务返回值,建议使用 UncaughtExceptionHandler:
thread.setUncaughtExceptionHandler((t, e) ->
System.err.println("线程 " + t.getName() + " 捕获到异常:" + e.getMessage()));如果项目使用 submit(),关心任务返回值,建议使用 Future:
Future<?> future = executor.submit(task);
try {
    future.get();
} catch (ExecutionException e) {
    System.err.println("捕获异常:" + e.getCause());
}如果想要全局捕获所有任务异常,建议重写 afterExecute 方法:
class MyThreadPoolExecutor extends ThreadPoolExecutor {
    @Override
    protected void afterExecute(Runnable r, Throwable t) {
        if (t == null && r instanceof Future<?>) {
            try { ((Future<?>) r).get(); } catch (Exception e) { System.err.println("任务异常:" + e.getCause()); }
        }
    }
}65.能说一下线程池有几种状态吗?
有 5 种状态,它们的转换遵循严格的状态流转规则,不同状态控制着线程池的任务调度和关闭行为。
状态由 RUNNING → SHUTDOWN → STOP → TIDYING → TERMINATED 依次流转。

RUNNING 状态的线程池可以接收新任务,并处理阻塞队列中的任务;SHUTDOWN 状态的线程池不会接收新任务,但会处理阻塞队列中的任务;STOP 状态的线程池不会接收新任务,也不会处理阻塞队列中的任务,并且会尝试中断正在执行的任务;TIDYING 状态表示所有任务已经终止;TERMINATED 状态表示线程池完全关闭,所有线程销毁。
| 状态 | 状态码 | 是否接收新任务 | 是否执行队列中的任务 | 是否中断正在执行的任务 |
|---|---|---|---|---|
| RUNNING | 111 | ✅ 是 | ✅ 是 | ❌ 否 |
| SHUTDOWN | 000 | ❌ 否 | ✅ 是 | ❌ 否 |
| STOP | 001 | ❌ 否 | ❌ 否 | ✅ 是 |
| TIDYING | 010 | ❌ 否 | ❌ 否 | ❌ 否 |
| TERMINATED | 011 | ❌ 否 | ❌ 否 | ❌ 否 |
memo:2025 年 2 月 24 日修改至此。今天是出考研成绩的一天,期待所有参加考研的小伙伴都能取得理想的成绩。
66.线程池如何实现参数的动态修改?
线程池提供的 setter 方法就可以在运行时动态修改参数,比如说 setCorePoolSize 可以用来修改核心线程数、setMaximumPoolSize 可以用来修改最大线程数。
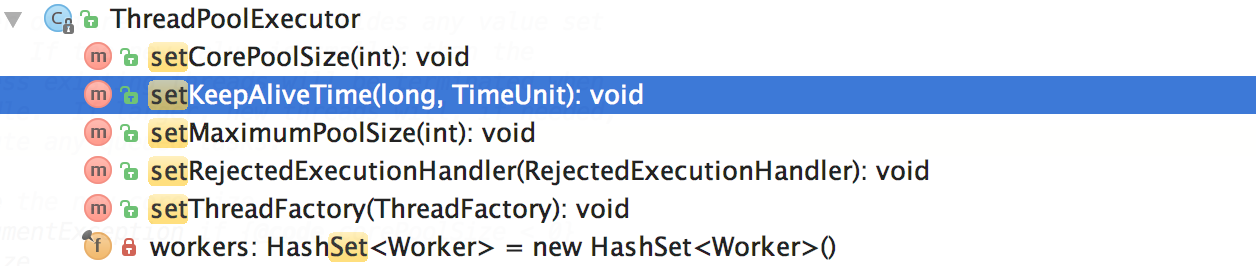
需要注意的是,调用 setCorePoolSize() 时如果新的核心线程数比原来的大,线程池会创建新的线程;如果更小,线程池不会立即销毁多余的线程,除非有空闲线程超过 keepAliveTime。
当然了,还可以利用 Nacos 配置中心,或者实现自定义的线程池,监听参数变化去动态调整参数。

67.线程池调优了解吗?(补充)
2024 年 03 月 16 日增补,推荐阅读:Java 线程池实现原理及其在美团业务中的实践
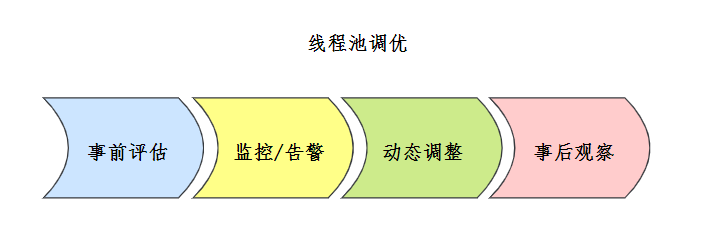
首先我会根据任务类型设置核心线程数参数,比如 IO 密集型任务会设置为 CPU 核心数*2 的经验值。
其次我会结合线程池动态调整的能力,在流量波动时通过 setCorePoolSize 平滑扩容,或者直接使用 DynamicTp 实现线程池参数的自动化调整。
最后,我会通过内置的监控指标建立容量预警机制。比如通过 JMX 监控线程池的运行状态,设置阈值,当线程池的任务队列长度超过阈值时,触发告警。
68.线程池在使用的时候需要注意什么?(补充)
2024 年 03 月 16 日增补
我认为有 3 个比较重要的关注点:
第一个,选择合适的线程池大小。过小的线程池可能会导致任务一直在排队;过大的线程池可能会导致大家都在竞争 CPU 资源,增加上下文切换的开销
第二个,选择合适的任务队列。使用有界队列可以避免资源耗尽的风险,但是可能会导致任务被拒绝;使用无界队列虽然可以避免任务被拒绝,但是可能会导致内存耗尽
比如在使用 LinkedBlockingQueue 的时候,可以传入参数来限制队列中任务的数量,这样就不会出现 OOM。
第三个,尽量使用自定义的线程池,而不是使用 Executors 创建的线程池。
因为 newFixedThreadPool 线程池由于使用了 LinkedBlockingQueue,队列的容量默认无限大,任务过多时会导致内存溢出;newCachedThreadPool 线程池由于核心线程数无限大,当任务过多的时候会导致创建大量的线程,导致服务器负载过高宕机。
memo:2025 年 2 月 25 日修改至此。
69.你能设计实现一个线程池吗?
推荐阅读:三分恶线程池原理
线程池的主要目的是为了避免频繁地创建和销毁线程。
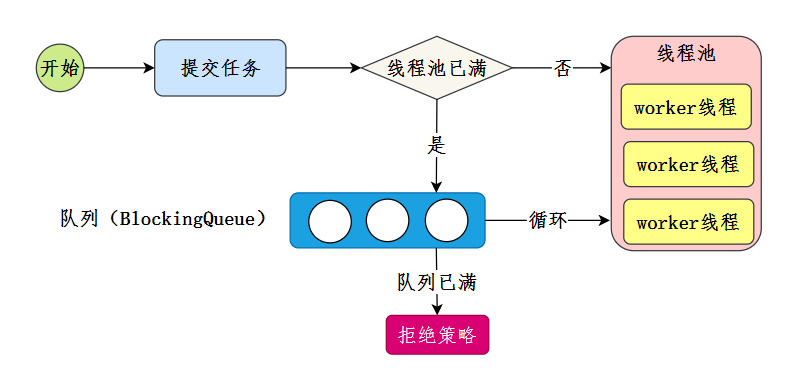
我会把线程池看作一个工厂,里面有一群“工人”,也就是线程了,专门用来做任务。
当任务来了,需要先判断有没有空闲的工人,如果有就把任务交给他们;如果没有,就把任务暂存到一个任务队列里,等工人忙完了再去处理。
如果队列满了,还没有空闲的工人,就要考虑扩容,让预备的工人过来干活,但不能超过预定的最大值,防止工厂被挤爆。
如果连扩容也没法解决,就需要一个拒绝策略,可能直接拒绝任务或者报个错。
核心线程池类(可参考):
class CustomThreadPoolExecutor {

    private final int corePoolSize;
    private final int maximumPoolSize;
    private final long keepAliveTime;
    private final TimeUnit unit;
    private final BlockingQueue<Runnable> workQueue;
    private final RejectedExecutionHandler handler;

    private volatile boolean isShutdown = false;
    private int currentPoolSize = 0;

    // 构造方法
    public CustomThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit,
                                    BlockingQueue<Runnable> workQueue, RejectedExecutionHandler handler) {
        this.corePoolSize = corePoolSize;
        this.maximumPoolSize = maximumPoolSize;
        this.keepAliveTime = keepAliveTime;
        this.unit = unit;
        this.workQueue = workQueue;
        this.handler = handler;
    }

    // 提交任务
    public void execute(Runnable task) {
        if (isShutdown) {
            throw new IllegalStateException("ThreadPool is shutdown");
        }

        synchronized (this) {
            // 如果当前线程数小于核心线程数,直接创建新线程
            if (currentPoolSize < corePoolSize) {
                new Worker(task).start();
                currentPoolSize++;
                return;
            }

            // 尝试将任务添加到队列中
            if (!workQueue.offer(task)) {
                if (currentPoolSize < maximumPoolSize) {
                    new Worker(task).start();
                    currentPoolSize++;
                } else {
                    // 调用拒绝策略
                    handler.rejectedExecution(task, null);
                }
            }
        }
    }

    // 关闭线程池
    public void shutdown() {
        isShutdown = true;
    }

    // 工作线程
    private class Worker extends Thread {
        private Runnable task;

        Worker(Runnable task) {
            this.task = task;
        }

        @Override
        public void run() {
            while (task != null || (task = getTask()) != null) {
                try {
                    task.run();
                } finally {
                    task = null;
                }
            }
        }

        // 从队列中获取任务
        private Runnable getTask() {
            try {
                return workQueue.poll(keepAliveTime, unit);
            } catch (InterruptedException e) {
                return null;
            }
        }
    }
}拒绝策略:
/**
 * 拒绝策略
 */
class CustomRejectedExecutionHandler {

    // AbortPolicy 抛出异常
    public static class AbortPolicy implements RejectedExecutionHandler {
        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            throw new RuntimeException("Task " + r.toString() + " rejected from " + e.toString());
        }
    }

    // DiscardPolicy 什么都不做
    public static class DiscardPolicy implements RejectedExecutionHandler {
        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            // Do nothing
        }
    }

    // DiscardOldestPolicy 丢弃队列中最旧的任务
    public static class CallerRunsPolicy implements RejectedExecutionHandler {
        public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
            if (!e.isShutdown()) {
                r.run();
            }
        }
    }
}使用示例:
class ThreadPoolTest {
    public static void main(String[] args) {
        // 创建线程池
        CustomThreadPoolExecutor executor = new CustomThreadPoolExecutor(
                2, 4, 10, TimeUnit.SECONDS,
                new LinkedBlockingQueue<>(2),
                new CustomRejectedExecutionHandler.AbortPolicy());

        // 提交任务
        for (int i = 0; i < 10; i++) {
            final int index = i;
            executor.execute(() -> {
                System.out.println("Task " + index + " is running");
                try {
                    Thread.sleep(2000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            });
        }

        // 关闭线程池
        executor.shutdown();
    }
}执行结果:
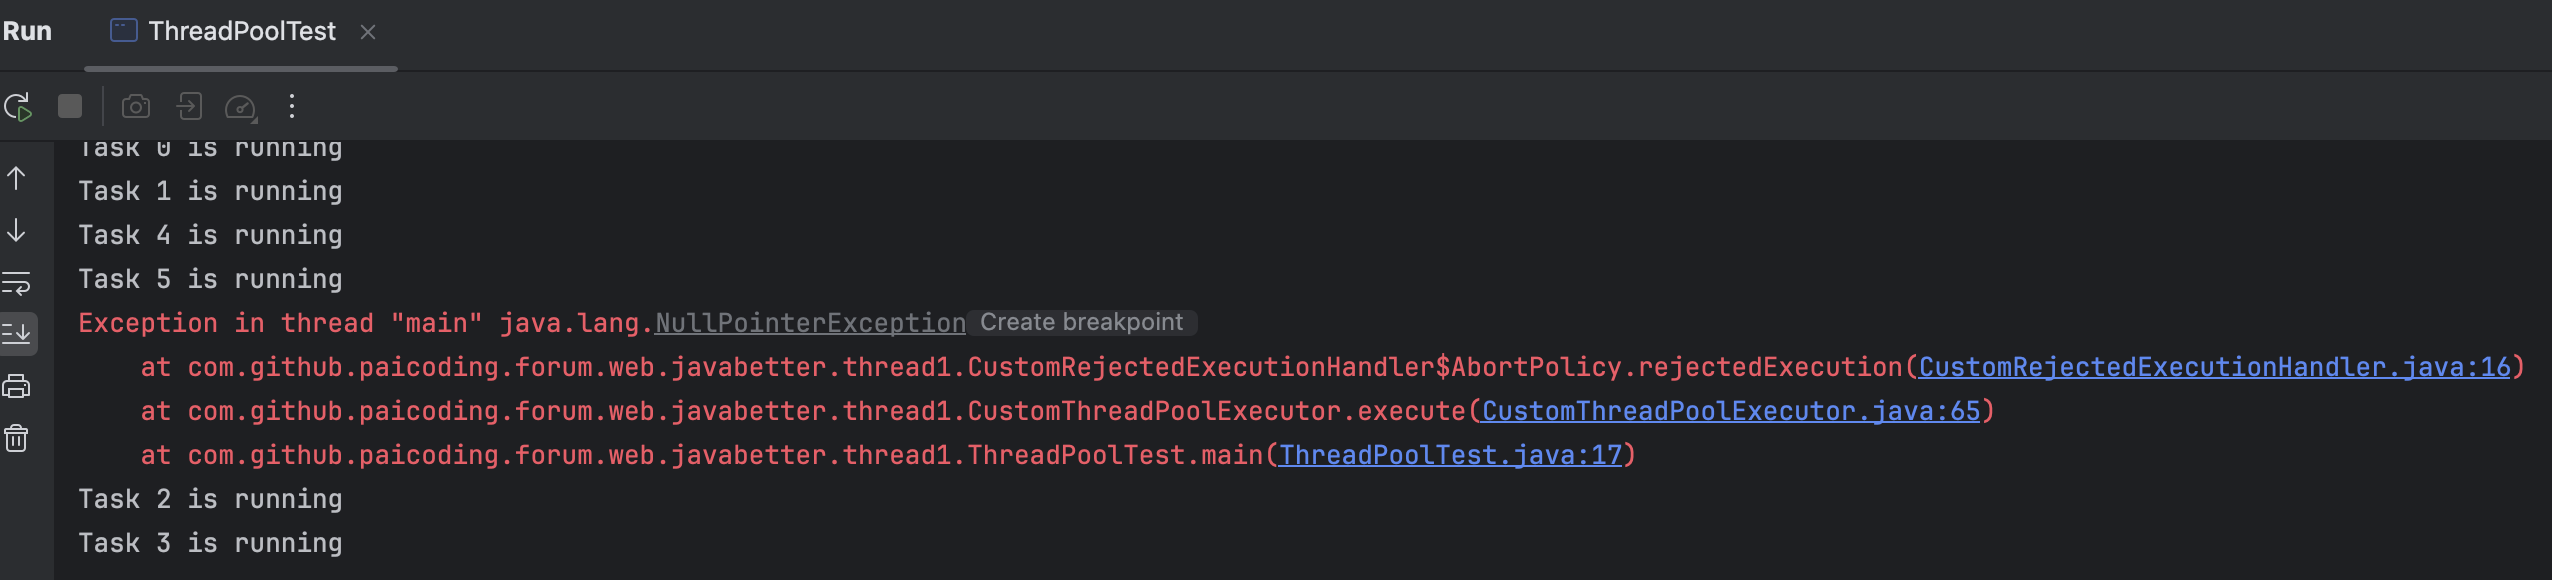
手写一个数据库连接池,可以吗?
可以的,我的思路是这样的:数据库连接池主要是为了避免每次操作数据库时都去创建连接,因为那样很浪费资源。所以我打算在初始化时预先创建好固定数量的连接,然后把它们放到一个线程安全的容器里,后续有请求的时候就从队列里拿,使用完后再归还到队列中。
class SimpleConnectionPool {
    // 配置
    private String jdbcUrl;
    private String username;
    private String password;
    private int maxConnections;
    private BlockingQueue<Connection> connectionPool;

    // 构造方法
    public SimpleConnectionPool(String jdbcUrl, String username, String password, int maxConnections) throws SQLException {
        this.jdbcUrl = jdbcUrl;
        this.username = username;
        this.password = password;
        this.maxConnections = maxConnections;
        this.connectionPool = new LinkedBlockingQueue<>(maxConnections);

        // 初始化连接池
        for (int i = 0; i < maxConnections; i++) {
            connectionPool.add(createNewConnection());
        }
    }

    // 创建新连接
    private Connection createNewConnection() throws SQLException {
        return DriverManager.getConnection(jdbcUrl, username, password);
    }

    // 获取连接
    public Connection getConnection(long timeout, TimeUnit unit) throws InterruptedException, SQLException {
        Connection connection = connectionPool.poll(timeout, unit); // 等待指定时间获取连接
        if (connection == null) {
            throw new SQLException("Timeout: Unable to acquire a connection.");
        }
        return connection;
    }

    // 归还连接
    public void releaseConnection(Connection connection) throws SQLException {
        if (connection != null) {
            if (connection.isClosed()) {
                // 如果连接已关闭,创建一个新连接补充到池中
                connectionPool.add(createNewConnection());
            } else {
                // 将连接归还到池中
                connectionPool.offer(connection);
            }
        }
    }

    // 关闭所有连接
    public void closeAllConnections() throws SQLException {
        for (Connection connection : connectionPool) {
            if (!connection.isClosed()) {
                connection.close();
            }
        }
    }

    // 测试用例
    public static void main(String[] args) {
        try {
            SimpleConnectionPool pool = new SimpleConnectionPool(
                "jdbc:mysql://localhost:3306/pai_coding", "root", "", 5
            );

            // 获取连接
            Connection conn = pool.getConnection(5, TimeUnit.SECONDS);

            // 使用连接(示例查询)
            System.out.println("Connection acquired: " + conn);
            Thread.sleep(2000); // 模拟查询

            // 归还连接
            pool.releaseConnection(conn);
            System.out.println("Connection returned.");

            // 关闭所有连接
            pool.closeAllConnections();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}运行结果:
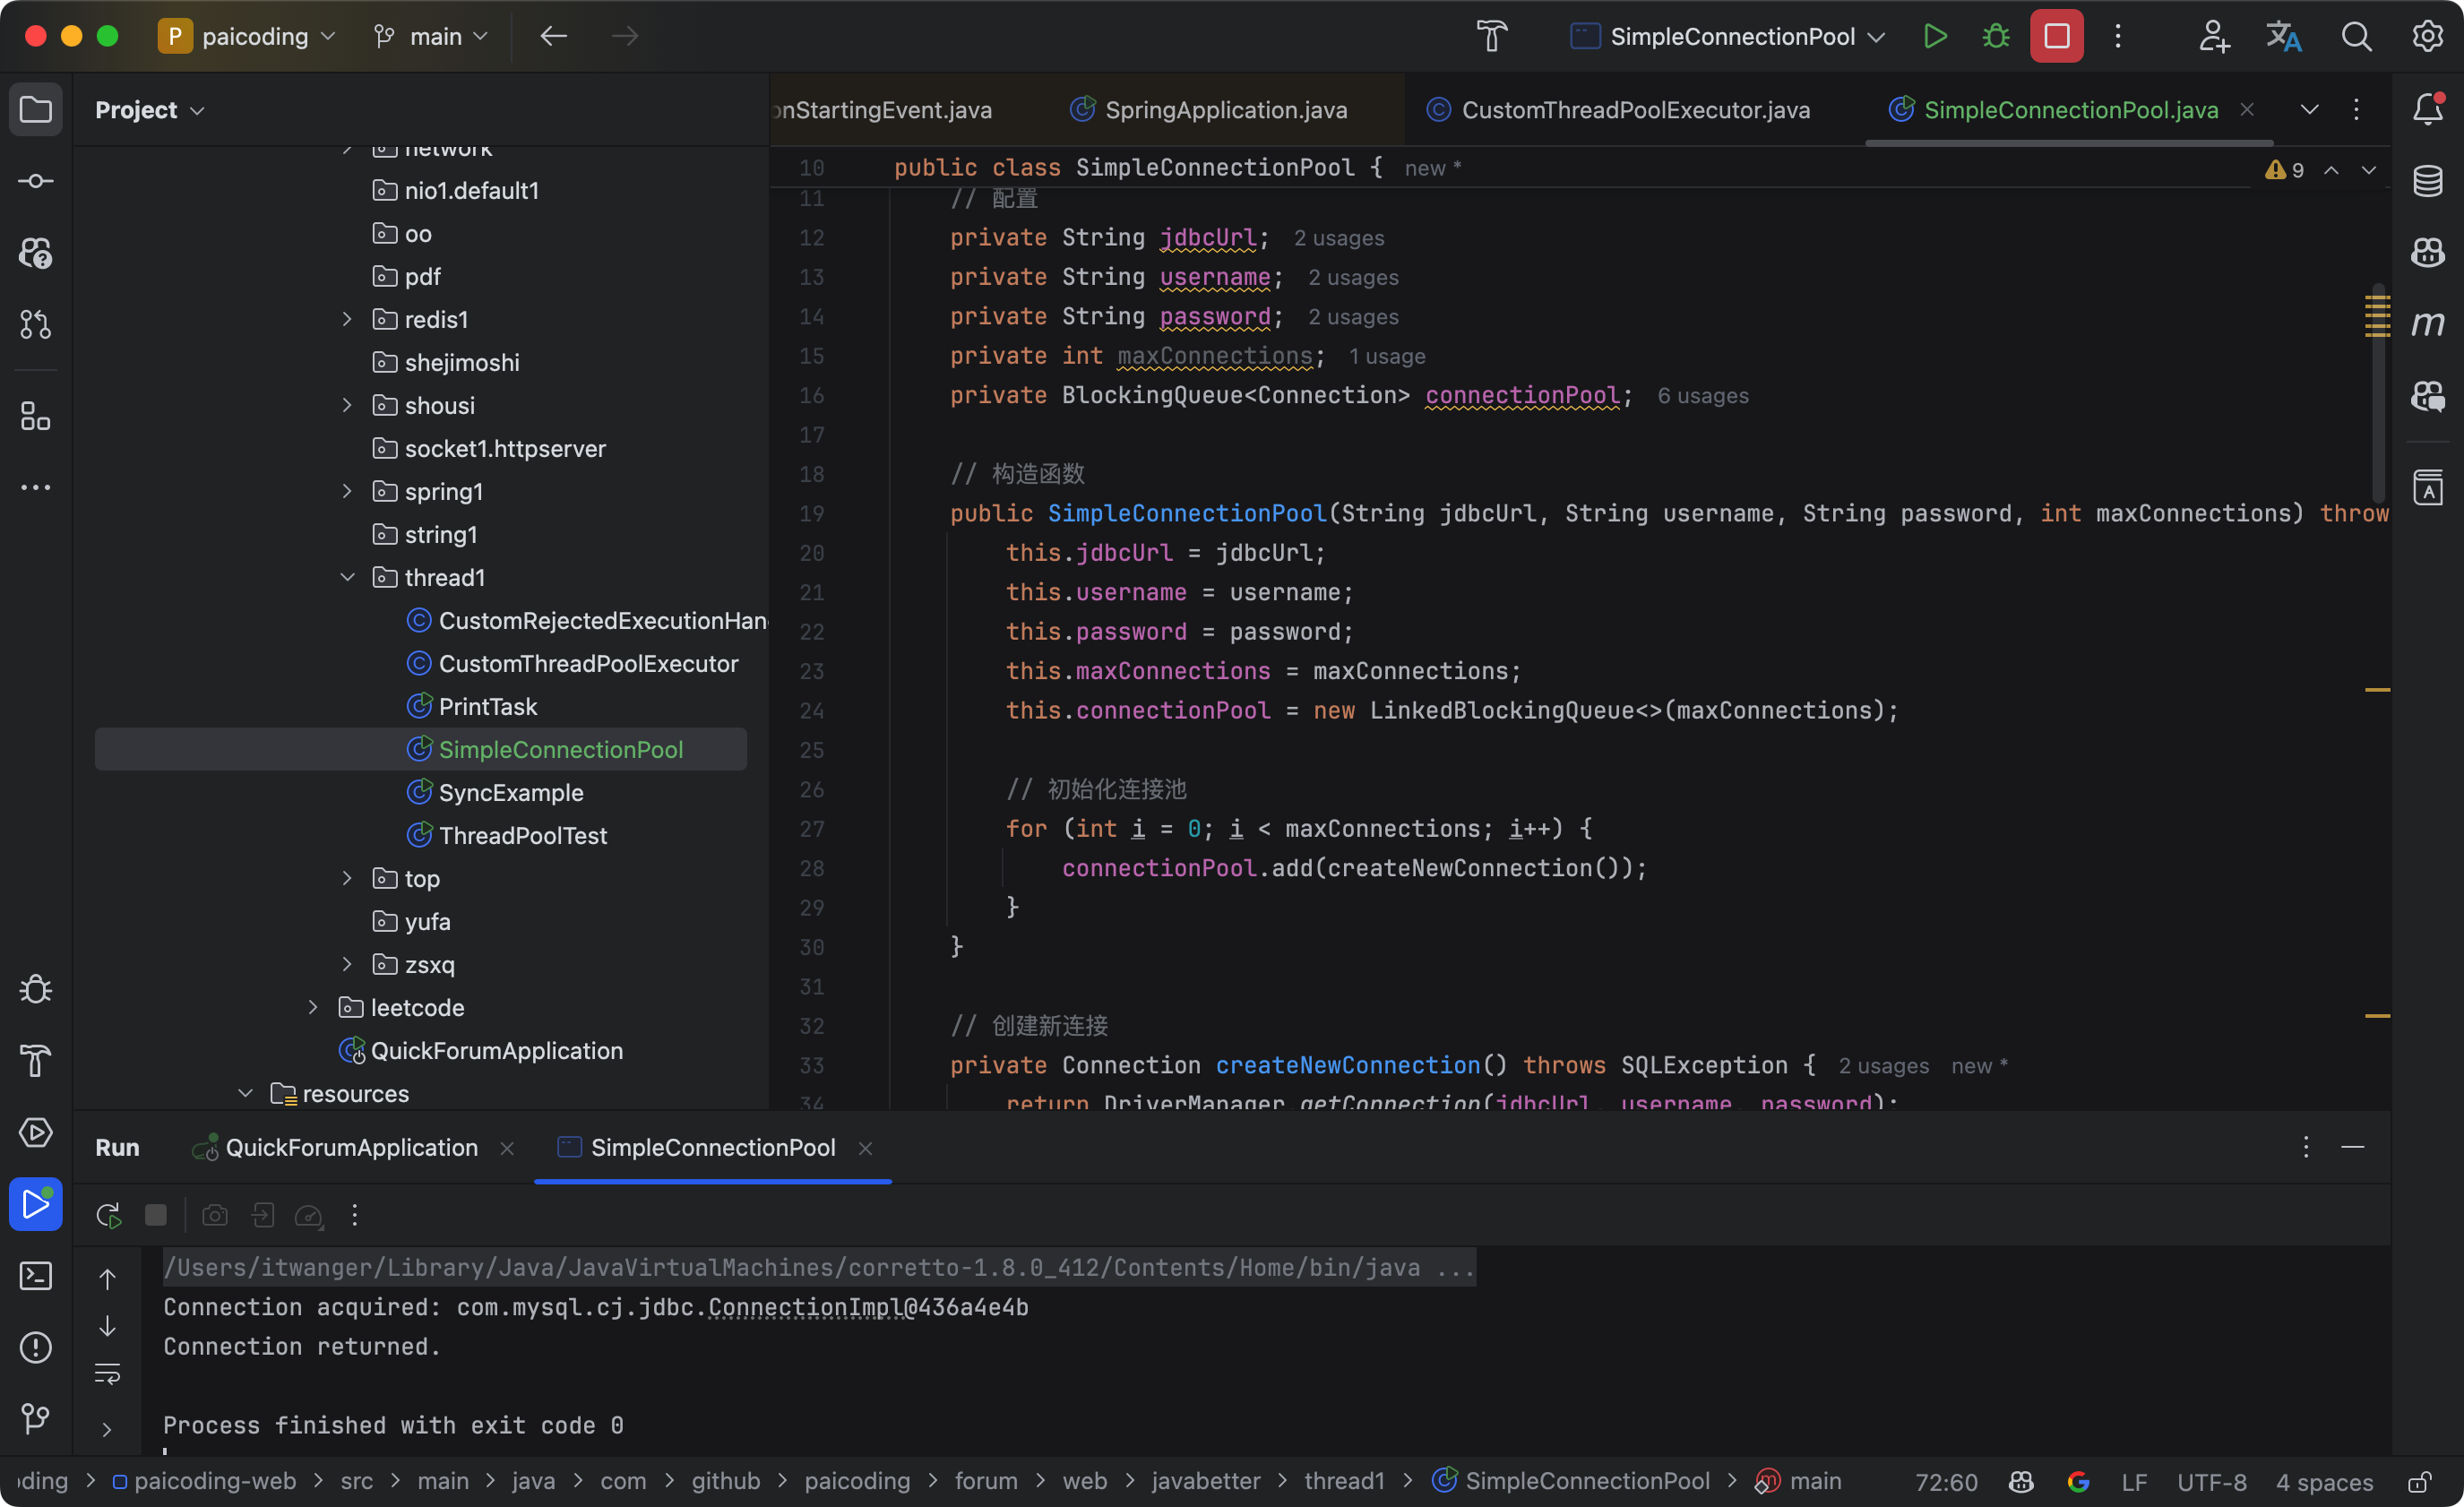
70.线程池执行中断电了应该怎么处理?
线程池本身只能在内存中进行任务调度,并不会持久化,一旦断电,线程池里的所有任务和状态都会丢失。
我会考虑以下几个方面:
第一,持久化任务。可以将任务持久化到数据库或者消息队列中,等电恢复后再重新执行。
第二,任务幂等性,需要保证任务是幂等的,也就是无论执行多少次,结果都一致。
第三,恢复策略。当系统重启时,应该有一个恢复流程:检测上次是否有未完成的任务,将这些任务重新加载到线程池中执行,确保断电前的工作能够恢复。
并发容器和框架
71.Fork/Join 框架了解吗?
关于 Fork/Join 框架,我了解一些,它是 Java 7 引入的一个并行框架,主要用于分治算法的并行执行。这个框架通过将大的任务递归地分解成小任务,然后并行执行,最后再合并结果,以达到最高效率处理大量数据的目的。
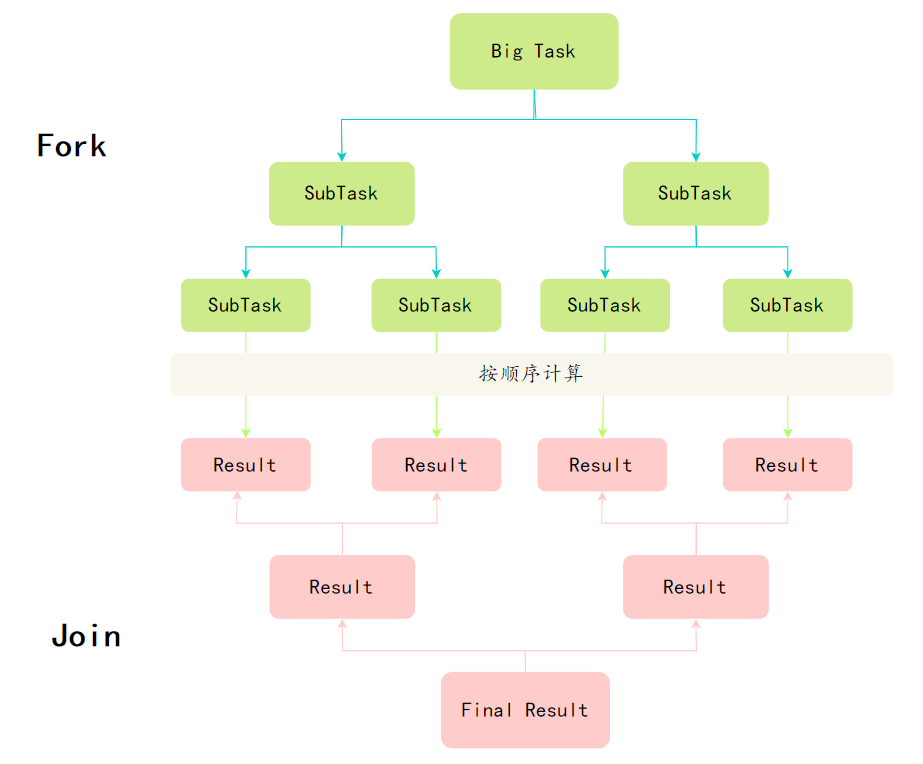
Fork/Join 框架的核心理念是分而治之,将大任务拆分为多个小任务并行处理,最后再将这些小任务的结果汇总。
就像是一个树形结构,根节点是一个大的任务,叶子节点是最小的子任务,每个任务都可能会被分裂成更小的子任务,直到达到某个临界点,任务再逐个执行。
具体来说,Fork/Join 包括两个主要的类:
ForkJoinPool,一个特殊的线程池,底层使用了工作窃取算法,也就是当一个线程执行完自己的任务后,它可以窃取其他线程的任务,避免线程闲置。
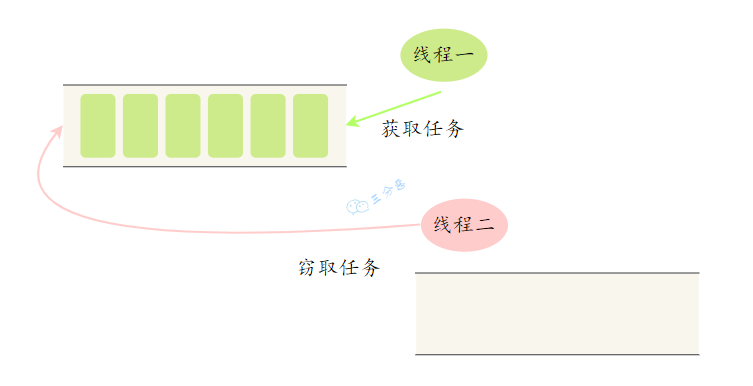
RecursiveTask 和 RecursiveAction,分别用于有返回值和无返回值的任务,这两个类都继承自 ForkJoinTask。
class ForkJoinExample {
    public static void main(String[] args) {
        int[] arr = new int[100];
        for (int i = 0; i < 100; i++) {
            arr[i] = i + 1; // 填充数据 1 到 100
        }

        // 创建 ForkJoinPool,默认使用可用的处理器核心数
        ForkJoinPool pool = new ForkJoinPool();

        // 创建 ForkJoin 任务
        SumTask task = new SumTask(arr, 0, arr.length);

        // 执行任务
        Integer result = pool.invoke(task);

        System.out.println("数组的和是: " + result);
    }

    // 自定义任务,继承 RecursiveTask
    static class SumTask extends RecursiveTask<Integer> {
        private int[] arr;
        private int start;
        private int end;

        public SumTask(int[] arr, int start, int end) {
            this.arr = arr;
            this.start = start;
            this.end = end;
        }

        @Override
        protected Integer compute() {
            if (end - start <= 10) {  // 如果任务足够小,就直接计算
                int sum = 0;
                for (int i = start; i < end; i++) {
                    sum += arr[i];
                }
                return sum;
            } else {
                // 否则拆分任务
                int mid = (start + end) / 2;
                SumTask left = new SumTask(arr, start, mid);
                SumTask right = new SumTask(arr, mid, end);

                // 分别执行子任务
                left.fork();
                right.fork();

                // 合并结果
                int leftResult = left.join();
                int rightResult = right.join();

                return leftResult + rightResult;  // 汇总结果
            }
        }
    }
}memo:2025 年 2 月 26 日修改至此。终于搞定,面渣逆袭并发编程篇终于搞定,我滴妈呀,太不容易了。